E-E-A-T چیست؛ راهنمای کامل اجرای آن در عصر هوش مصنوعی
صفحات زیادی دیدهایم که محتوای درستی دارند ولی کسی نمیداند چهکسی نوشتهاند؛ و صفحاتی که نویسنده دارد ولی هیچ مدرکی از کارش نیست. هر دو حالت یک شکست مشترک دارند: اثباتناپذیری. چارچوب E-E-A-T دقیقاً همینجا وارد میشود و بهجای شعار «محتوای خوب بنویسید»، فهرست قابل ممیزی از شواهد میدهد — چهکسی، با چه تجربهای، با چه مدرکی، با چه مسئولیتی.
این راهنما از تعریف شروع نمیکند و تمام نمیشود؛ هدف اجراست. در ادامه ممیزی عملیاتی پنجایستگاهی را میبینید که برای سایتهای فارسی — از فروشگاه و کلینیک تا رسانهٔ تخصصی — قابل اجراست، بعد نقش محتوای هوش مصنوعی و مرز شفافیت را باز میکنیم. اگر دنبال مکانیک جزئیتر استناددهی هستید، مقالهٔ جفت این راهنما همان کار را برای استناد انجام میدهد؛ اینجا چارچوب کلی اعتبار است.
E-E-A-T چیست؛ چهار جزء و یک رأس
چهار جزء را جدا کنید تا اشتباه نشوند. تجربه (Experience) یعنی نویسنده واقعاً کار را لمس کرده — کسی که عکاسی را آموزش میدهد خودش عکس میگیرد. تخصص (Expertise) یعنی دانش فنی و عمق موضوعی، با مدرک یا سابقهٔ قابل اثبات. اعتبار (Authoritativeness) یعنی دیگران شما را مرجع بدانند — رسانهها، همکاران صنف، کاربرانی که به شما ارجاع میدهند. اطمینانپذیری (Trust) رأس مجموعه است؛ تجربه و تخصص و اعتبار در نهایت به همین میرسند: آیا کاربر و موتور جستجو میتوانند به این صفحه تکیه کنند؟
یک تصریح صادقانه لازم است: این چارچوب در ارزیابهای کیفیت Google Search Central مستند است (تاریخ گردآوری: آبان ۱۴۰۵)، اما کلید یا تگی نیست که فعالش کنید و فردا رتبه بگیرید. گوگل آن را زبان مشترک سنجش کیفیت میداند؛ شما آن را بهعنوان چکلیست معماری اعتماد میخوانید. تفاوت نگاه، مسیر اجرا را عوض میکند: بهجای شکار ترفند، شواهد میسازید — و شواهد ماندنیاند.
چرا در عصر هوش مصنوعی وزن این چارچوب بیشتر شده؟
وقتی تولید متن ارزان شد، متن بودجهای دیگر مزیتی نیست. مدلهای زبانی میتوانند برای هر موضوع هزار کلمهٔ بیغلط تولید کنند؛ چیزی که تولید نمیکنند، تجربهٔ واقعی و مسئولیتپذیری است. نتیجه طبیعی است: در محیطی که همه متن دارند، تمایز به سمت شواهد میرود — عکس از کار واقعی، نتیجهٔ اندازهگیریشده، اعتراف به محدودیت، و نویسندهای که اسم و سابقه دارد. همین جابهجایی است که وزن چارچوب اعتبار را در عصر هوش مصنوعی سنگینتر میکند.
گوگل هم در توضیح آپدیتهای هستهای موضع ثابتی دارد: این آپدیتها روی داشبورد وضعیت جستجو اعلام میشوند، راهحل اختصاصی برای هر تغییر نیست و تمرکز باید روی کیفیت کلی محتوا باشد؛ بازهٔ بازگشت رتبه هم میتواند ماهها طول بکشد (تاریخ گردآوری: آبان ۱۴۰۵). ترجمهٔ عملی برای تیم محتوا: هر بار صفحهٔ کیفیت گوگل تکان میخورد، سایتهایی زخم میخورند که شواهدشان نازک بود. ممیزی منظم اعتبار، بیمهٔ همهٔ این تکانهاست — ارزانتر از هر ریکاوری.
یک لایهٔ دیگر هم هست که معمولاً فراموش میشود: کاربر هم ارزیاب است. سیگنالهای رفتاری — بازگشت سریع به نتایج، نبود تماس، نبود خرید — همان چیزی است که ممیزی اعتبار میخواهد جلویش را بگیرد. وقتی خواننده نویسنده را میشناسد و شواهد را میبیند، در صفحه میماند، جلوتر میرود و برمیگردد؛ وقتی متن را بیچهره میبیند، رفتارش همان چیزی میشود که برای موتور جستجو یعنی «این جواب نبود». پس این چارچوب دو مخاطب دارد و هر دو یک زبان میفهمند: مدرک. به تجربهٔ ما سایتهایی که فقط برای موتور جستجو اعتبار میسازند، نصف ماجرا را خرج میکنند و نصفش را نمیبرند.
ممیزی عملیاتی E-E-A-T در پنج ایستگاه
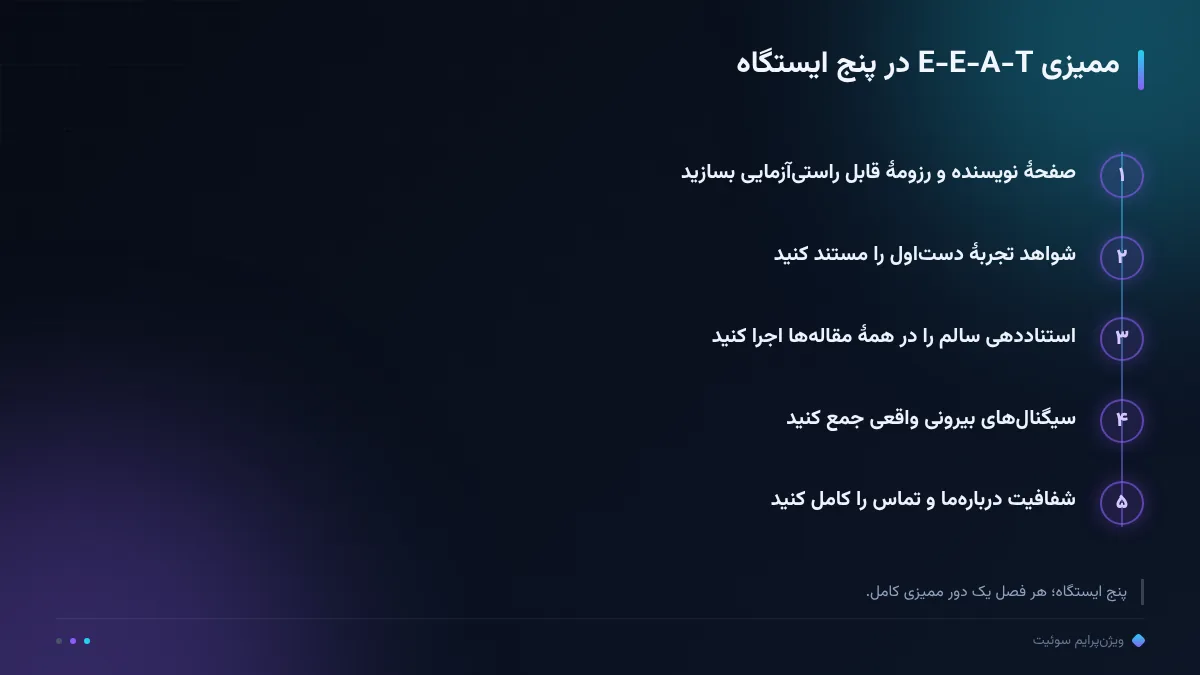
ایستگاه اول، صفحهٔ نویسنده است: نام واقعی، رزومهٔ قابل راستیآزمایی، حوزهٔ تخصص مشخص و لینک به پروفایلهای حرفهای. مقالهٔ بینام در حوزهٔ حساس، سقف اعتبارش از روز اول کوتاه است. ایستگاه دوم، شواهد تجربهٔ دستاول است: تصویر و ویدیو از کار واقعی، مراحل اجرا، نتیجهٔ خودتان با بازهٔ اندازهگیری روشن. ایستگاه سوم، استناددهی سالم است؛ قاعدهٔ ما ساده است: ادعای وامگرفته مبدأ و تاریخ دارد، ادعای بومی مستند. جزئیات پنجقدمی آن در آموزش گامبهگام استناددهی در محتوا آمده و اینجا تکرار نمیکنیم.
ایستگاه چهارم، سیگنالهای بیرونی واقعی است: پروفایل کامل کسبوکار، نظرات واقعی مشتریان با ریتم پیوسته، حضور در رسانههای تخصصی صنف — نه خرید لینک و ریپورتاژ انبوه؛ الگوی رشد اعتبار بدون خرید در مطالعهٔ موردی سوئیت مستند شده است. ایستگاه پنجم، شفافیت ساختاری است: صفحهٔ دربارهمای صادقانه، مسیر تماس واقعی، سیاستهای روشن. پنج ایستگاه را هر فصل یکبار ممیزی کنید؛ به تجربهٔ ما سه ماه ریتم کافی است تا پایهها سرجایشان بنشینند، بعد فقط نگهداری است.
تجربهٔ دستاول را چطور نشان دهیم؟
تجربهٔ دستاول با حرف ساخته نمیشود؛ با سند ساخته میشود. ملموسترین شواهد از ارزانترینها شروع میشوند: تصویر واقعی از پروژه در جریان، اسکرینشات گزارش خودتان با تاریخ، ویدیوی کوتاه از فرایند کار، نمونهٔ قبل و بعد با توضیح اینکه چه چیزی را تغییر دادید. قاعدهٔ ما در کارگاه محتواست: هر «به تجربهٔ ما» که مینویسید، باید پشتوانهای در صفحه یا در مقالهٔ مرتبط داشته باشد؛ وگرنه همان جمله را حذف کنید. خوانندهٔ امروز تفاوت تجربهٔ مستندشده و ادعای نوشتاری را سریع میبوید.
صادق بودن با محدودیتها هم بخشی از سند است. کیسی که همهچیز را موفق نشان دهد باور نمیشود؛ همان کیس با یک جملهٔ «این نتیجه در این بازه و با این شرایط بود» اعتماد میسازد. برای همین در گزارشهای خودمان بازهٔ اندازهگیری و محدودیتها را کنار اعداد میگذاریم. اگر دنبال الگوی عملی هستید، مطالعهٔ موردی رشد اعتبار بدون ریپورتاژ نشان میدهد چطور با مستندسازی و ریتم، بدون خرید اعتبار، به سیگنالهای قابل اندازهگیری رسیدیم.
YMYL و استاندارد سختتر در بازار فارسی
حوزههایی که سلامت، مالی یا حقوقی مخاطب را مستقیم لمس میکنند، در ادبیات گوگل YMYL نامیده میشوند و استاندارد تریج سختتری برایشان میخواهند. در بازار فارسی این فهرست وسیع است: کلینیک و درمان، مکمل و زیبایی، خدمات مالی و سرمایهگذاری، وکالت و مشاورهٔ حقوقی، بیمه. در این حوزهها صفحهٔ بینویسنده، بیمدرک و بیآدرس عملاً خودش را حذف میکند؛ بار اثبات روی سایت است، نه روی خواننده.
در عمل سه سیگنال اولویت دارند. نام، مدرک و شمارهٔ پروانهٔ نویسندهٔ متخصص روی محتوای حساس؛ نه «تیم محتوای ما»، بلکه پزشک، وکیل یا کارشناس با سابقهٔ قابل راستیآزمایی. مرز ادعا: در حوزهٔ درمان و مالی، وعدهٔ نتیجه را از توضیح فرایند جدا کنید و هرجا تشخیص فردی است، صریح بگویید مراجعه لازم است. و هویت ساختاری: آدرس واقعی، مسیر تماس و صفحهٔ دربارهمای کامل. به تجربهٔ ما در ممیزیهای حوزهٔ درمان، بیشترین شکاف اعتبار همین سه مورد است — و هر سه با کار داخلی قابل حلاند، نه با بودجهٔ لینک.
برای اینکه تفاوت استاندارد ملموس شود، دو نمونهٔ فرضی را کنار هم بگذارید. یک مقالهٔ «فواید پیادهروی روزانه» بدون نویسنده شاید بگذرد؛ همان مقاله با عنوان «برنامهٔ پیادهروی بعد از عمل زانو» بینام و بیپروانه از ردیف حذف میشود، چون وارد قلمرو سلامت شده و بار اثبات سنگین میشود. یا یک مقایسهٔ «صندوق سرمایهگذاری چیست» در برابر «کارمزد خرید و فروش صندوق چقدر است»؛ دومی پول مستقیم مخاطب را لمس میکند و بدون نام کارشناس و مرز ریسک، اعتماد نمیسازد. قاعدهٔ عملی: هر وقت موضوع از «اطلاعات عمومی» به «تصمیم فردی» نزدیک شد، استاندارد استناد و هویت را یک پله سختگیرانه کنید.
محتوای هوش مصنوعی و E-E-A-T؛ شفافیت و گیت کیفیت
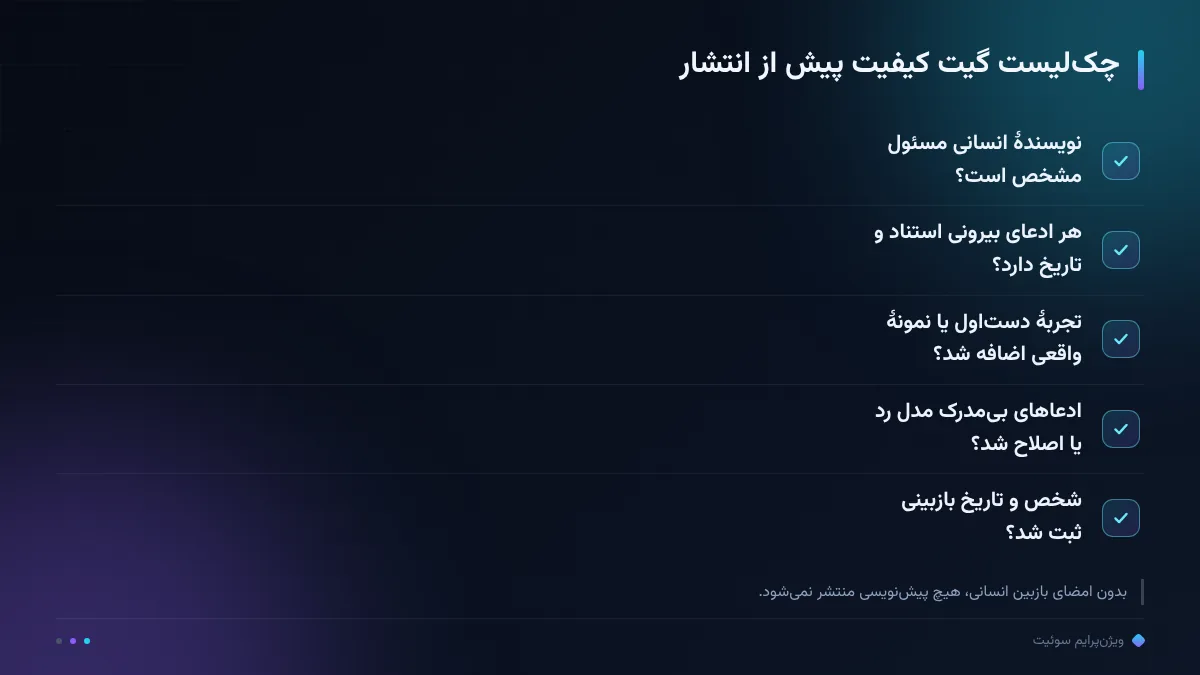
محتوای کمکی هوش مصنوعی خودش مشکل نیست؛ بیمسئولی است که مشکل میکند. خط قرمز ما شفافیت و گیت است: اگر پیشنویس با کمک مدل تولید شده، این موضوع لازم نیست با صدای بلند در مقاله بنویسید، اما لازم است واقعیت باشد — یعنی یک نویسندهٔ انسانی مسئول مشخص وجود داشته باشد که ادعاها را وارسی، تجربهٔ دستاول را اضافه و نسخهٔ نهایی را امضا کند. پنهانکاری عکسش را هم دارد: محتوای منتشرشده به نام برند شماست و در ممیزی اعتبار، بیمسئول بودن متن دقیقاً همان چیزی است که پیدا میشود.
در عمل، گیت کیفیت یعنی هیچ پیشنویسی بدون پنج چک منتشر نمیشود: مسئول مشخص، استناد و تاریخ برای ادعاهای بیرونی، تجربه یا نمونهٔ واقعی تزریقشده، رد یا اصلاح ادعاهای بیمدرک مدل، و ثبت شخص و تاریخ بازبینی. این همان فلسفهٔ گیت کیفیت در چرخهٔ تولید ماست و جزئیات چگونهگی آن در بازبینی محتوای هوش مصنوعی پیش از انتشار باز شده است. خلاصهاش یک جمله است: ابزار متن تولید میکند، اعتبار را انسان امضا میکند.
جمعبندی؛ اعتبار ساختنی است، نه ادعاکردنی
جمع ببندیم: E-E-A-T چهار جزء دارد و یک رأس — اطمینانپذیری — و در عمل به پنج ایستگاه ترجمه میشود: نویسنده، شواهد تجربه، استناددهی، سیگنالهای بیرونی و شفافیت. هیچکدام با یک تگ یا یک خرید یکشبه به دست نمیآید؛ ریتم فصلی ممیزی میخواهد. در حوزههای YMYL بازار فارسی این ریتم شرط بقا است و در بقیه حوزهها مزیت رقابتی — چون شواهد، تنها چیزی است که با تولید انبوه متن ارزان نمیشود.
برای شروع، صفحهٔ نویسنده و شواهد تجربه را همین هفته راه بیندازید — ارزانترین دو ایستگاهاند. برای ممیزی وضعیت فعلی دامنه، ممیزی رایگان دامنه نقطهٔ ورود ماست و معرفی ویژنپرایم سوئیت نشان میدهد ممیزی و تولید محتوای دارای گیت در یک چرخهٔ واحد چطور کنار هم میآیند. به تجربهٔ ما تیمی که اعتبار را پروژهٔ ساختاری میبیند، بعد از هر تکان بازار نه از صفر، بلکه از نیمهٔ راه شروع میکند. همین هفته یک ایستگاه را انتخاب کنید و سند اولش را بنویسید؛ اعتبار از همان یک برگه شروع میشود. و برای ادامهٔ مسیر، هاب سئو و هوش مصنوعی مقالههای همخانوادهٔ این موضوع را کنار هم گذاشته است.
رصد ما، رشد شما.
سؤالات پرتکرار
آیا E-E-A-T فاکتور مستقیم رتبهگرفتن است؟
گوگل آن را چارچوب ارزیابی کیفیت میداند، نه کلیدی که با تگ فعال شود؛ در عمل یعنی ساخت شواهد اعتماد، نه شکار ترفند. اثرش از مسیر کیفیت درمیآید.
برای سایتهای کوچک از کدام ایستگاه شروع کنیم؟
از صفحهٔ نویسنده و شواهد تجربهٔ دستاول؛ ارزانترین و اثرگذارترین شروع است و بدون بودجهٔ لینک هم قابل اجراست.
محتوای کمکی هوش مصنوعی با این چارچوب تناقض دارد؟
نه؛ شرطش شفافیت و گیت انسانی است. متن بیمسئول و بیتجربه مشکل است، نه ابزار تولید پیشنویس. امضای بازبین انسانی مرز را تعیین میکند.
ممیزی پنجایستگاهی را چهقدر یکبار تکرار کنیم؟
فصلی برای هر پنج ایستگاه؛ و بعد از هر آپدیت هستهای بزرگ، ایستگاه استناددهی و شفافیت را اول از همه مرور کنید.