خطر اتکا به هوش مصنوعی؛ چرا اتکای کامل به AI نتیجه نمیدهد؟ علتهای پنهان
الگوی تکرارشوندهای که در ممیزیهایمان میبینیم ثابت است: تیمی ابزارهای مولد را کشف میکند، ماهِ اول شادمانی است چون خروجی چند برابر شده، و در فصل دوم یا سوم نمودارها تخت میشوند و کسی نمیداند چرا. ابزار بد نبوده؛ نسبت تیم با ابزار خراب بوده است. انتظارِ «دکمهٔ محتوا» جای «دستیار پیشنویس» نشسته و دقیقاً همینجاست که نتیجه متوقف میشود.
اگر پرسش شما آیندهٔ خودِ سئو در عصر AI است، در آیا سئو با AI میمیرد جداگانه گفتهایم که سئو نمیمیرد؛ توزیع دیدهشدن عوض میشود. این مقاله سمت دیگر همان سکه است: نه موتور جستجو، بلکه ریسکی که در اتاق محتوای خودتان میسازید. زمینهٔ کامل این خانواده در هاب سئو و هوش مصنوعی و روشهای اجرای آن در صفحات همخانواده آمده است.
خطر اتکا به هوش مصنوعی دقیقاً کجاست؟
خطر اتکا به هوش مصنوعی در سه لایه دقیق میشود. لایهٔ اول، محتوا است: خروجی مدل از میانگین دادهها ساخته میشود، پس ذاتاً «بیخطر و شبیه بقیه» است؛ تمایزی که رتبه و کلیک میسازد، از ورودی تخصصی شما میآید و اگر وارد نشود، متنِ قابلجایگزینی تولید کردهاید. لایهٔ دوم، عملیات است: انتشار سریع، بازبینی حذفشده و خطاهای کوچکی که در حجم گم میشوند. لایهٔ سوم، مهارت است: تیمی که فقط چک میکند و نمینویسد، بهتدریج تمرینِ قضاوت را از دست میدهد.
این سه لایه همزمان کار میکنند و به همین دلیل نتیجه یکمرحلهای فرو نمیریزد؛ آرام تخت میشود. نشانههایش زودتر از افت ترافیک ظاهر میشوند: مقالههایی که در مقایسه با رقبا قابل تفکیک نیستند، ادعاهای بدون منبع، لحنی که هر چهار مقالهٔ اخیر شما را شبیه هم نوشته است. ممیزی رایگان دامنه همین نشانهها را در سطح سایت نشان میدهد تا پیش از فصلِ تخت، نسبت تیم با ابزار را اصلاح کنید.
علت پنهان اول: محتوای همشکل و تمایز ازدسترفته
مدل زبانی از توزیع احتمال کلمهها پاسخ میسازد؛ یعنی بهطور طبیعی به میانهٔ آنچه نوشته شده نزدیک میشود. برای پرسشهای عمومی این مزیت است، ولی برای رقابت محتوا یک تله است: وقتی همهٔ سایتهای یک موضوع از مدلهای همخانواده با پرامپتهای مشابه استفاده کنند، خروجیها از یک سقف عبور نمیکنند و خوانندهای که دو سه صفحه را مقایسه کرده باشد، هیچ فرقی حس نمیکند. رتبهگرفتن در چنین سری، به امضایی نیاز دارد که مدل از خودش ندارد.
امضا از سه ورودی میآید که فقط شما دارید: داده و تجربهٔ مستند خودتان (کیس، گزارش، عدد داخلی)، مثالهای بومی بازار ایران و قضاوت صریح دربارهٔ معادلات همان صنعت. به تجربهٔ ما یک پاراگراف دادهٔ واقعی، ارزش کل متنِ تمیز ماشینی را دارد؛ چون همان بخش است که در هیچ پایگاه دادهای تکرار نشده. راهحل عملی: پیش از تولید، فهرست ورودیهای تخصصی هر مقاله را بنویسید و تولید بدون آن فهرست را ممنوع کنید؛ این کار کمتر از ده دقیقه وقت میبرد و تمایزِ مقاله را از ابتدا به داخل متن قفل میکند.
علت پنهان دوم: خطاهای خاموشی که کسی نمیبیند
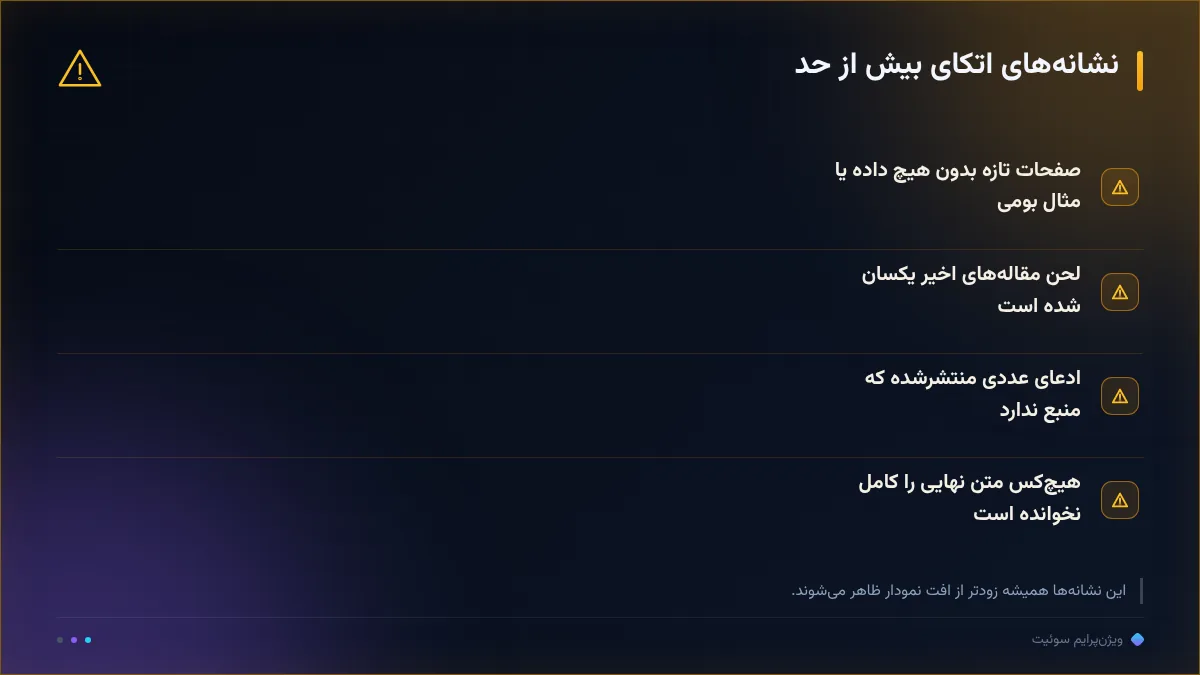
خطای خاموش، خطایی است که انتشار را رد نمیکند: حذف نیمفاصله از نام برند فارسی، نام غلط محصول، عددی که مدل «به احتمال» ساخته، تاریخ جابهجاشده، ادعایی که به هیچ منبعی وصل نیست. در تولید انسانی همین خطاها هم هست، اما نویسنده متن را کامل خوانده و ممکن است بگیردشان؛ در جریان «تولید در چند دقیقه»، کسی متن را کامل نمیخواند و هر خطا یک چراغ خاموش است که روشن نمیشود.
پیچیدگی اصلی اینجاست که بازخورد دیر میرسد: خطا منتشر میشود، هفتهها بعد یک مشتری تلفن میزند یا در نظرات مینویسد و اعتماد، جنسش یکطرفه است — ساختنش ماهها طول میکشد و خرابکردنش یک خطای تکرارشده کافی است. برای همین در تیمهایی که با AI کار میکنند، نمونهبرداری هفتگی باید قانون باشد: از هر محمولهٔ انتشار، دو سه مقاله را کامل بخوانید، هر ادعای عددی را منبعچک کنید و نتایج را برای کل تیم شفاف ثبت کنید؛ الگوی خطا معمولاً در همان نمونههای کوچک ظاهر میشود.
علت پنهان سوم: فرسایش مهارت و وابستگی تیم
مهارت نوشتن، مثل هر مهارتی با تمرین زنده نگه داشته میشود. تیمی که ماهها فقط پرامپت مینویسد و متن نهایی را «تأیید» میکند، بهتدریج استدلالبندی، بریدنِ حاشیه و قضاوت کیفیت را کمتمرین میکند. تا وقتی ابزار در دسترس و خروجیاش قابل قبول است، هیچکس این را حس نمیکند؛ روزی که مدل در دسترس نباشد یا بازار به صدای متمایز نیاز پیدا کند، تیمِ بیتمرین وسط میدان میماند و هزینهٔ آن روز، چند برابر صرفهجویی ماههای قبل است.
دو تمرین کوچک این ریسک را مهار میکند. اول، تمرین بدون ابزار: ماهی یکبار، یک مقاله یا بخش مهم را دستی بنویسید و بعد با خروجی مدل مقایسه کنید؛ تفاوت، نقشهٔ تمرین بعدی تیم است. دوم، نقد مقایسهای: دو نسخه از یک موضوع — انسانی و ماشینی — را جلوی تیم باز کنید و بپرسید چرا یکی بهتر است؛ پاسخدادن به این پرسش، دقیقاً همان مهارت قضاوت است که قرار است بماند. مرز اینکه کجا مدل کافی است و کجا نویسنده لازم است، در هوش مصنوعی یا نویسنده مفصل باز شده و همین مرز، سیاست استخدام و تولید شما را تعیین میکند.
علت پنهان چهارم: مقیاسشدن خطا در سرعت بالا
خطا در تولید انسانی دهتاست؛ در تولید ماشینی هزارتا. وقتی هزینهٔ تولید تقریباً صفر میشود، وسوسهٔ «همهچیز را منتشر کنیم» طبیعی است، اما صفحات نازک و تکراری که از این سرریز بیرون میآیند، در گزارش پوشش سرچکنسول جمع میشوند و سهم خاکستریِ صفحاتِ بدون ایندکس بالا میرود؛ اعتبار دامنه هم همانجا آرام فرسایش پیدا میکند. بدتر اینکه حذف بعدی، پرهزینهتر از تولید است: هر صفحهٔ بیکیفیت که ایندکس شده باشد، یک دعوای تازه برای پاکسازی است.
قاعدهٔ ما ساده و سختگیرانه است: سرعت انتشار هرگز از سرعت بازبینی جلوتر نمیرود. اگر گیت کیفیت روزانه فقط ده صفحه را تأیید میکند، همان ده صفحه منتشر میشود؛ بقیه در صف میمانند. این قاعده در ظاهر تولید را کند نشان میدهد، اما در عمل همان چیزی است که مقیاسشدن خطا را قطع میکند. به تجربهٔ ما سایتهایی که این قاعده را زود گذاشتند، از موج پاکسازی بزرگتر که تیمهای پرتولید را بعداً گرفت، بیرون ماندند.
مرز سالم؛ AI مکمل با گیت بازبینی انسانی
مرز سالم، استفادهٔ مکملی است: مدل پیشنویس میسازد، ساختار میدهد، خلاصه و بازنویسی میکند و در ایدهپردازی شریک میشود؛ اما حقیقتسنجی، مثال بومی، قضاوت نهایی و مسئولیت انتشار انسانی میماند. سهمبندیِ تقریبی ما: تا حدود هفتاد درصد مسیر برای ماشین و سی درصد آخر برای انسان؛ همان سی درصد است که متن را از «شبیه بازار» به «مال شما» تبدیل میکند و کوتاهکردنش، جایی است که نتیجه متوقف میشود.
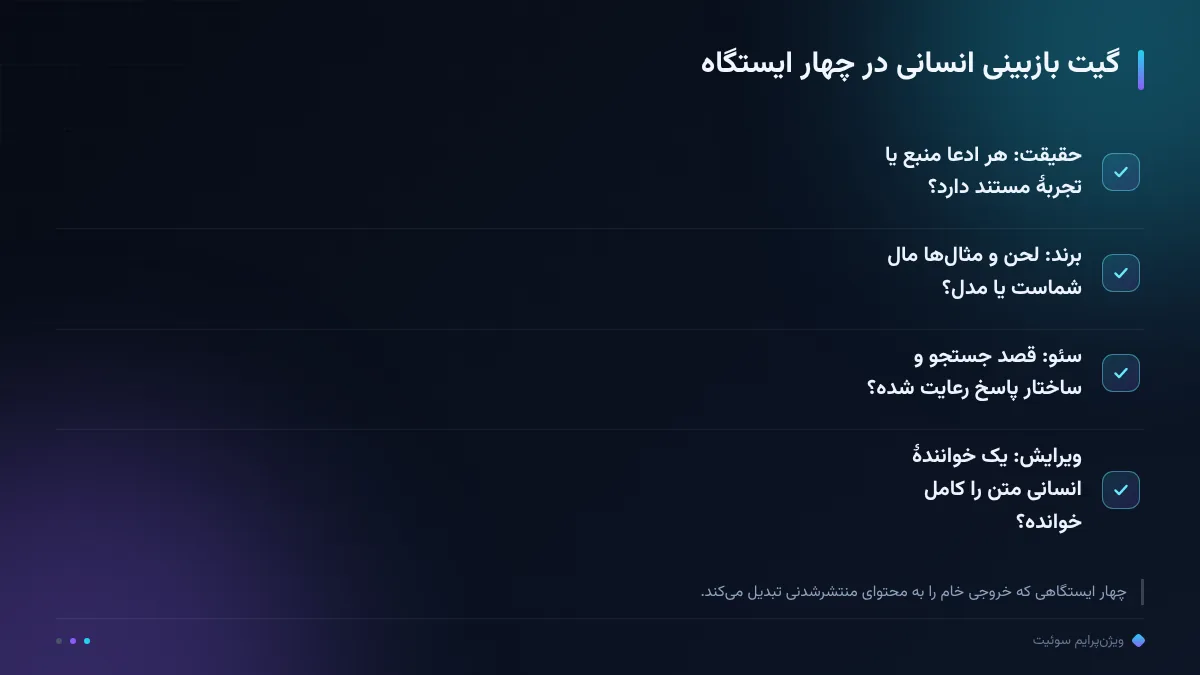
برای اینکه این مرز روی کاغذ نماند، یک ایستگاه بازبینی اجباری با چکلیست کوتاه بگذارید: حقیقت، برند، سئو، ویرایش. تولیدِ بدون تیکِ کامل این چهار خانه منتشر نمیشود، حتی اگر مقالهٔ مشتری فردا صبح بخواهد. جزئیات اجرای همین ایستگاهها را در بازبینی محتوای هوش مصنوعی نوشتهایم و در جریان تولید ما هم، خروجیها پیش از انتشار از گیت کیفیت و بازبینی انسانی رد میشوند تا محتوای استاندارد باشد، نه AI خام. این گیت حجیم نیست؛ چهار خانه که هرکدام چند دقیقه میبرد و نتیجهاش، اعتمادِ قابل انباشت است.
جمعبندی؛ ابزار را نگه دارید، نسبت را عوض کنید
جمعبندی: ابزار را نگه دارید، نسبت را عوض کنید. چهار علت پنهانِ بینتیجگی را مرور کنید — محتوای همشکل، خطای خاموش، فرسایش مهارت، مقیاس خطا — و برای هر کدام یک توقف مشخص بگذارید: فهرست ورودی تخصصی پیش از تولید، نمونهبرداری هفتگی، تمرین بدون ابزار و قاعدهٔ «انتشار هرگز از بازبینی جلوتر نمیرود». همین چهار توقف، تفاوت تیمهایی است که با AI رشد میکنند با تیمهایی که فقط سریعتر تولید میکنند.
اگر میخواهید این ساختار روی تولیدِ سایت شما اجرا شود، معرفی پلنهای ویژنپرایم سوئیت همان ترکیب را ماهانه اجرا میکند: ممیزی، تولید با گیت و انتشار پایششده. به تجربهٔ ما تیمهایی که گیت را هزینه دیدند، دوباره هزینه را در پاکسازی پرداخت کردند؛ تیمهایی که گیت را سرمایه دیدند، در فصل سوم از رقبا فاصله گرفتند. برای شروع همین هفته دو کار کوچک کافی است: چکلیست چهارخانه را جلوی چشم تیم بچسبانید و نمونهبرداری هفتگی را در تقویم ثابت کنید؛ گیتهای بزرگ با همین قدمهای کوچک شکل میگیرند و تفاوتشان تا فصل بعد در گزارشها دیده میشود.
رصد ما، رشد شما.
سؤالات پرتکرار
آیا استفاده از AI برای تولید محتوا اشتباه است؟
نه؛ اشتباه، اتکای کامل به خروجی خام آن است. به تجربهٔ ما ترکیب پیشنویس ماشینی با گیت بازبینی انسانی هم سرعت میدهد و هم کیفیت را نگه میدارد.
چرا محتوای AI از یک حدی بالاتر نمیرود؟
چون مدل از میانگین دادهها پاسخ میسازد و خروجیاش بیخطر و شبیه بقیهٔ بازار میشود؛ تمایزی که رتبه میسازد از داده و تجربهٔ تخصصی شما میآید.
چه سهمی برای AI منطقی است؟
پیشنویس، ساختار، خلاصه و بازنویسی تا حدود ۷۰ درصد مسیر؛ حقیقتسنجی، مثال بومی، قضاوت نهایی و مسئولیت انتشار باید انسانی بماند.
خطر فنی اتکای کامل چیست؟
انتشار انبوه صفحات نازک و تکراری که سهم صفحات بدون ایندکس را بالا میبرد و اعتبار دامنه را فرسایش میدهد؛ خطا هم با همان سرعت تولید، مقیاس میگیرد.
چطور بدون توقف تولید گیت بگذارم؟
یک ایستگاه بازبینی اجباری با چکلیست چهارخانه (حقیقت، برند، سئو، ویرایش) و قاعدهٔ سهمیهٔ روزانه؛ تولیدِ بدون تیک کامل این چهار خانه منتشر نمیشود.