بازبینی محتوای هوش مصنوعی؛ آموزش گامبهگام گیت انسانی پیش از انتشار
تولید متن با مدلهای زبانی ارزان و سریع شده؛ گرانتر از همیشه، قضاوت دربارهٔ درستی و بهدردبخوری آن متن است. تیمهایی که فقط سمت تولید را تقویت میکنند، بعد از چند ماه با انبوهی از مقالههای صاف و شبیه به هم روبهرو میشوند که نه ادعایشان مستند است و نه لحنشان به برند میخورد. حلقهٔ مفقوده، گیت بازبینی انسانی است؛ همان چیزی که در گیت کیفیت ۳۰ مرحلهای ما، مرحلهٔ آخر و تعیینکننده است.
این راهنما برای مدیر محتوا و نویسندهای نوشته شده که خروجی AI را منتشر میکند و میخواهد استاندارد را قربانی سرعت نکند. ریسکهای شناختهشده را فهرست میکنیم، گیت چهارایستگاهی را میچینیم و با یک روش ۴۵ دقیقهای قابل اجرا جمع میکنیم؛ زمینهٔ مقایسهٔ هزینهها را هم در هاب محتوای هوش مصنوعی با گیت کیفیت نوشتهایم.
بازبینی محتوای هوش مصنوعی چرا حلقهٔ مفقودهٔ تولید مقیاسپذیر است؟
مدل زبانی در چند ثانیه متن میسازد، ولی نمیداند متن برای کدام کسبوکار، کدام مخاطب و کدام لحظهٔ تصمیم ساخته میشود. این آگاهی در سر نویسنده و مدیر محتواست و فقط در ایستگاه بازبینی به متن تزریق میشود. به تجربهٔ ما کیفیت خروجی AI کمتر از توان مدل و بیشتر از کیفیت بازبینی پس از آن تعیین میشود؛ دو تیم با یک مدل و دو گیت متفاوت، دو بازار متفاوت میسازند. برای همین در این راهنما بهجای بحث دربارهٔ توان مدلها، روی کاری تمرکز میکنیم که در دست شماست: فرایند بازبینی.
بازبینی همچنین سپر ریسک است: ادعای نادرست، عدد بیمنبع و وعدهٔ غیرقابل تحویل، اگر به انتشار برسد، اعتباری را میسوزاند که ساختنش سالها وقت گرفته. مقیاس بدون کنترل، فقط سرعت تکرار خطا را بالا میبرد. برای همین در چرخهٔ ما تولید بدون عبور از گیت، انتشار ندارید؛ نرخ انتشار را کیفیت عبور تعیین میکند، نه حجم تولید. معیار ما ساده است: هر متن که منتشر میشود، امضای انسانی زیرش هست یا نیست؛ اگر نیست، منتشر نمیشود.
هفت ریسک همیشگی خروجی AI که باید دست بکشید
ریسکهای زیر را در هر بازبینی جستوجو کنید؛ اینها الگوهای تکرارشوندهٔ خروجی مدلهاست، نه استثنا. اول، ادعا و عدد بیمنبع: جملههای مطمئن دربارهٔ آمار یا رفتار کاربران که هیچ سندی پشتشان نیست. دوم، لحن عمومی بیمخاطب: متنی که برای همه نوشته شده و برای هیچکس. سوم، مقدمهچینی بیوعده: سه جملهٔ آغازین که هنوز موضوع را نگفتهاند و در صد کلمهٔ اول، نفع خواننده دیده نمیشود.
چهارم، تکرار و حشو: یک ایده با سه پاراگراف مختلف که حس پرشدن میدهد. پنجم، تجربهٔ ناموجود: جملاتی به سبک «ما امتحان کردهایم» که پشتشان هیچ آزمایشی نیست؛ این پنهانترین و خطرناکترین ریسک است چون ادعای تجربه میکند. ششم، ساختار هدینگ بینیت: عناوینی که سئوشدهاند ولی مسیر تصمیم خواننده را نمیسازند. هفتم، بومینشدن: مثال و ارز و رفتار بازار خارجی که برای مخاطب ایرانی غریبه است. این هفت مورد را در چکلیست بازبینی ثابت کنید؛ به تجربهٔ ما بیشترین بازنویسیها از ریسک اول و پنجم میآید و همان دو، بیشترین آسیب اعتباری را میزنند.
گیت چهارایستگاهی بازبینی انسانی
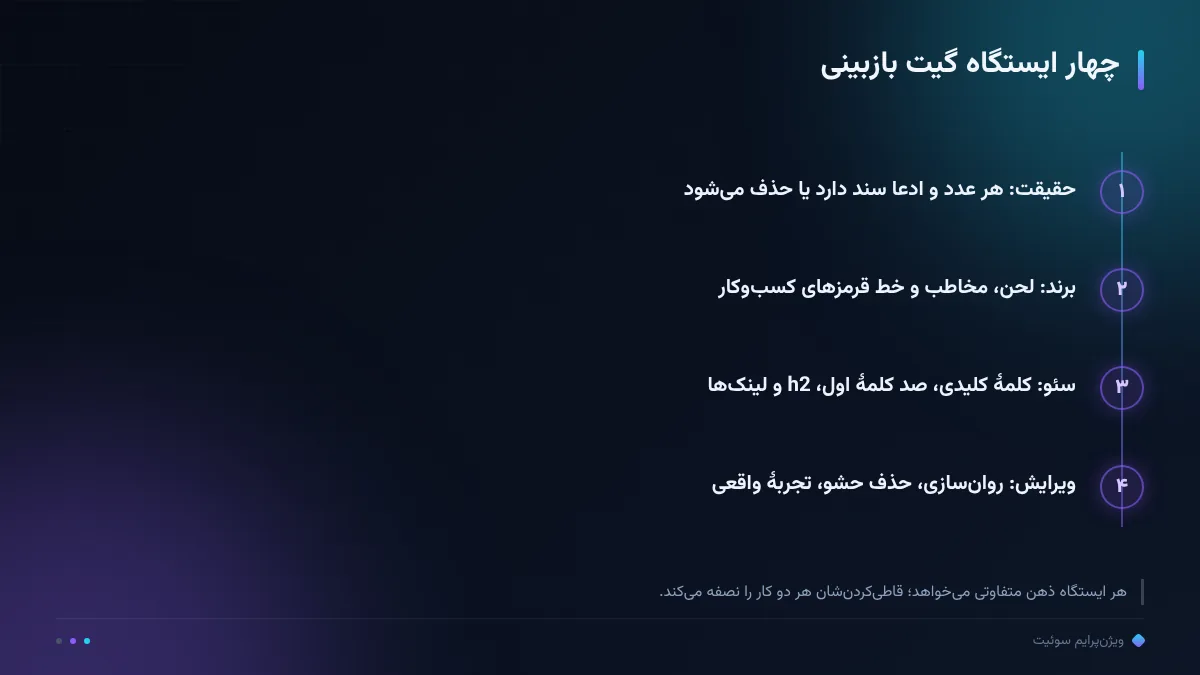
ایستگاه اول، حقیقت است: هر عدد، هر ادعا و هر «ما کردهایم» یا سند پشتش هست یا حذف میشود؛ در این ایستگاه نویسنده بیش از مدل مسئول است. ایستگاه دوم، برند است: لحن، مخاطب و خط قرمزهای کسبوکار چک میشود تا متن شبیه برند بنویسد، نه شبیه اینترنت.
ایستگاه سوم، سئو است: کلمهٔ کلیدی در عنوان و صد کلمهٔ اول، یکی از h2ها با فرم طبیعی عبارت، ساختار پاسخمحور و لینکهای داخلی مرتبط. ایستگاه چهارم، ویرایش انسانی است: روانسازی، حذف حشو، افزودن تجربهٔ واقعی و بومیسازی مثالها؛ اینجا است که متن «صدای ما» میگیرد. به تجربهٔ ما گذر از هر چهار ایستگاه بهترتیب، از ویرایش پراکندهٔ همزمان سریعتر است؛ هر ایستگاه ذهن متفاوتی میخواهد و قاطیکردنشان هر دو کار را نصفه میکند. سه ایستگاه اول را میتوان برگهای کرد و به یک نفر سپرد؛ ایستگاه ویرایش را کسی نگه میدارد که صدای برند در سرش است. اگر تیم کوچک است، همان یک نفر چهار کلاه سر میگذارد، ولی هر کلاه را جدا از دیگری.
آموزش گامبهگام بازبینی یک مقاله در ۴۵ دقیقه
قدم اول، پنج دقیقه خواندن کامل بدون ویرایش؛ قبل از تکهتکه کردن، ببینید متن قولی که عنوان میدهد را میدهد یا نه. قدم دوم، ده دقیقه ایستگاه حقیقت: فهرست اعداد و ادعاها را دربیاورید و هرکدام را سند بزنید یا خط بزنید. قدم سوم، پنج دقیقه لحن: سه جملهٔ اول را با صدای برند بنویسید؛ بقیهٔ متن معمولاً از همانجا تنظیم میشود.
قدم چهارم، ده دقیقه سئو: عنوان، صد کلمهٔ اول، h2ها و لینکها را با بریف تطبیق دهید. قدم پنجم، ده دقیقه ویرایش: حشوها را بزنید، تکرارها را ادغام کنید و جاهای خالی را با تجربهٔ واقعی پر کنید. قدم ششم، پنج دقیقه بازخورد: خطاهای تکرارشدهٔ این مقاله را در برگهٔ خطاها ثبت کنید تا به پرامپت و بریف بعدی منتقل شود. این تقسیم زمان برای مقالهٔ ۱۵۰۰ کلمهای بهینه است؛ مقالهٔ بلندتر یا فنیتر، ایستگاه حقیقت را سنگینتر میکند، نه کل چرخه را شلتر. زمان هر گام را هم ثبت کنید؛ وقتی میانگین زمان بازبینی مشخص شود، برنامهریزی انتشار واقعی میشود و گیت دیگر قربانی تقویم نخواهد شد.
کجا AI کافی است و کجا نویسندهٔ انسانی لازم است؟
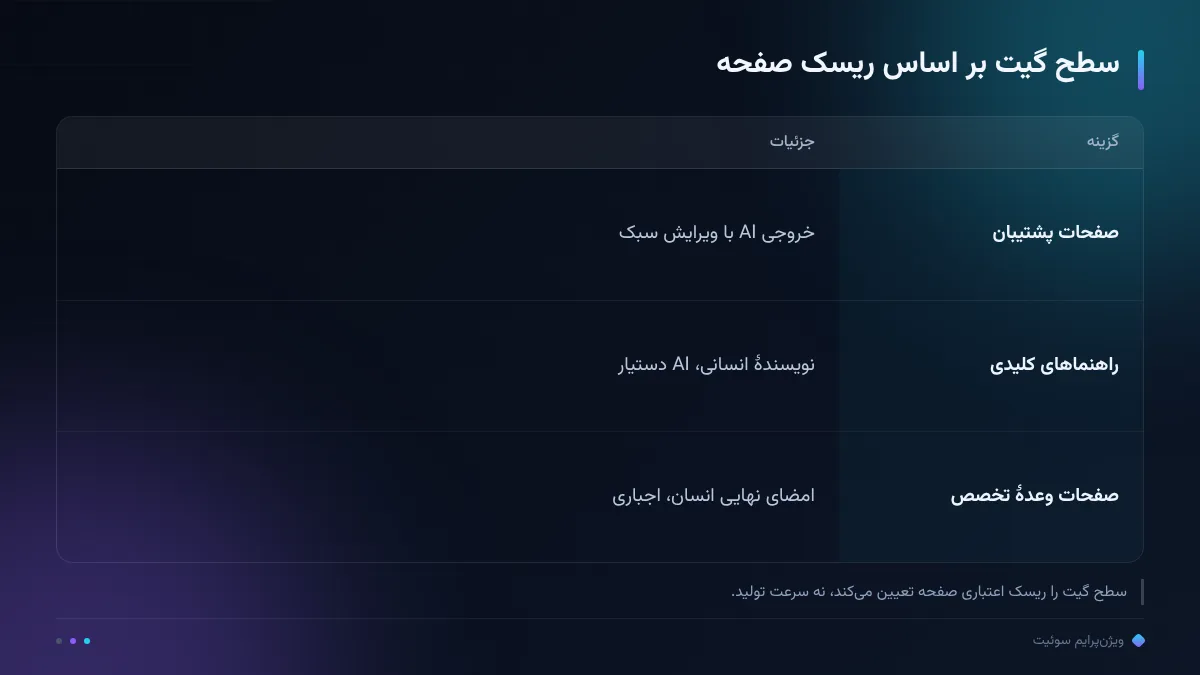
همهٔ صفحات یک سایت بازبینی سنگینِ یکسان نمیخواهند؛ سطح گیت را با ریسک صفحه تنظیم کنید. برای صفحات پشتیبان، توضیحات ساختیافته و محتوای حمایتکننده، خروجی AI با یک ایستگاه ویرایش سبک معمولاً کافی است. برای مقالههای تجربهمحور، راهنماهای کلیدی و صفحاتی که وعدهٔ تخصص میدهند، نویسندهٔ انسانی از ابتدا در چرخه لازم است و AI دستیار اوست، نه جایگزینش. معیار عملیاش دو پرسش است: اگر این صفحه اشتباه بگوید، چه چیزی از دست میرود؟ و آیا متن به تجربهٔ واقعی نیاز دارد؟ اگر جواب اول «اعتبار» و جواب دوم «بله» بود، مسیر نویسندهٔ انسانی است.
مقایسهٔ کاملتر دو مسیر را در هوش مصنوعی یا نویسنده و تحلیل هزینهاش را در هزینهٔ محتوای هوش مصنوعی در برابر انسانی نوشتهایم؛ به تجربهٔ ما مرز تصمیم، «ریسک اعتباری صفحه» است نه «سرعت تولید». هر جا خطا به مشتری میرسد یا وعدهٔ کسبوکار میسازد، انسان باید امضای نهایی را بزند. این مرز برای صفحات فروشگاهی سختتر هم هست: توضیح محصولی که وعدهٔ فنی میدهد، جای خطا ندارد.
سه دام تیمها در مقیاسسازی
دام اول، ویرایش آرایشی است: فقط روانسازی جملهها بدون چک حقیقت؛ متن بهتر میخوانده و هنوز به همان اندازه خطرناک است. دام دوم، حذف انسان از چرخه بعد از چند ماه موفقیت؛ تیم خسته میشود، گیت به فرم بیجان تبدیل میشود و خطاها از همان روز برمیگردند. دام سوم، نبستن بازخورد به ورودی: خطاها هر مقاله دوباره تعریف میشوند، درحالیکه باید در پرامپت تولید محتوا و بریف مادر بسته شوند تا مدل دفعهٔ بعد همان خطا را نسازد.
پادزهر هر سه دام، یک برگهٔ ساده است: فهرست خطاهای تکرارشده که ماهانه مرور میشود و به پرامپتها اضافه میگردد. به تجربهٔ ما تیمهایی که این برگه را زنده نگه میدارند، نرخ بازنویسی هر ماه کمتر میشود؛ تیمهایی که فقط «متن بیشتر» میخواهند، هزینهٔ بازبینیشان هر ماه بیشتر. مالک برگه را هم مشخص کنید؛ مسئولیت شناور یعنی هیچکس. به تجربهٔ ما یک نفر باید مالک چرخهٔ گیت باشد، حتی وقتی همه در بازبینی شریکاند.
جمعبندی؛ محتوای استاندارد، نه AI خام
جمعبندی راهنما: بازبینی محتوای هوش مصنوعی چهار ایستگاه دارد — حقیقت، برند، سئو و ویرایش — و با روش ۴۵ دقیقهای برای مقالهٔ ۱۵۰۰ کلمهای قابل اجراست. هفت ریسک همیشگی را در چکلیست ثابت کنید، سطح گیت را با ریسک صفحه تنظیم کنید و از سه دام ویرایش آرایشی، حذف انسان و نبستن بازخورد بپرهیزید. ممیزی رایگان دامنه نشان میدهد محتوای فعلی سایت شما از این گیت گذشته است یا نه.
اگر ترجیح میدهید چرخهٔ تولید تا بازبینی را کامل بیرونسپاری کنید، معرفی ویژنپرایم سوئیت پک محتوایی را نشان میدهد که گیت کیفیت ۳۰ مرحلهای و بازبینی انسانی بخشی ذاتی آن است. به تجربهٔ ما تمایز بلندمدت در بازار محتوا، سرعت نیست؛ قابل اعتماد بودن هر صفحه است — و قابل اعتماد شدن، فقط از گیت انسانی رد میشود.
سفارش پک محتوای سئو
پک محتوا — ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله (اشتراکی ۱۵٪ کمتر)
سفارش پک محتوای سئورصد ما، رشد شما.
سؤالات پرتکرار
بازبینی هر مقالهٔ AI چند دقیقه وقت میگیرد؟
به تجربهٔ ما ۳۰ تا ۴۵ دقیقه برای مقالهٔ ۱۵۰۰ کلمهای با گیت چهارایستگاهی؛ بدون ساختار، ویرایش پراکنده معمولاً بیشتر از این وقت میبرد و نتیجهاش هم کمتر است.
مهمترین چیزی که در خروجی AI میشکند چیست؟
اعداد و ادعاهای بیمنبع و تجربههای ناموجود. قاعدهٔ ما ساده است: هر عدد یا سند دارد یا حذف میشود و هر «ما کردهایم» باید پشتش آزمایش واقعی باشد.
آیا ابزارهای تشخیص متن AI کافیاند؟
نه؛ آن ابزارها خطای دوطرفه دارند و کیفیت را نمیسنجند. معیار ما ریسکهای محتوایی است — ادعا، لحن، ساختار — نه حدس زدن منشأ متن.
کدام صفحات را میتوان با گیت سبکتر منتشر کرد؟
صفحات پشتیبان و توضیحات ساختیافته با ایستگاه ویرایش سبک کافیاند؛ مقالههای تجربهمحور و راهنماهای کلیدی چرخهٔ کامل چهار ایستگاهی میخواهند.
بازخورد بازبینی کجا ثبت میشود؟
در یک برگهٔ خطاهای تکرارشده که هر ماه مرور و به پرامپت و بریف مادر اضافه میشود؛ تا خطا یکبار برای همیشه بسته شود، نه در هر مقاله تکرار.