آموزش گامبهگام فارسیسازی محتوای هوش مصنوعی؛ از پیشنویس تا انتشار
پیشنویسهای مدلهای زبانی برای فارسی، غالباً از نظر دستور زبان درستاند؛ مشکل جایی است که متن درست اما بیریتم خوانده میشود: جملهها طولانی و منگولارند، واژهها درستاند ولی کنار هم نمینشینند و لحن، از بند به بند عوض میشود. این فاصله با «چند اصلاح کوچک» پر نمیشود؛ با یک پاس ساختیافته پر میشود که هر گامش یک لایهٔ مشخص را درست میکند.
فارسیسازی محتوای هوش مصنوعی چیست و با ویرایش چه فرقی دارد؟
ویرایش معمولی غلطها را میگیرد: املاء، نشانهگذاری، جملهٔ ناقص. فارسیسازی محتوای هوش مصنوعی یک لایه بالاتر است: بازسازی جملهها در ریتم طبیعی فارسی، انتخاب واژههایی که خوانندهٔ ایرانی همانطور که هست میگوید، و برداشتن آن ساختهایی که میراثِ جملهسازی انگلیسیاند — جملههای سهمنگوله، صفات تزئینی پشت هم، و عبارتهای واسطهای که هیچ فارسیزبانی در گفتار روزمره به کار نمیبرد. خروجی ویرایش، متنی بیغلط است؛ خروجی فارسیسازی، متنی بومی.
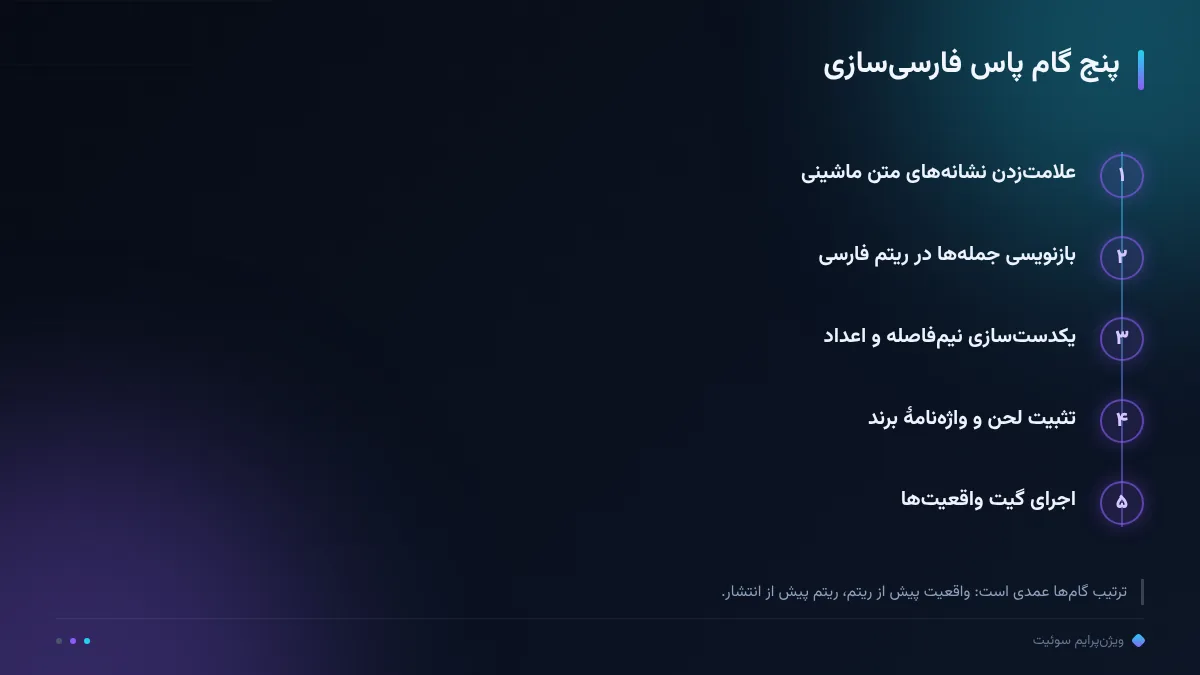
این تفکیک را از اول نگه دارید چون ترتیب اجرا را تعیین میکند: پیش از آنکه سراغ ریتم و لحن بروید، باید بدانید متن چقدر «ماشینی» است؛ و پیش از انتشار، باید گیت واقعیتها از آن عبور کند. پنج گام بعدی همین ترتیب را اجرا میکند و هر گام، خروجی قابل چک دارد؛ در خط ما این پاس داخل ایستگاه بازبینی انسانی اجرا میشود و هیچ مقالهای بدون آن به انتشار نمیرسد.
خبر خوب اینکه این پاس مهارت خاصی نمیخواهد: زبان مادریتان کافی است. آنچه لازم است، یک ترتیب ثابت و یک فهرست چک است تا هر بار همهٔ لایهها دیده شوند؛ همین راهنما آن ترتیب را میدهد. فارسیسازی محتوای هوش مصنوعی در خط ما یک قدم فرایندی است، نه سلیقهٔ فردی؛ و قدمهای فرایندی، تکرارشدنی و قابل آموزش به تیماند.
گام اول؛ نشانههای متن ماشینی را پیدا کنید
نشانهها تکرارپذیرند و با یک بار دیدن، دفعهٔ بعد چشمتان آنها را میگیرد. رایجترینها: آغازگرهای عمومی که هیچ اطلاعات جدیدی ندارند؛ عبارتهای واسطهٔ تکراری در ابتدای هر پاراگراف که فقط مکانیزم جابهجاییاند؛ ساختار موازی سهتایی در همهٔ بندها؛ جملههای بلند با سه زیرجمله که باید دو جملهٔ کوتاه شوند؛ صفاتی که ادعا میسازند بدون اینکه چیزی بگویند؛ و جمعبندیهایی که فقط متن را تکرار میکنند. اینها را در یک گذرِ خواندنِ بلند علامت بزنید؛ هنوز بازنویسی نکنید. نشانههای این فهرست در پیشنویسهای تازه همیشه یکساناند، چون مدلها هم الگوهای خودشان را تکرار میکنند؛ یک دور علامتزدن، چشم شما را برای بچهای بعدی تیز میکند.
یک آزمون ساده این گذر را دقیق میکند: خواندن بلند. جملهای که هنگام گفتنِ بلند طبیعی نمیآید — حتی اگر دستوری درست باشد — کاندیدای بازنویسی است. به تجربهٔ ما همین آزمون یکدقیقهای، بیش از هر فهرست ابزار، ترجمهمایه را نشان میدهد؛ چون فارسی در گوش یکدست است، نه در چشم. فهرست علامتخوردهها را کنار بگذارید؛ گام دوم با همین فهرست کار میکند.
گام دوم؛ زبانآمیزی جملات در ریتم فارسی
زبانآمیزی یعنی جمله را از نو، به فارسیِ گفتارِ متخصص بنویسید — نه اصلاح جزئی همان جملهٔ منگولار. چهار قاعدهٔ اجرایی دارد. اول، شکستن: هر جملهٔ سهزیرجملهای معمولاً دو جملهٔ کوتاهتر میشود؛ فارسی نوشتاریِ روان با جملههای هشت تا هفدهکلمهای نفس میکشد. دوم، ترتیب طبیعی: فارسی مفعول و پیوند را دیرتر میخواهد؛ جملاتی که با قیدهای ترجمهای شروع میشوند، معمولاً از انگلیسی واردهاند. سوم، فعل روان: بهجای ترکیبهای «انجام دادنِ» چیزی، همان فعل را بیاورید؛ «بررسی کنید» بهجای «بررسیِ آن را انجام دهید». چهارم، حذف سرویس صفات: هر صفت باید اطلاعات بدهد، وگرنه میرود.
در همین گام، ضمیر مخاطب را هم یکبار برای همیشه انتخاب کنید: «شما» محترمانه یا صمیمی، و در کل متن همان. جابهجایی ضمیر بین بندها — نشانهٔ رایج متنهای چندنویسندهٔ ماشینی — اعتماد خواننده را میشکند. خروجی این گام متنی است که اگر صدای خودتان را بخواند، جملههایش را طبیعی میگویید؛ اگر نه، همان بند را دوباره از نو بنویسید و نه اصلاح کنید.
گام سوم؛ نیمفاصله، اعداد و علامتگذاری راستبهچپ
لایهٔ سوم تایپوگرافی است و متأسفانه جایی است که خروجی مدلها بیقاعدهتریناند. نیمفاصله در سه خانواده اجباری ماست: پیشوند «می»، پسوندهای «ها، تر، ترین» و «ای» نامعین. اعداد در متن فارسی با ارقام فارسی نوشته میشوند؛ اعشار با نقطهٔ فارسی «٫»، هزارگان با «٬» و درصد با «٪» چسبیده به عدد. گیومهها فارسیاند — «همین شکل» — و نقطهویرگول و ویرگول فارسی جای نیمدونقطه و کامای انگلیسی مینشینند. اینها جزئیات بهنظر نمیرسند؛ خواننده آگاه، تایپوگرافی را همانجا میبیند که سطح کار را میبیند.
برای اینکه این لایه تکرارپذیر شود، یک برگهٔ سبک کوچک بسازید و کنار خط بگذارید: چسبیدگیها، شکل اعداد، شکل درصد و واحدها، و چند تصمیم واژگانی. هر اصلاح تکرارشده در بازبینیها، به همان برگه اضافه میشود تا نوبت بعد سؤال نشود. به تجربهٔ ما برگهٔ سبک یکصفحهای، تفاوت خطهای بیقاعده و خطهای یکدست همینجاست؛ چون تایپوگرافی تنها لایهای است که با یک تصمیم، برای همیشه حل میشود.
گام چهارم؛ لحن برند را یکدست کنید
پیشنویس ماشینی لحن ندارد؛ لحن را شما به آن میدهید. سه ابزار این کار است. اول، واژهنامهٔ اصطلاحات: تصمیمهای یکبار برای همیشه — «مشتری» یا «کاربر»، «پلن» یا «طرح»، «فروشگاه» یا «سایت» — که در همهٔ متنهای برند یکسان میمانند؛ بدون واژهنامه، هر مقاله یک زبان تازه میسازد. دوم، سطح ادب و فاصلهٔ مخاطب: مشاور در کنار میز یا مدرس روی سکو؛ یکی را انتخاب کنید و بمانید. سوم، مرز تبلیغ: در متن سئو، لحن مشاور است نه بازاریاب؛ صفتهای تعریف را با قیدهای اندازهگیری عوض کنید.
این گام در خطهای چندنویسنده حیاتیتر است: وقتی ده مقاله در ماه منتشر میشود، خواننده لحنها را مقایسه میکند حتی اگر نامشان را نبرد. تمرین سادهٔ ما: سه جملهٔ ابتدایی یکی از مقالههای قدیمی تأییدشده را کنار پیشنویس تازه بگذارید؛ اگر فاصلهٔ لحن از این مقایسهٔ کوتاه دیده شد، هنوز کار گام چهارم تمام نشده است. لحن یکدست، همان چیزی است که خوانندهٔ ثابت میسازد و بازگشتها را.
گام پنجم؛ گیت واقعیتها پیش از انتشار
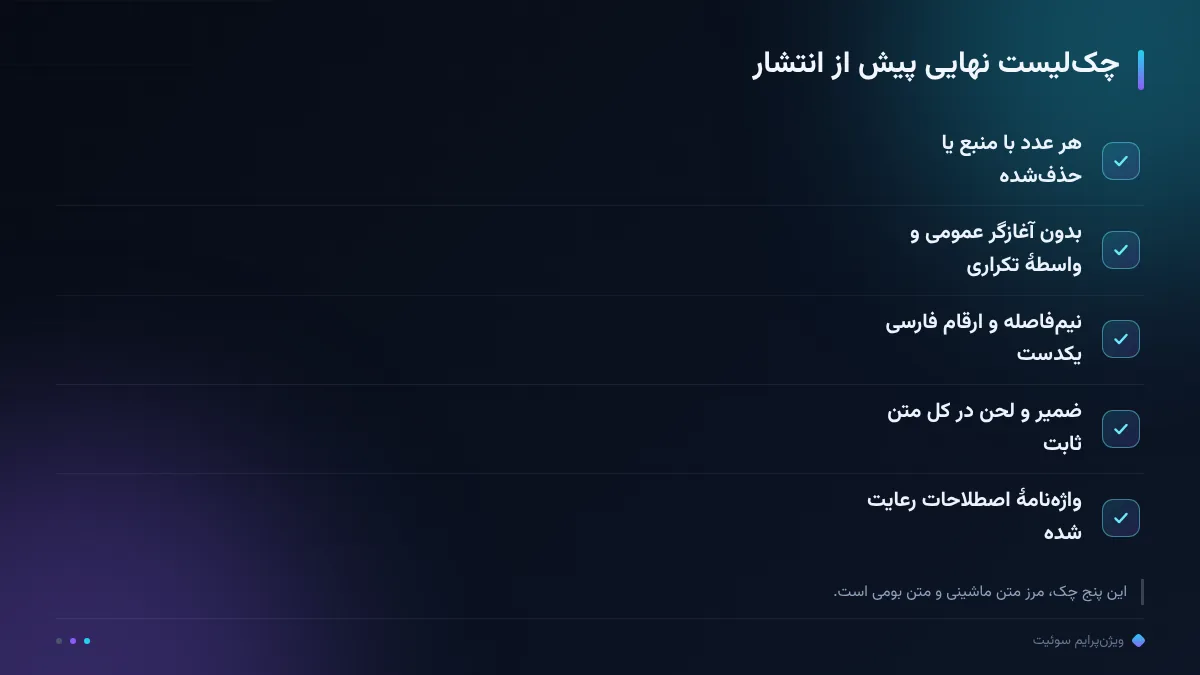
فارسیسازی متن را بومی میکند؛ اما بومیشدن، درستشدن نیست. گام پنجم واقعیتها را میچکد و سه قاعدهٔ سخت دارد. اول: هر عدد یا آمار یا منبعِ مشخص — یا مرجع واقعیِ قابل ذکر با تاریخ گردآوری دارد، یا حذف میشود؛ عدد بیمنبع در متن ما جایی ندارد، هرچقدر هم به جملات جلوه بدهد. دوم: ادعای حاشیهدار یا به تجربهٔ ما بازنویسی میشود — با مرزهای خودِ تجربه — یا کامل حذف؛ «بهطور میانگین» ساختگی، همان دروغ محترمانه است. سوم: قیمت، نام برند و قول نتیجه فقط با سند وارد متن میشوند؛ هیچ استثنایی برای «فقط یک اشاره» وجود ندارد.
این گیت را ماشینی هم میشود اجرا کرد: عددی که در بریف منبع ندارد، پیش از بازبینی انسانی علامت میخورد. اما حکم نهایی را انسان میدهد، چون تشخیص «ادعای حاشیهدار» قضاوت است، نه الگو. اگر خط تولید انبوه دارید، این گیت را از پاس فارسیسازی جدا نکنید؛ ترتیب ما ابتدا واقعیت، بعد ریتم است — بازنویسیِ بومیِ یک ادعای غلط، فقط همان ادعا را خوشلحنتر میکند.
جای این پاس در خط تولید و جمعبندی
این پاس جای خالی مشخصی در خط محتوا دارد. راهنمای تولید انبوه محتوا با کنترل کیفیت خط چهارایستگاهی — بریف، تولید دستهای، گیت کیفیت، بازبینی انسانی — را باز کرده است؛ فارسیسازی محتوای هوش مصنوعی داخل همان ایستگاه بازبینی انسانی اجرا میشود و گیت ماشینی، نشانههای خام و اعداد بیمنبع را پیش از آن میگیرد. جزئیات ایستگاه بازبینی را در بازبینی محتوای هوش مصنوعی پیش از انتشار و ورودی مدل را در پرامپت تولید محتوا برای سئو نوشتهایم؛ هر سه متن کنار هم، لایههای کامل یک خط فارسیسالم را میسازند.
جمعبندی در پنج گام: نشانههای ماشینی را علامت بزنید، جملهها را در ریتم فارسی از نو بنویسید، نیمفاصله و اعداد را یکدست کنید، لحن برند را تثبیت کنید و گیت واقعیتها را قبل از انتشار اجرا کنید. سی تا شصت دقیقه برای هر مقاله، تفاوت «ترجمهای خواندن» و «بومی خواندن» است — و به تجربهٔ ما، بازگشت خواننده از همان تفاوت میآید. اگر خواستید همین پاس را بهصورت خدمت تحویل بگیرید، پک محتوای سئو با گیت چندلایهٔ خودش آن را اجرا میکند؛ زمینهٔ کاملتر در معرفی ویژنپرایم سوئیت و نقطهٔ شروع دامنه در ممیزی رایگان دامنه است؛ هاب خوشه هم در هاب محتوای هوش مصنوعی با گیت کیفیت ادامه دارد.
سفارش پک محتوای سئو
پک محتوا — ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله (اشتراکی ۱۵٪ کمتر)
سفارش پک محتوای سئورصد ما، رشد شما.
سؤالات پرتکرار
فارسیسازی با ویرایش معمولی چه فرقی دارد؟
ویرایش غلطها را میگیرد؛ فارسیسازی ریتم، واژهگزینی و لحن را بازسازی میکند تا متن بومی خوانده شود. به تجربهٔ ما متن بیغلط اما ترجمهای، هنوز اعتماد خواننده را نمیگیرد.
این پاس برای هر مقاله چند دقیقه وقت میبرد؟
برای مقالههای هزار و پانصد تا دو هزار کلمه، سی تا شصت دقیقه کار حسابشده؛ مقالههای پرعدد و پرادعا به دلیل گیت واقعیتها بیشتر زمان میخواهند.
چطور تشخیص میدهم متن ماشینی است؟
خواندن بلند: جملهای که طبیعی نمیگویید کاندیدای بازنویسی است؛ بههمراه آغازگرهای عمومی، عبارتهای واسطهٔ تکراری، ساختار موازی یکنواخت و صفات بیدلیل.
اعداد مدل زبانی را میشود نگه داشت؟
فقط اگر مرجع واقعی قابل ذکر با تاریخ گردآوری داشته باشند؛ در غیر این صورت حذف میشوند. ادعای حاشیهدار یا با برچسب تجربهٔ صریح بازنویسی میشود یا حذف.