دادهٔ خصوصی و مدلهای عمومی به زبان ساده؛ بدون اصطلاح فنی
- دادهٔ خصوصی و مدلهای AI؛ مرز بگو و نگو کجاست؟
- رمز دوم قفسه در کافه؛ تشبیهی که همهچیز را روشن میکند
- سه سطح داده؛ کاملاً عمومی، داخلیِ حساس، محرمانهٔ مشتری
- قاعدههای سادهٔ تیم؛ بدون مشترینام، بدون قیمت مذاکرهای، نسخهٔ ماسکشده
- جای گیت کیفیت؛ خروجی AI را انسان با چکلیست تأیید میکند
- ابزار اشتراکی یا سازمانی؛ چه چیزی عوض میشود و چه چیزی نه؟
- جمعبندی؛ سه جملهای که با خود ببرید
در همین خوشه، پانزده اشتباه رایج در دادهٔ خصوصی و مدلهای عمومی و راهحل هرکدام فهرستی پیش میرود: پانزده اشتباه تکراری، هرکدام با راهحل کوتاهش. این راهنما یک قدم قبل از آن فهرست میایستد و خودِ مرز را میچیند؛ برای تیمی که هنوز قاعدهٔ مکتوب ندارد و به زبان ساده میخواهد بداند کدام داده اصلاً وارد ابزار عمومی نمیشود. آن مقاله برگهٔ چکِ تیمهای مجهز است؛ این یکی نقشهٔ مرز برای روزِ شروع.
قرار ما مثل بقیهٔ راهنماهای به زبان سادهٔ ماست: هیچ اصطلاح فنی تعریف نمیکنیم و همهچیز را با تصویر روزمره میگوییم. از اول هم صادق باشیم: بحث ترساندن شما از هوش مصنوعی نیست؛ ابزار عمومی سریع و مفید است و ما خودمان هر روز از آن استفاده میکنیم. بحث دربارهٔ چیزی است که از پنجرهٔ ورودی بیرون میرود، نه کیفیت چیزی که برمیگردد؛ و تقصیر هم روی دوش ابزار نیست — روی مرزِ ناموجود.
دادهٔ خصوصی و مدلهای AI؛ مرز بگو و نگو کجاست؟
مدل عمومی هوش مصنوعی به زبان ساده یعنی سرویسی که هرچه به او میدهید، برای پردازش به محیطی مشترک و بیرون از دفتر شما میرود؛ مثل حرف زدن در اتاق انتظار، نه اتاق جلسهٔ دربسته. این نه عیب است و نه توطئه؛ ساختار محصول همین است. اما یک واقعیت ساده با خودش میآورد: آنچه میچسبانید، از کنترل مستقیم شما خارج میشود.
دادهٔ خصوصی هم تعریف سادهای دارد: هر اطلاعاتی که افشایش برای کسبوکار شما هزینه بسازد — آمار فروش، اطلاعات مشتری، قیمتهای داخلی، متن قرارداد. این تعریف حقوقی نیست؛ عملیاتی است و هر تیم میتواند در یک جلسه آن را برای خودش ببندد. وقتی یک سمتِ معادله محیط مشترک است و سمت دیگر دادهای که افشایش هزینه دارد، قاعده روی سمتِ مشخص مینشیند: دادهٔ حساس وارد نمیشود.
این قاعده را باید صریح گفت، چون جایگزینهایش دلیل نیستند: «فقط یکبار»، «کسی نمیبیند»، «ابزار معروف است». هر سه آرزو هستند، نه قاعده. مرز با آموزش عمومی هم پایدار نمیماند؛ با برگهٔ کوچک و مکتوب پایدار میماند که در بخشهای بعد میچینیم.
رمز دوم قفسه در کافه؛ تشبیهی که همهچیز را روشن میکند
صاحب فروشگاهی را تصور کنید که در کافه با مشاورِ بیرونی جلسه دارد. وسط بحث، مشاور برای پیشنهاد بهتر میگوید: «رمز دوم قفسه را بگویید.» شاید مشاور کاملاً قابلاعتماد باشد؛ اما سه چیز از دست صاحب فروشگاه خارج است. اول اینکه کنترل ندارد چه کسی دیگری آن میز را میشنود. دوم اینکه رمز بعد از گفتن پس گرفته نمیشود؛ حرف مثل آب ریخته است. سوم اینکه امنیت قفسهاش از این به بعد به حافظه و رفتار یک نفر بیرونی گره میخورد — بدون هیچ برگهای.
در دادهٔ خصوصی و مدلهای AI، پرامپت همان حرف وسط کافه است؛ محیط مشترک ابزار همان کافه است؛ و رمز دوم قفسه همان آمار فروش، اطلاعات مشتری و قیمتهای داخلی است. سه نتیجهٔ کافه یکبهیک به اینجا منتقل میشود: کنترل شنونده ندارید، داده پس گرفته نمیشود، و ریسک شما به رفتار محیطی گره میخورد که برگهاش در دست شما نیست.
اما نیمهٔ دیگر تشبیه مهمتر است: همان مشاور با نقشهٔ فروشگاه — بدون هیچ رمزی — میتواند کار عالی کند. چیدمان، دستهبندی و نوشتههای قفسه به او کمک میکند بیآنکه امنیت را وسط کافه بگذارید. به زبان پرامپت: ابزار به ساختار و متن بینام نیاز دارد، نه به هویت واقعی مشتری و مبلغ واقعی قرارداد. این دقیقاً همان نسخهٔ ماسکشده است که در قاعدههای تیم میآید.
سه سطح داده؛ کاملاً عمومی، داخلیِ حساس، محرمانهٔ مشتری
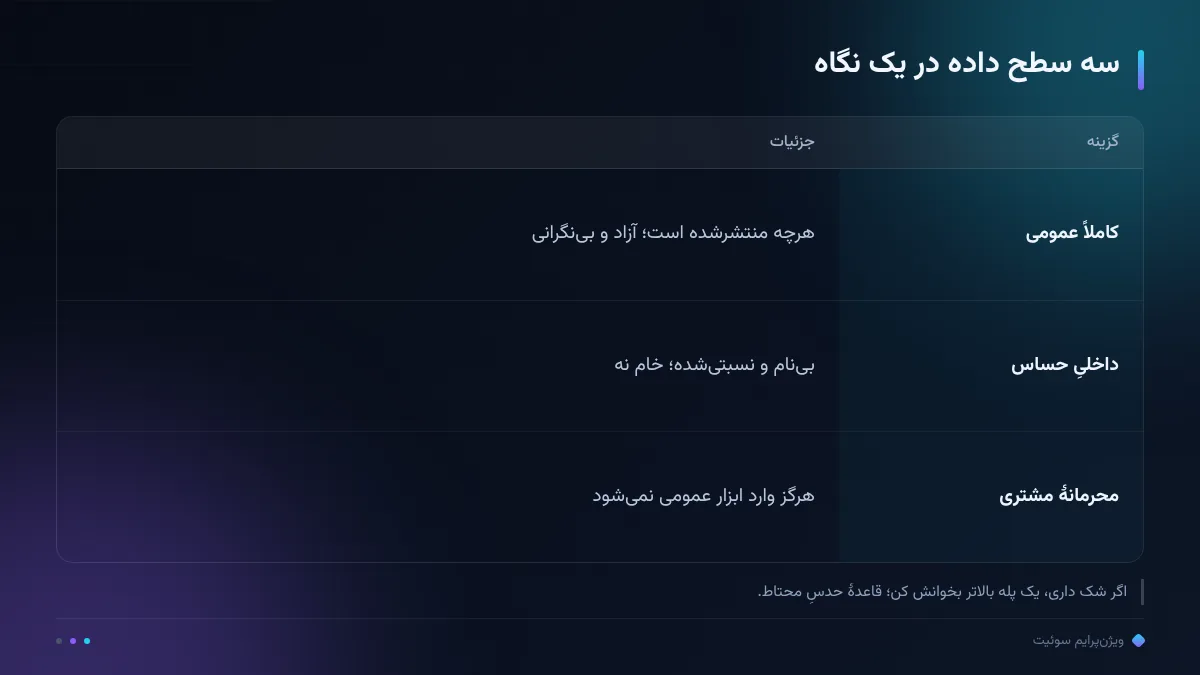
مرز را با سه سطح میچینیم؛ سه دستهای که هر همکار با یک نگاه میتواند حکم بدهد. سطح اول، کاملاً عمومی است: هر چیزی که از قبل منتشر شده و افشایش هیچ هزینهای ندارد — متن وبلاگ، توضیح عمومی خدمات، پرسشهای پرتکرار سایت. این سطح آزاد است؛ با ابزار عمومی بینگرانی کار میکند و بیشترِ کارِ محتوا همینجا است.
سطح دوم، داخلیِ حساس است: آمار فروش، قیمتهای داخلی، برنامهٔ فصلی، تعداد مشتریها. این سطح خام وارد نمیشود؛ بینام و نسبتیشده اشکال ندارد. به جای «فروش این ماه دو و چهار دهم میلیارد بود» مینویسید «فروش نسبت به ماه قبل بیست درصد رشد کرد». مدل برای پیشنهاد و ساختار به نسبت نیاز دارد، نه به عدد واقعی؛ نسبت را نگه دارید، عدد را بیرون بگذارید.
سطح سوم، محرمانهٔ مشتری است: نام و شماره و سفارش مشتریها، متن قرارداد با طرفین و مبالغ، دادهٔ سلامت یا وضعیت شخصی. این سطح هرگز وارد ابزار عمومی نمیشود — حتی با بهانهٔ سرعت، حتی «فقط یکبار». کارِ این سطح بیرون از ابزار انجام میشود یا با فایل دادهٔ ساختگی تمرین؛ نامهای خیالی، مبالغ گرد، اعداد صحنهسازیشده.
مورد خاکستری هم همیشه هست: دادهای که نمیدانید کدام سطح است. قاعدهٔ ما یک جمله است: اگر شک داری، یک پله بالاتر بخوانش کن. همان داده با پلهٔ محتاطتر هنوز قابل استفاده است؛ نشتکرده، قابل پسگرفتن نیست.
قاعدههای سادهٔ تیم؛ بدون مشترینام، بدون قیمت مذاکرهای، نسخهٔ ماسکشده
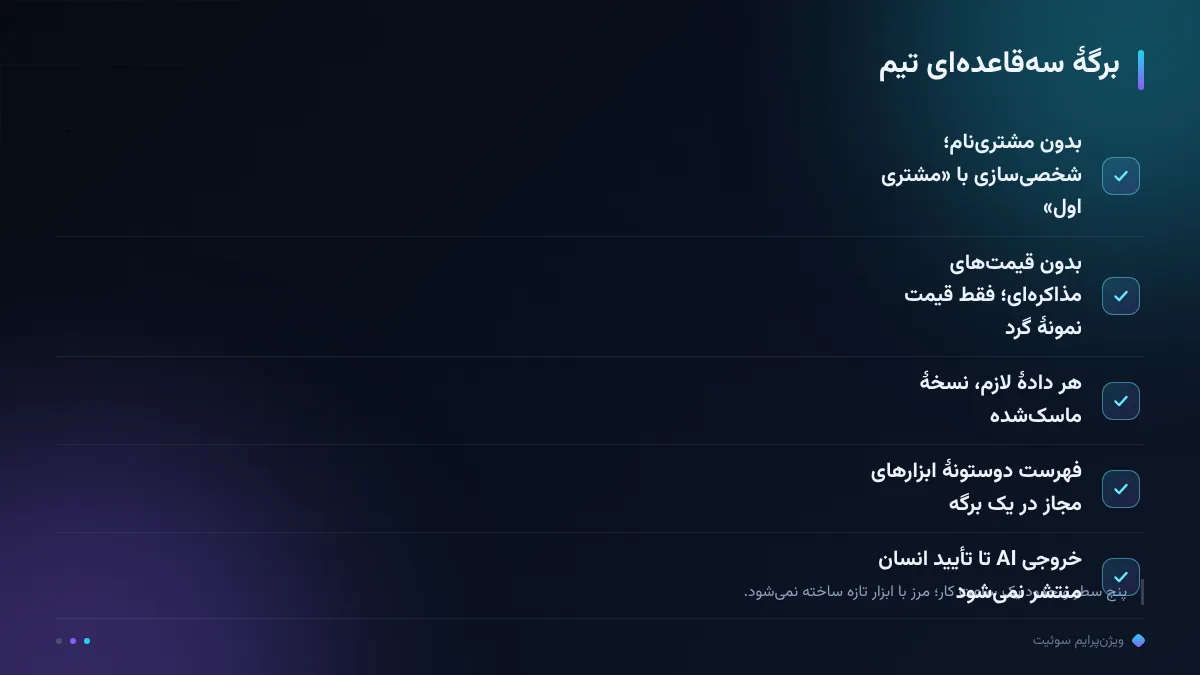
سه سطح، سه قاعدهٔ کوتاه میسازد که در یک جلسه اعلام و از فردا اجرا میشود. قاعدهٔ اول: بدون مشترینام. هر جا شخصیسازی لازم است، «مشتری اول» و «مشتری رستورانی» مینویسید؛ فهرست تماس و فایل مشتریان هرگز پیوست پرامپت نمیشود. شخصیسازی واقعی با متغیرها در سیستم ارسال انجام میشود، نه در ابزار متننویس.
قاعدهٔ دوم: بدون قیمتهای مذاکرهای. کف قیمت، تخفیف قابلاعطا و مبلغ قرارداد جاری وارد پرامپت نمیشود؛ «قیمت نمونهٔ گرد» همان کار را میکند. به تجربهٔ ما قیمت، حساسترین دادهٔ کسبوکارهای کوچک است و راحتترین برای ماسککردن هم — چون نسخهٔ گردش تقریباً هیچچیز از کیفیت پیشنهاد کم نمیکند.
قاعدهٔ سوم: نسخهٔ ماسکشده. قبل از چسباندن هر متن داخلی، نامها را «طرف اول» و مبالغ را «مبلغ قرارداد» کنید؛ فیلدهای اضافه را حذف کنید و فقط همان تکهای را بدهید که لازم است. ماسککردن ده دقیقه بیشتر نمیبرد و همان ده دقیقه، تفاوتِ «استفادهٔ مطمئن» و «استفادهٔ امیدوار» است.
کنار این سه، یک برگهٔ دوستونه هم ببندید: کدام ابزار برای کدام سطح داده مجاز است. تیمی که هر همکارش ابزار دلخواه خودش را برمیدارد، در عمل مرز ندارد؛ فهرست مجاز، مرز را برای نفر تازهوارد هم قابلفهم میکند. دربارهٔ انتخاب و هزینهٔ ابزارها در بخش بعد حرف میزنیم.
جای گیت کیفیت؛ خروجی AI را انسان با چکلیست تأیید میکند
مرز ورودی را که بستید، مرز خروجی میماند: گیت کیفیت. خروجی AI تا انسان تأیید نکرده، منتشر نمیشود — نه چون ابزار بد است؛ چون مسئولیت متنِ روی سایت با شماست، نه با ابزار. سه چیز را انسان چک میکند: درستی ادعاها و عددها، لحن و صدای برند، و اینکه هیچ جزئیاتی از ورودیهای بالادستی — اسم مشتری، عدد داخلی — در خروجی نمانده باشد.
مورد سوم کمتر گفته میشود و مهم است: گاهی مدل، جزئیاتِ دادهٔ ساختگی شما را در خروجی برمیگرداند. اگر نسخهٔ ماسکشده فرستاده باشید، همین برگشت هم بیخطر است؛ یعنی ماسککردن هم مرز ورودی را میبندد، هم ریسک خروجی را کم میکند — دو کار با یک ده دقیقه.
گیت کامل انتشار — کی، با چه چکلیستی، در کدام مرحله — در آموزش گامبهگام گردش کار محتوای هوش مصنوعی + انسان باز شده است؛ اینجا فقط جای آن را در نقشه مشخص میکنیم: بعد از تولید، قبل از انتشار، همیشه. تیمی که این دو مرز — ورودی و خروجی — را دارد، با AI راحتتر از قبل استفاده میکند، نه محتاطتر.
ابزار اشتراکی یا سازمانی؛ چه چیزی عوض میشود و چه چیزی نه؟
پرسش طبیعی جلسهٔ تیم این است: با اشتراک بهتر، مسئله حل میشود؟ پاسخ صادقانهٔ ما: شرایط سرویسهای عمومی با هم فرق دارد و بهمرور هم تغییر میکند؛ ما دربارهٔ رفتار داخلی سرویس خاصی ادعای فنی نمیکنیم. چیزی که میتوان گفت این است: قاعدهٔ پیشفرض تیم — «محرمانهٔ مشتری وارد ابزار عمومی نمیشود» — با خرید اشتراک گرانتر هم بیدلیل نمیشود؛ فقط اجرای مرز مکتوبتر میشود: قرارداد، حساب تفکیکشده و ثبت سادهٔ پرامپتهای حساس.
اگر تصمیمِ استفادهٔ سازمانی روی میز است، راهنمای کامل استفادهٔ سازمانی از هوش مصنوعی با کنترل؛ از صفر تا اجرا همین موضوع را لایهبهلایه باز کرده است؛ و برای بودجهبندی اشتراکها، هزینه و تعرفهٔ اشتراکهای هوش مصنوعی به تومان در ۱۴۰۵ جدول تومانی میدهد تا برگهٔ ابزارهای مجاز با عدد واقعی بسته شود، نه با حدس.
جمعِ این بخش در یک جمله: ابزار بهتر، مرز را حذف نمیکند؛ مرز را قابلقرارداد میکند. تیمی که سه سطح داده و سه قاعده را دارد، با هر ابزاری امن است؛ و تیمی که ندارد، با گرانترین اشتراک هم در کافه نشسته و رمز را وسط حرفش میگوید.
جمعبندی؛ سه جملهای که با خود ببرید
سه جمله با خود ببرید. اول، مسئله ابزار نیست؛ مرزِ ناموجود است — مدل عمومی مثل کافه است، نه اتاق جلسه. دوم، مرز با سه سطح داده مکتوب میشود: کاملاً عمومی، داخلیِ حساس، محرمانهٔ مشتری؛ و حدسها همیشه یک پله محتاطتر جمع میشوند. سوم، سه قاعدهٔ تیم — بدون مشترینام، بدون قیمت مذاکرهای، نسخهٔ ماسکشده — با گیت کیفیت انسانی کامل میشود تا خروجی هم مثل ورودی بیریسک باشد.
اگر میخواهید وضعیت مرزها و کیفیت انتشار دامنهتان قبل از بستن این برگهها دیده شود، ممیزی رایگان دامنه نقطهٔ شروع بدونهزینه است؛ اجرای همین مرزها و گیتها در چرخهٔ تولید، بخشی از پلتفرم تولید محتوای سوئیت است و نقشهٔ کامل بحث ابزارها در هاب هوش مصنوعیها برای محتوا کنار هم است. مرز داده مثل چراغ جلو است: سرعت را کم نمیکند؛ فقط مسیر را میبیند.
رصد ما، رشد شما.
سؤالات پرتکرار
آیا هرگز نمیشود دادهٔ فروش را با AI تحلیل کرد؟
میشود، با نسخهٔ ماسکشده: بدون نام مشتری، بدون عدد واقعی، با نسبتیکردن اعداد. خامِ دادهٔ فروش وارد ابزار عمومی نمیشود.
نسخهٔ ماسکشده یعنی چه؟
قبل از چسباندن متن به ابزار، نامها را «مشتری اول» و مبالغ را «قیمت نمونهٔ گرد» میکنید؛ ابزار به ساختار جمله نیاز دارد، نه به هویت واقعی.
اشتراک سازمانی مرز را حذف میکند؟
نه؛ شرایط سرویسها متفاوت است، اما قاعدهٔ پیشفرض تیم ما میماند: محرمانهٔ مشتری هرگز وارد ابزار عمومی نمیشود و استثناها مکتوب باز میشود.
از کجا شروع کنیم؟
یک برگهٔ سهسطری ببندید (عمومی، داخلی، محرمانه)، سه قاعده را در جلسهٔ بعد اعلام کنید و فایل دادهٔ ساختگی بسازید؛ همهاش حدود یک ساعت کار است.
فرق این مقاله با راهنمای پانزده اشتباه چیست؟
آن مقاله فهرستی است: پانزده اشتباه با راهحل هرکدام؛ این یکی قبل از فهرست، مرز سهسطحی داده و قاعدههای تیم را به زبان ساده میچیند.