ابزارهای تشخیص متن AI به زبان ساده؛ بدون اصطلاح فنی
- ابزار تشخیص متن AI دقیقاً چه میکند؟ تشبیه داور سبک
- چه چیزی را میسنجد و چه چیزی را نمیسنجد؟
- مثبت کاذب؛ وقتی متن انسانی مشکوک علامت میخورد
- منفی کاذب و متن فارسی؛ دو نقطهٔ کور
- به چه اعتماد کنیم و به چه نه؟
- گوگل چه میگوید؟ عددِ تشخیصگر ملاک نیست
- جایگزین عملی؛ گیت کیفیت و بازخوانی انسانی
- جمعبندی؛ سه جملهای که با خود ببرید
در گیت فرودگاه، مأموری فقط از «لهجه» حدس میزند مسافر کجایی است؛ آدمی که بیست سال در شهر دیگری زندگی کرده را گاهی اهل آن شهر میگیرد و اهل آنجا را غریبه حساب میکند. ابزارهای تشخیص متن هم همین کار را با «لهجهٔ نوشتار» میکنند: از روی سبک حدس میزنند، نه از روی سند و تاریخچه. حدسِ لهجهای گاهی درست درمیآید؛ برای تصمیم جدی کم میآورد.
در همین بخش، مقالههای خواهر نقشهای دیگری دارند: موضع گوگل درباره محتوای AI به زبان ساده حرف رسمی گوگل را با تشبیههای روزمره باز کرده، پایش محتوای AI در طول زمان؛ آموزش گامبهگام بعد از انتشار را آموزش میدهد و کیفیت خروجی فارسی AI و پنج خطای پرتکرارش را هم در مقالهٔ دیگری از همین خوشه خواندهاید. این مقاله فقط یک سؤال را زیر ذرهبین میبرد: ابزارهای «تشخیص» خودشان چقدر قابل اعتمادند؟ نقشهٔ کامل خوشه در هاب هوش مصنوعیها برای محتوا جمع است.
ابزار تشخیص متن AI دقیقاً چه میکند؟ تشبیه داور سبک
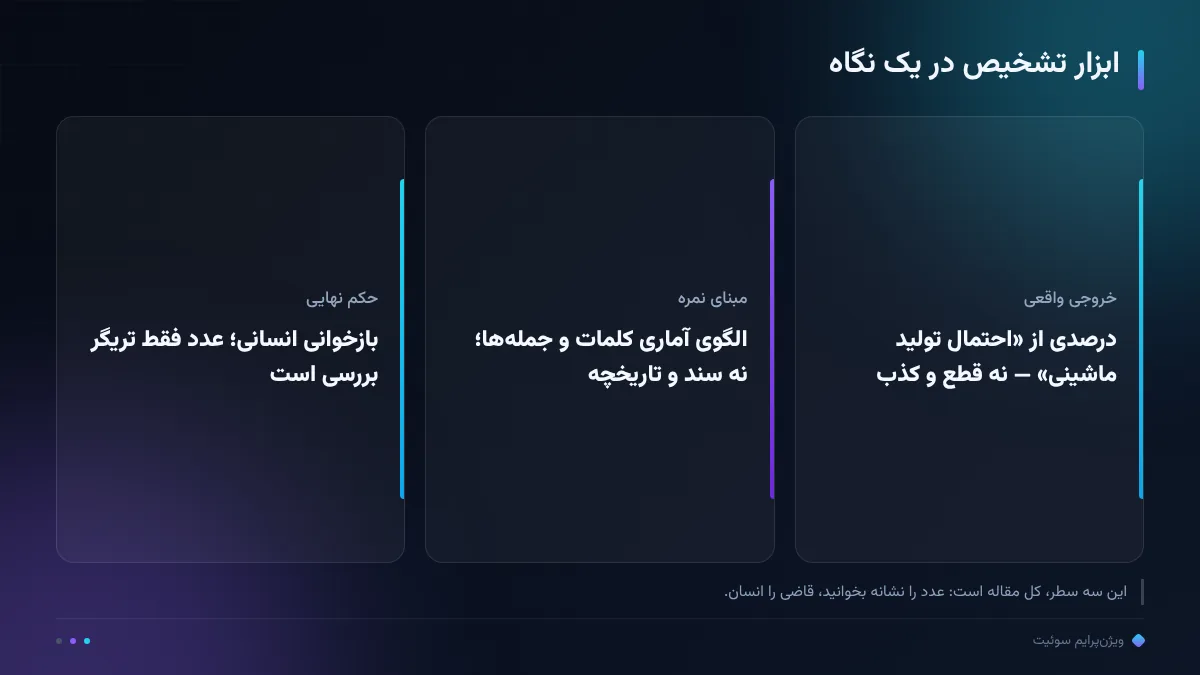
کاری که این ابزار میکند را با داور مسابقهٔ خوشنویسی مقایسه کنید: برگهای روی میز است، بدون اسم؛ داور از سبک قلم حدس میزند چه کسی نوشته. اثر انگشتی در کار نیست — ابزار نه تاریخچهٔ نوشتن را دیده و نه میداند متن در چه نرمافزاری تایپ شده؛ فقط متنِ روی میز را دارد و با الگوهایی که از هزاران متن دیگر یاد گرفته مقایسهاش میکند.
خروجیاش هم عددی «احتمالی» است، نه دوحرفی: درصدی از اینکه «الگوها به تولید ماشینی نزدیکترند». به تجربهٔ ما ابزارهایی که دیدهایم خروجی را به شکل درصدِ احتمال میدهند، نه حکمِ قطع یا کذب — و همین شکل خروجی، خودش اعترافِ سازنده به حدسیبودنِ عدد است. سه چیز را از هم جدا کنید تا کاربردش روشن شود؛ کارت بالای همین بخش همان سه سطر را نشان میدهد.
«الگوی آماری» به زبان ساده یعنی چیزی شبیه حدس زدنِ ادامهٔ جمله: جملههایی که ادامهشان راحت حدس زده میشود و یکدستاند، نمرهٔ بیشتری میگیرند. همین یک جملهٔ کوتاه، نیمی از توضیح خطاهای بخشهای بعدی است؛ بقیهٔ راهنما روی همین تعریف سوار میشود.
چه چیزی را میسنجد و چه چیزی را نمیسنجد؟
آنچه واقعاً میسنجد یکنواختی و پیشبینیپذیری است: توازن طول جملهها، تکرار ساختارها، واژههایی که در هر جملهای میتوانند بنشینند. شاعر دستمزدیای را تصور کنید که همهٔ بیتهایش هموزن و هممزه است؛ داور سبک به چنین متنی نمرهٔ «قالبی» میدهد — چه با قلم انسان نوشته شده باشد چه با ابزار.
آنچه نمیسنجد مهمتر است: درستیِ ادعاها را نمیداند، سرقت ادبی — کپیبودن — سنجهٔ جداگانهای است و «مفید بودن برای خواننده» را اصلاً نمیبیند. متن انسانیِ بیمثال و کلی ممکن است «AI» علامت بخورد و همچنان متن ضعیفی بماند؛ و متنِ کمکی که با مثال و عدد واقعی ویرایش شده، رد شود ولی برای خواننده ارزش واقعی داشته باشد. عددِ تشخیص هیچکدام از این دو را نمیفهمد.
پس از همینجا یک تفکیک را بچسبانید: عددِ تشخیص و کیفیتِ محتوا دو سنجهٔ مستقلاند. یکی سبک را حدس میزند؛ دیگری را فقط خواننده و محکهای کیفیت میسنجند. هر جا این دو قاطی شوند، هم متن سالم متهم میشود هم متن بیروح تبرئه.
مثبت کاذب؛ وقتی متن انسانی مشکوک علامت میخورد
مثبت کاذب یعنی متنِ کاملاً انسانی که مشکوک علامت میخورد. قربانیهای همیشگیاش را ببینید: نویسندهٔ رسمی و اداری که جملههایش هموزناند، مترجمی که ترجمهاش تمیز و یکدست درآمده، دانشجویی با نثر کتابوار، حتی خبرنگار صاحبسبکی که قالب خبر را هزار بار تکرار کرده. لهجهٔ نوشتاریشان «تمیز و منظم» است — و ابزار، تمیزیِ منظم را با ماشین اشتباه میگیرد.
معنایش را برای خودتان ساده نگه دارید: این خطا یعنی «سبکِ یکنواخت دیده شده»، نه «تقلب ثبت شده». گاهی همین عدد نکتهٔ ویرایشی مفیدی هم دارد — متن شما شاید واقعاً یکنواخت نوشته شده باشد؛ اما محکومیت انسانی، رد دستمزد یا جریمه بر پایهٔ یک عددِ احتمالی، به تجربهٔ ما بدترین کاربرد این ابزارهاست.
برای قضاوت انسانی، تست سادهای در مقالههای همین مجموعه تمرین میشود: نام کسبوکار را در متن عوض کنید؛ اگر متن برای هر فروشگاه و کلینیکی صادق ماند، مشکل واقعی بیروحیِ متن است — نه ابزاری که آن را دیده. متهمِ درست، کیفیت است؛ عدد فقط چراغ راهنمای بازخوانی.
منفی کاذب و متن فارسی؛ دو نقطهٔ کور
منفی کاذب یعنی متنِ ماشینیِ کمویرایش که رد میشود. چرا اتفاق میافتد؟ متن کوتاه است و الگو نمونهٔ کافی ندارد؛ یا متن بهقدر کافی ویرایش و مثالدار شده که سبکش عوض شده — که اتفاقاً همان متنی است که میخواهیم منتشر شود. پس منفی کاذبِ «متنِ ویرایششده» دردِ روز نیست؛ دردِ واقعی، متنِ ویرایشنشدهای است که اتفاقی رد شد و بدون بازبینی رفت.
نقطهٔ کور دوم فارسی است. به تجربهٔ ما بیشتر این ابزارها با متون انگلیسی ساخته و تنظیم شدهاند؛ برای فارسی هم مرجع آموزشی کمتر است و هم رسمالخط — نیمفاصله، «ی» و «ک» فارسی و رسمالخطهای متفاوت — کار را دشوارتر میکند. نمرهای که برای فارسی میدهد سندِ کمتری پشتش دارد؛ مثل معلمی که همهٔ عمرش امتحان انگلیسی گرفته و حالا با همان ترازو فارسی نمره میدهد.
جمعبندی این بخش: برای فارسی، فاصلهٔ «عدد» تا «حقیقت» از انگلیسی هم بیشتر است؛ پس وزنِ بازخوانی انسانی سنگینتر. نمرهٔ پایین، صفحهٔ شما را از بررسی معاف نمیکند و نمرهٔ بالا، آن را به انتشار نهایی نمیرساند.
به چه اعتماد کنیم و به چه نه؟
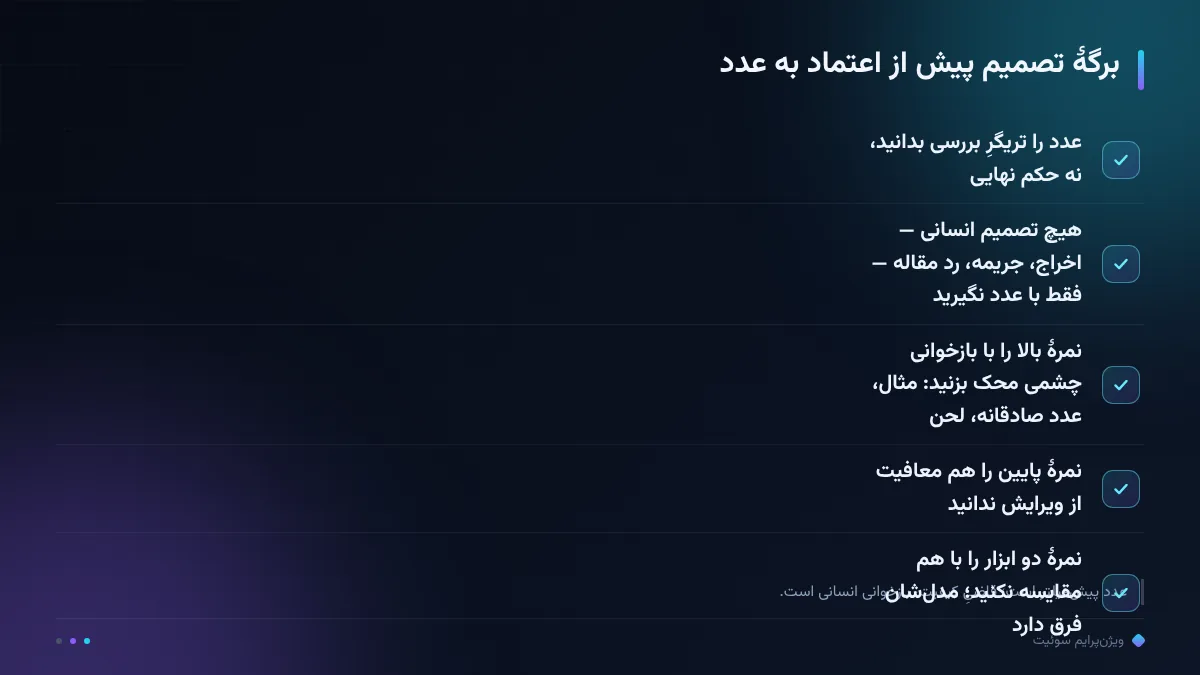
پس کجا این ابزار مفید است؟ در مقیاس. وقتی دهها صفحهٔ قدیمی و ناشناس در سایت دارید و میخواهید بدانید بازخوانی را از کجا شروع کنید، عددِ تشخیص یک ترتیبدهندهٔ کار است: صفحههای نمرهبالا را اول ببرید سرِ بازخوانی انسانی. اما در تکمقالهای که خودتان نوشتهاید، همان عدد بیشتر اضطراب میسازد تا کار. برگهٔ تصمیمِ همین بخش را کنار دست بگذارید:
مهمترین سطرِ برگه، سطر دوم است: تصمیم انسانی بر پایهٔ یک عددِ احتمالی هم بیانصافی است هم بیدوام — فردا همان متن با ابزار دیگر نمرهٔ دیگری میگیرد. به تجربهٔ ما نمرهٔ دو ابزار را هم نباید با هم قضاوت کرد؛ مدلشان فرق دارد و هر عدد فقط داخل همان ابزار معنا دارد، مثل قدِ دو نفر که با دو مترِ کالیبرهنشده گرفته شده باشند.
گوگل چه میگوید؟ عددِ تشخیصگر ملاک نیست
پرسش طبیعی است: گوگل خودش چه میگوید؟ حرف رسمی گوگل — که در راهنمای آپدیتهای هسته هم تکرار میشود — این است که پاداش به کیفیت کلی محتوا داده میشود، نه به روش ساخت آن؛ راهحل اختصاصی برای آپدیتها معرفی نمیشود و بازگشت هم میتواند ماهها طول بکشد (تاریخ گردآوری: آبان ۱۴۰۵). در همین چارچوب، «درصدِ ابزار تشخیص» هیچ نقش رسمیای ندارد؛ گوگل روش تولید را نمیپرسد، پاسخگویی به خواننده را میسنجد.
ترجمهٔ عملی برای صاحب سایت: نه عدد ابزار را سنجهٔ سئو بگذارید، نه برای «فرار از عدد» متن را بیویرایش رها کنید. مسیر وسط همان است که مقالهٔ موضع گوگل با تشبیه آبدارخانه باز کرده: مشتری مزه را میچشد، نه روشِ فشردن آبمیوه را — اما آبِ شربتشده را دفعهٔ بعد پس میزند. کیفیت، همان مزهٔ قابل چشیدن است.
پس عدد تشخیصگر نه سنجهٔ گوگل است، نه سنجهٔ خواننده؛ فقط یک پیشفیلتر داخلی است. وقتی در جای واقعیاش بنشیند مفید است؛ وقتی قاضی شود، متن سالم را متهم و متن بیروح را تبرئه میکند — هر دو اشتباه، برای سایت خرج دارد.
جایگزین عملی؛ گیت کیفیت و بازخوانی انسانی
جایگزین عملی، برگشتن به گیت کیفیت است — همان چیزی که سوئیت پیشفرض اجرا میکند: پلتفرم با گیت کیفیت ۳۰ مرحلهای و بازبینی انسانی پیش از انتشار؛ عدد هیچ ابزاری جای این بازخوانی را نمیگیرد. محکهایش چشمیاند: مثال واقعی، عدد صادقانه، لحن مالک و پاسخ به پرسش واقعی مشتری — پنج خطای پرتکرارِ خروجی فارسی را هم با همین محکها میشود دید، نه با درصد.
نتیجهٔ تداوم چنین روندی در کیسهای ثبتشدهٔ سوئیت آمده است: در کیس ثبتشدهٔ سوئیت liuna، ده محتوا در سه ماه به ۲۸۶ صفحهٔ اول رسید — همراه با اعتراف صادقانهٔ خودمان که «فروشگاه بودیم نه آژانس». و بعد از انتشار، مقالهٔ پایش محتوای AI در طول زمان همان را ادامه میدهد: چهار سنجهٔ سرچکنسول و چرخهٔ بازبینی دورهای.
اگر تولید را برونسپاری میکنید، دو بند را در قرارداد صریح کنید: محک پذیرش، کیفیت چشمی و چکفهرست است — نه درصدِ ابزار تشخیص — و بازخوانی انسانی پیش از انتشار اجباری است. ممیزی رایگان دامنه هم نقطهٔ شروع بیهزینه است تا ببینید وضعیت فعلی متنهای سایتتان کجاست.
جمعبندی؛ سه جملهای که با خود ببرید
سه جمله را با خود ببرید: ابزار تشخیص داور سبک است، نه بازجو؛ خروجیاش احتمال است، نه سند. مثبت و منفی کاذب واقعیاند و برای فارسی فاصلهٔ عدد تا حقیقت بیشتر است. و عدد فقط تریگرِ بررسی است؛ قاضی، بازخوانی انسانی با محکهای کیفیت — مثال، عدد صادقانه و لحن مالک.
یک یادآوری آخر برای تیمهای محتوا: هیچ عددی جای سؤال «این متن به خوانندهٔ ما چه کمکی میکند؟» را نمیگیرد. ابزار تشخیص را در جای پیشفیلتر بگذارید، بازخوانی انسانی را نگه دارید و بودجه را به همین سؤال خرج کنید؛ بقیهٔ اعداد، کمکیاند نه اصلی.
رصد ما، رشد شما.
سؤالات پرتکرار
عدد ابزار تشخیص متن AI قابل استناد است؟
بهعنوان نشانهٔ اولیه برای شروع بازخوانی بله، بهعنوان حکم قطعی نه؛ خروجی این ابزارها برآورد احتمال است و به تجربهٔ ما نباید تنها مبنای تصمیم انسانی مثل برخورد با نویسنده بشود.
چرا متن انسانی هم گاهی «تولیدشده با AI» علامت میخورد؟
چون ابزار سبک را میسنجد نه سند و تاریخچه را؛ متن رسمی، ترجمهٔ یکدست یا نثر کتابوار با همان الگوهای آماری همخوان میشود — این مثبت کاذب است، نه مدرک تقلب.
این ابزارها برای فارسی هم دقیقاند؟
به تجربهٔ ما به همان اندازهٔ انگلیسی نیست؛ بیشتر این ابزارها با متون انگلیسی ساخته و تنظیم شدهاند و برای فارسی، رسمالخط و منابع مرجع کمتر، سندِ نمره را نازکتر میکند.
اگر ابزار متن من را مشکوک اعلام کرد چه کار کنم؟
به عدد واکنش نشان ندهید؛ متن را با محکهای کیفیت بخوانید — مثال واقعی، عدد صادقانه و لحن مالک. اگر اینها هست، عدد مشکوککننده نیست؛ اگر نیست، مشکل کیفیت است نه ابزار.
سوئیت با محتوای کمکی چه میکند؟
گیت کیفیت ۳۰ مرحلهای و بازبینی انسانی پیش از انتشار: بریف زمینهدار، چک ادعاها و محکهای چشمی؛ عدد هیچ ابزاری جای این بازخوانی را نمیگیرد. جزئیات در دموی رایگان پلتفرم آمده است.