پانزده اشتباه رایج در دادهٔ خصوصی و مدلهای عمومی و راهحل هرکدام
خانوادهٔ همین بحث را لایهبهلایه بچینیم: پانزده اشتباه رایج در پرامپت تولید محتوا نحوهٔ نوشتن پرامپت را درست میکند و خطاهای AI در محتوای تخصصی و راهحل هرکدام خطاهای متن را پیش از انتشار میگیرد؛ این مقاله یک قدم جلوتر میایستد و مرز ورودی را میبندد — چه دادهای اصلاً وارد ابزار عمومی نمیشود و چه کاری را باید بیرون ابزار انجام داد. اگر آن دو مقاله کیفیت خروجی را میسازند، این یکی ریسک ورودی را مدیریت میکند.
چرا این مرز در تیمهای محتوا بهسادگی میشکند؟ چون ابزار عمومی در دسترسِ همه است، سریع جواب میدهد و پرامپت را هم برچسب «آزمایشی» میزند؛ اما دادهای که در یک پرامپت آزمایشی میچسبد، همان دادهای است که قرارداد، گزارش مالی یا فهرست مشتری نام دارد. به تجربهٔ ما حل مسئله با آموزش عمومی ممکن نمیشود؛ با فهرست مکتوب و گیت کوتاه ممکن میشود.
دادهٔ خصوصی و مدلهای AI؛ مرز امن کجاست؟
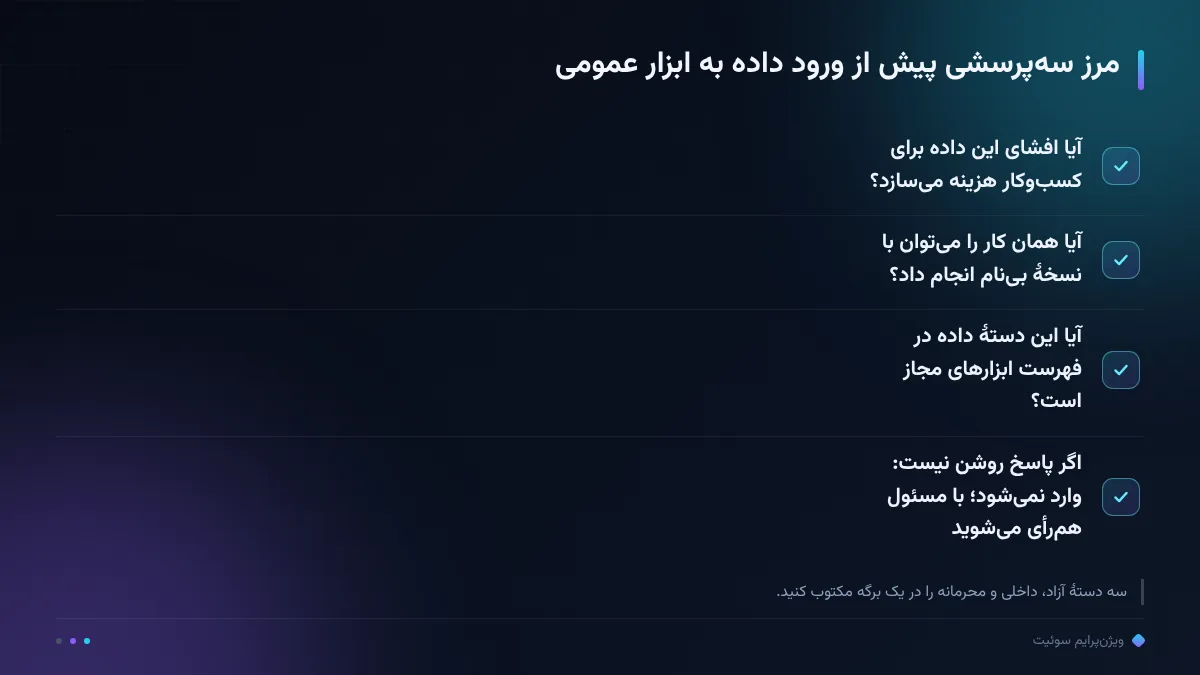
تعریف ما از دادهٔ خصوصی عملیاتی است، نه حقوقی: هر اطلاعاتی که افشا یا انتقالش برای کسبوکار هزینه میسازد — اعتماد مشتری، مزیت رقابتی، قرارداد یا مسائل قانونی. مدل عمومی هم سرویسی است که ورودی را برای پردازش در زیرساخت مشترک میبرد و چرخش نگهداشت ورودیها در آن شفاف و پایدار نیست و به سرویس، نسخه و شرایط قراردادی بستگی دارد. وقتی یک سمتِ معادله نامعلوم است، قاعده روی سمت مشخص مینشیند: دادهٔ حساس وارد نمیشود.
این قاعدهٔ احتیاط را باید در جلسهٔ تیم صریح گفت، چون جایگزینهای آن — «فقط یکبار»، «کسی نمیبیند»، «ابزار معروف است» — همه دلیل نیستند؛ آرزو هستند. تصمیم درست این است که برای تیم یک مرز سهپرسشی تعریف کنیم و پانزده اشتباه رایج را کنار همان مرز مرور کنیم تا هر نفر پیش از چسباندن متن، خودش بتواند حکم بدهد.
یک تفکیک هم لازم است: بحث این مقاله با بحث رتبه و کیفیت محتوا یکی نیست. ممکن است ابزار عمومی متن خوبی هم بسازد و در همان فرایند، دادهای از سازمان بیرون رفته باشد؛ این دو نتیجه مستقل از هماند. پس تیمهایی که فقط کیفیت خروجی را میسنجند، لایهٔ ریسک ورودی را از قلم میاندازند و دقیقاً همانجاست که پانزده اشتباه پیش رو جا باز میکنند.
اشتباهات ۱ تا ۳؛ دادهای که خودش را معرفی نمیکند
اشتباه ۱، طبقهبندینکردن دادههاست؛ تیمی که «دادهٔ خصوصی» را تعریف نکرده، در عمل هیچ دادهای را خصوصی نمیبیند. راهحل، تعریف سه دسته در یک برگه است: آزاد (قابلانتشار)، داخلی (بدون نام و مبلغ) و محرمانه (هرگز وارد ابزار عمومی). اشتباه ۲، پیوستکردن فهرست مشتریان یا شمارههای تماس برای «شخصیسازی» متن است؛ شخصیسازی با دادهٔ بینام هم ممکن است، پس فهرست خام هیچوقت وارد پرامپت نمیشود. برای نامهنگاری دستهجمعی هم ابتدا نسخۀ بینام را ببندید و جای متغیرها را در سیستم ارسال پر کنید، نه در ابزار متننویس.
اشتباه ۳، چسباندن متن قرارداد — با نام طرفین و مبالغ — برای نوشتن یک پاسخ رسمی است. راهحل، جایگزینسازی است: قبل از چسباندن، نامها را «طرف اول» و مبالغ را «مبلغ قرارداد» کنید؛ ابزار به ساختار جمله نیاز دارد، نه به هویت طرفین. این سه اشتباه پرتکرارترینها هستند و راهحل هر سه در بیست دقیقه به تیم آموزش داده میشود؛ اگر جلسۀ آموزش یکبار فیلمبرداری و بایگانی شود، نفرات تازۀ تیم هم بدون استثنا وارد همان مرز میشوند.
اشتباهات ۴ تا ۷؛ اسناد و پرامپتهای آلوده
اشتباه ۴، ورود گزارش مالی یا صورت سود و زیان برای «تحلیل روندها» به ابزار عمومی است؛ همین کار با نسخهٔ بینام و نسبتیشده انجام میشود، نه با فایل اصلی. اشتباه ۵، پیشنویسگرفتن روی دادهٔ پرسنلی و حقوق کارکنان است؛ این دسته همیشه محرمانه است و هیچ ابزار عمومی بهانهٔ سرعت نمیشود. اشتباه ۶، ورود دادهٔ سلامت یا وضعیت تحصیلی مشتریان است که حساسیتش از هر چیز دیگر بالاتر است؛ برای این دادهها حتی خلاصهسازی هم ممنوع است، چون در نمونههای کوچک هم ترکیب چند فیلد، فرد را قابلشناسایی میکند.
اشتباه ۷، پرامپت آزمایشی با دادهٔ واقعی است؛ تیم فکر میکند چون «فقط تست است» ریسکی ندارد، در حالی که آزمایش، پرتکرارترین مسیر ورود داده است. راهحل، ساختن یک فایل دادهٔ ساختگی دائمی است: نامهای خیالی، مبالغ گرد، اعداد صحنهسازیشده. تیم با همان فایل آزمایش میکند و میراث آزمایشهایش هم پاک میماند. این فایل را کنار برگۀ سهدستگی داده نگه دارید؛ آن دو با هم، جعبهآزمایش امنِ تیماند.
اشتباهات ۸ تا ۱۱؛ خروجی و دسترسی تیمی
اشتباه ۸، تصور اینکه پاککردن گفتگو یعنی پاکشدن کامل ردپا است؛ ما قاعده را بر پایهٔ احتیاط میچینیم، نه بر پایهٔ ادعایی دربارهٔ رفتار داخلی سرویسها: اگر نمیدانیم چیزی کجا میماند، وارد نمیکنیم؛ برای پرامپتهای حساس هم همان قاعدۀ آزمایشی با دادهٔ ساختگی کافی است، نه اتکا به حذف تاریخچۀ گفتگو. اشتباه ۹، کپیکردن خروجی بدون بازبینی است؛ ابزار عمومی دربارهٔ خودِ شرکت شما هم میتواند جملهٔ نادرست و ساختگی بسازد و اگر آن جمله وارد صفحه شود، خودش دادهٔ غلط منتشرشده است.
اشتباه ۱۰، انتشار خروجی با صدای برند بدون گیت انسانی است؛ پیش از انتشار، متن باید از بازبینی انسانی بگذرد تا ادعا، عدد و لحن مسؤولانه چک شود؛ چکلیست گیت کیفیت محتوای هوش مصنوعی همین گیت را چکلیستی کرده است. اشتباه ۱۱، حساب اشتراکی تیمی است که ورودیهای همه را در یک جعبه میریزد و بعد از هر اتفاق، هیچکس نمیتواند بگوید چه دادهای رفته است؛ راهحل، حساب تفکیکشده و ثبت سادهٔ پرامپتهای حساس است.
اشتباهات ۱۲ تا ۱۵؛ نبود قاعدهٔ مکتوب
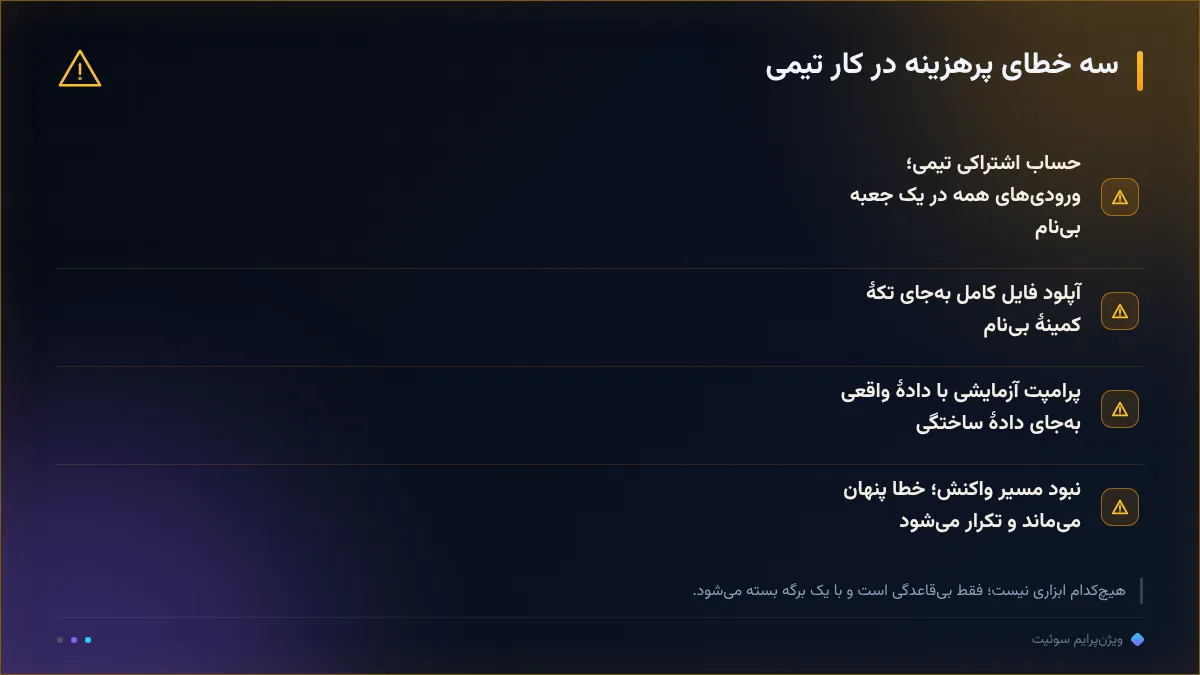
اشتباه ۱۲، نبود فهرست ابزارهای مجاز است؛ هر همکار ابزار دلخواه خودش را برمیدارد و مرز تیم، عملاً ناموجود میشود. راهحل یک برگهٔ دوستونه است: کدام ابزار برای کدام دستهٔ داده مجاز است و کدام ممنوع؛ فهرست بدون دستهٔ داده، نصفوبیکار است. اشتباه ۱۳، بیتفاوتی به نسخه و شرایط سرویس است؛ سرویسهای عمومی و سازمانی شرایط متفاوتی دارند و تیم باید بداند با کدام کار میکند و چه چیزی در قراردادش آمده است.
اشتباه ۱۴، آپلود فایل کامل وقتی فقط تکهٔ بینام لازم است؛ اسکرینشات پنل مدیریت یا فایل کامل CSV، بیست فیلد اضافه با خود میبرد. قاعده: کمینهسازی — فقط همان ستون و همان چند سطر بینام. اشتباه ۱۵، نبود مسیر واکنش است؛ اگر یکبار دادهای جایی رفت که نباید برود، تیم باید بداند به کی بگوید، چه چیزی را ثبت کند و چه اقدامی لازم است. بدون این مسیر، خطا پنهان میشود و تکرار میشود؛ با این مسیر، همان یک اتفاق تبدیل به برگۀ آموزشی تیم میشود.
سه لایهٔ دفاعی که این اشتباهات را میبندد
این پانزده اشتباه را میشود با سه لایهٔ دفاعی ساده بست. لایهٔ اول، طبقهبندی: برگهٔ سهدستهای که در اشتباه ۱ آمد، همراه با سه پرسش روشن — آیا افشایش هزینه دارد؟ آیا میتوان بینام گفت؟ آیا در فهرست مجاز است؟ لایهٔ دوم، جایگزینسازی و کمینهسازی: نامها، مبالغ و فیلدهای اضافه پیش از ورود حذف میشوند و آزمایش همیشه با دادهٔ ساختگی انجام میشود. این دو لایه پیش از پرامپت عمل میکنند؛ اگر اجرا شوند، هیچ پرامپتی دادهٔ خطرناک در دست ندارد.
لایهٔ سوم، گیت انتشار و مسیر واکنش است: هیچ خروجی ابزار عمومی بدون بازبینی انسانی منتشر نمیشود و مسیر گزارش خطا از قبل مکتوب است. این سه لایه به فرایند محتوای شما وزن اضافه نمیکند؛ فقط مرزهای داخل همان فرایند را مکتوب میکند. نقش هر مقالهٔ فنی و هر برگهٔ آموزشی هم این است که این مرزها را برای نفر تازهوارد قابلفهم نگه دارد؛ مرزی که در مدرک نیست، در عمل هم نیست.
جمعبندی؛ قاعدهٔ احتیاط، نه اتکا به استثنا
جمعبندی: پانزده اشتباه، یک قاعدهٔ واحد — دادهای که افشایش خسارت میسازد، بیمرز وارد ابزار عمومی نمیشود. سه دستهٔ داده را مکتوب کنید، فایل آزمایشی بسازید، فهرست ابزارهای مجاز را ببندید، گیت بازبینی را سرِ جای خودش بگذارید و مسیر واکنش را از امروز تعریف کنید. به تجربهٔ ما تیمی که این پنج برگهٔ کوچک را دارد، بدون کندشدن تولید، از پانزده اشتباه فاصله میگیرد. اجرا هم را از همین هفته شروع کنید: برگۀ دستهبندی در جلسۀ بعد، فایل آزمایشی در همان روز، بقیه پلهپله.
اگر میخواهید وضع فعلی فرایند محتوا و کیفیت انتشار دامنهتان را قبل از بستن این مرزها ببینید، ممیزی رایگان دامنه نقطهٔ شروع خوبی است و اجرای همین گیتها در چرخهٔ تولید، بخشی از پلتفرم تولید محتوای سوئیت است؛ نقشۀ کامل بحث ابزارها هم در هاب هوش مصنوعیها برای محتوا مرتب است. مرز داده، مثل چراغ جلو است: کار تولید را کند نمیکند؛ فقط مسیر را میبیند.
رصد ما، رشد شما.
سؤالات پرتکرار
دادهٔ خصوصی دقیقاً یعنی چه چیزی؟
در عمل، هر دادهای که افشایش برای کسبوکار هزینه بسازد: فهرست مشتریان، قرارداد، گزارش مالی، دادهٔ پرسنلی و اطلاعات سلامت یا تحصیل. برگهٔ سهدستهای مقاله همین مرز را برای تیم مکتوب میکند.
حذف گفتگو در ابزار عمومی ریسک را صفر میکند؟
قاعدهٔ ما بر پایهٔ احتیاط است، نه ادعای فنی دربارهٔ سرویسها: اگر چرخش نگهداشت ورودیها شفاف و پایدار نیست، دادهٔ حساس اصلاً وارد نمیشود. حذف گفتگو بهانهٔ ورود دادهٔ محرمانه نیست.
برای آزمایش پرامپت چه دادهای استفاده کنیم؟
یک فایل دادهٔ ساختگی دائمی با نامهای خیالی و مبالغ گرد بسازید و همهٔ آزمایشها را با همان فایل انجام دهید. دادهٔ واقعی حتی «فقط یکبار» وارد پرامپت آزمایشی نمیشود.
ابزارهای سازمانی مشکل را حل میکنند؟
شرایط سرویسهای سازمانی متفاوت است و باید در قرارداد خودتان خوانده شود؛ به تجربهٔ ما سادهتر و امنتر این است که قاعدۀ پیشفرض تیم «دادهٔ محرمانه وارد ابزار عمومی نمیشود» بماند و استثناها با نظر مسئول تصمیم باز شود.
اگر دادهای اشتباهی وارد ابزار شد چه کنیم؟
مسیر مکتوب را اجرا کنید: ثبت رویداد با تاریخ و محتوای تقریبی، اطلاع به مسئول، و بررسی اینکه آیا داده به جایی منتشر شده است یا نه. هدف جلوگیری از تکرار است، نه سرزنش.