چطور معیار کیفیت محتوای AI را درست سنجش کنیم؟
مصاحبهای که در تیمهای محتوا تکرار میشود: پیشنویسی از مدل زبانی میآید، شیرین و مرتب است، همه تأیید میکنند؛ دو ماه بعد معلوم میشود ویژگیای که در معرفی محصول نوشته شده در کاتالوگ وجود نداشته و سه بند هم کپیِ چیدمان صفحهٔ رقیب بوده. هیچکس در جلسهٔ تأیید «غلط» ندیده بود؛ چون همه فقط «روانی» را دیده بودند.
این مقاله راهحل را در مالکیتِ معیار میداند، نه در بیاعتمادی به ابزار: تیمی که معیار مکتوب و چکلیستمحور دارد، از هوش مصنوعی سرعت میگیرد؛ تیمی که ندارد، از آن ریسکِ سرعت میگیرد. نقشهٔ کامل موضوع در هاب محتوای هوش مصنوعی با گیت کیفیت است؛ اینجا سنجهها، چکلیست پذیرش و مسیر تبدیل معیار به فرایند میآید.
چرا «روان بودن» معیار پذیرش محتوا نیست؟
مدلهای زبانی برای «پذیرفتنی بودن» آموزش دیدهاند، نه برای «درست بودن»؛ جملهٔ روانی که مرجع ندارد با همان اعتمادبهنفسِ جملهٔ مستند تولید میشود. انسانِ خستهٔ آخر روز هم همینطور خواندن میکند: چشم از روانی سیر میشود و غلطِ روان، نامرئی میماند. ترکیب این دو، خطای رایج اتاق محتوا است: نویسندهای که متنِ تولیدی را «خوب نوشته شده» میداند چون خودش خسته است و متن روان است.
دو مثال واقعی که بارها دیدهایم: معرفی محصول با قابلیتی که در کاتالوگ نیست — مدل از الگوی «سایتهای مشابه» حدس زده — و آمار بیمنبع در بند دوم که در شبکهها دستبهدست میشود. هر دو متن رواناند؛ هر دو در آزمون دقت میافتند. پس سنجش را باید از روانی جدا کرد و به گروههای مستقل سپرد.
معیار مکتوب یک فایدهٔ پنهان هم دارد: بحث جلسه را عوض میکند. وقتی آستانهٔ پذیرش روی کاغذ است، گفتوگو از «من خوشم آمد» به «بند چهار چکلیست نه خورده» جابهجا میشود؛ سلیقهها محترم میمانند اما حکم را عددِ چکلیست میدهد.
معیار کیفیت محتوای AI در چهار گروه
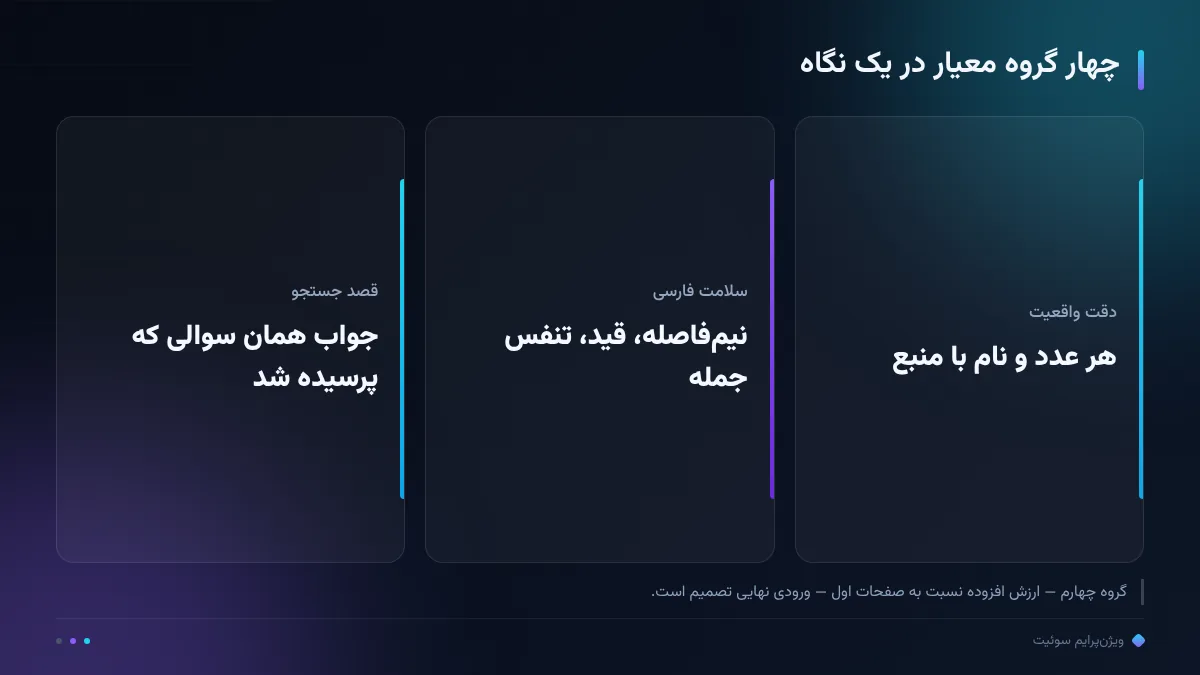
چهار گروه معیار، چهار پرسش مستقل از یک متن هستند. گروه اول، دقت واقعیت: هر ادعا، عدد و نام، با کاتالوگ یا منبع بیرونی میخواند؟ گروه دوم، سلامت فارسی: نیمفاصله، قیدهای ترجمهای و جملههای دراز، متن را بومی کردهاند یا زدهاند؟ گروه سوم، همخوانی با قصد جستجو: صفحه به همان سوالی جواب میدهد که جستجوکننده پرسیده؟ گروه چهارم، ارزش افزوده: نسبت به صفحات اولِ همین کلمه، چه چیزی اضافه میکند — تجربه، مثال بومی، جدول کاربردی؟
استقلال گروهها مهم است؛ متنِ دقیق اما بیقصد، مثل متنِ روان اما غلط، رد میشود. در ممیزیهایمان سایتهایی دیدهایم که محتوایشان بیخطا بود و ترافیک نداشت، چون هیچوقت به سؤال واقعی جستجوکننده جواب نمیداد. چهار گروه را جدا نمره دهید تا ضعفِ هر گروه، پشت گروه دیگر پنهان نشود.
وزن گروهها هم به نوع صفحه بستگی دارد: در محتوای محصول، دقتِ کاتالوگمحور سنگینترین است؛ در مقالهٔ آموزشی، قصد جستجو و ارزش افزوده جلو میافتند. معیار ثابتِ بیوزن، مثل ترازویی است که فقط کیلوگرم میخواند و از حجم غافل است.
چکلیست دوازدهعایتهای سنجش
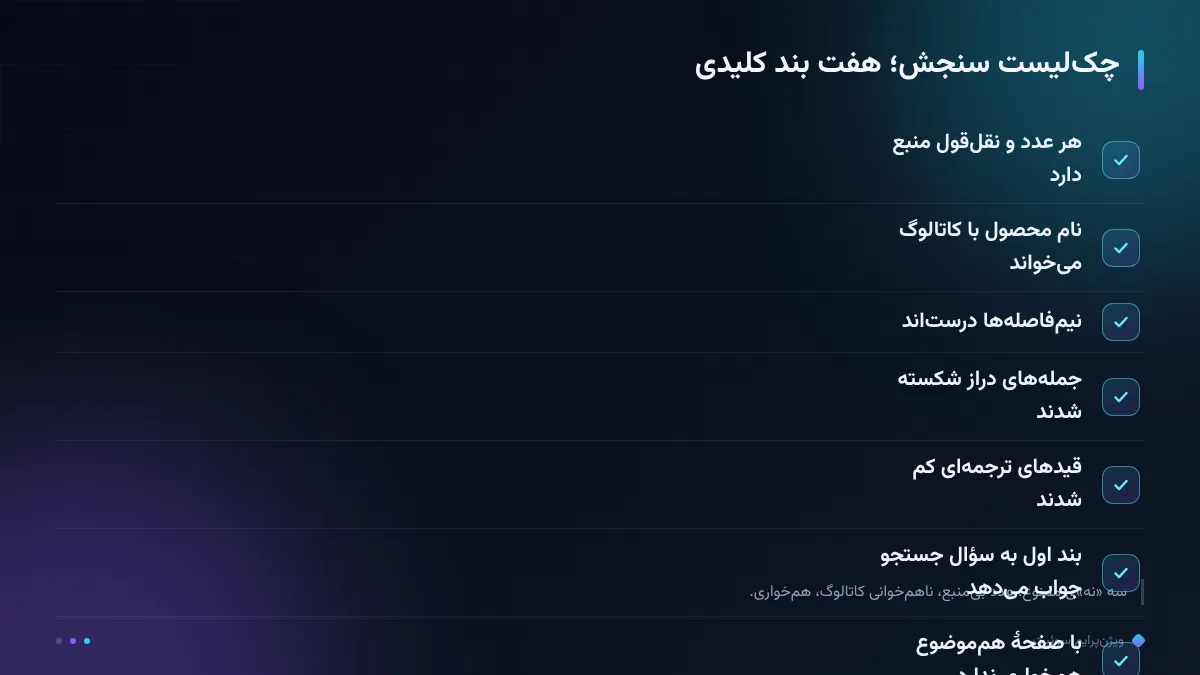
چکلیست عملیاتی ما دوازده بند دارد؛ نسخهٔ کوتاهشدهاش در اینفوگرافیک کنار متن است و شرح نمرهدهی اینجا. هر بند «بله» یا «نه» میگیرد؛ سه «نه»ی ممنوع داریم: عدد بیمنبع، نام محصولِ ناهمخوان با کاتالوگ و همخواری با صفحهٔ موجود. یکی از این سه یعنی رد، بیچونوچرا؛ در بقیهٔ بندها، دو «نه» یعنی برگشت به بازبینی انسانی با یادداشتِ مشخص.
چکلیست را به تولید انبوه هم وصل کنید؛ در تولید انبوه محتوا با کنترل کیفیت نشان دادهایم که در مقیاس روزانه، تنها سپرِ واقعی همین بندهای ثابتاند، چون بازبینیِ تکبهتکِ هر متن ممکن نمیشود. الگوی ما: خودآزمایی تولیدکننده روی همین دوازده بند، بعد نمونهگیری تصادفی بازبین — مثلاً از هر ده متن، دو تا کامل — و بازبینی کامل برای متنهای کلمههای حساس مثل قیمت و مقایسه.
یک قاعدهٔ نگهداری هم بگذارید: چکلیست زنده است. هر بار که خطای تازهای از تولید بیرون درز کرد — فارسیِ شکسته، ادعای تازه، الگوی تکراری — بندش را اضافه کنید. چکلیستی که سال نشده، یا بچه است یا مرده.
آزمون دقت؛ هر عدد باید منبع داشته باشد
آزمون دقت را با قاعدهٔ «هر عدد منبع دارد» اجرا کنید؛ ادعای بیمنبع سه راه دارد: حذف، بازنویسی به «به تجربهٔ ما ... چون»، یا جایگزینی با منبع واقعی و قابل راستیآزمایی. ادعاها را هم سه لایه ببینید: واقعیتهای ثابت فنی که منبع عمومی دارند؛ آمارهای بیرونی که باید نام منبع و تاریخ گردآوری کنارشان باشد؛ و تجربههای برند که فقط با شواهد خودتان — کیس، دادهٔ سرچکنسول — گفته میشوند.
سختترین نقطه، آمار دروغِ معقول است؛ عددی که «شبیه واقعیت» ساخته میشود تا بند قشنگتر شود. قاعدهٔ ما بیرحمانه است: آماری که منبعش را نتوانید فردا در جلسه نشان دهید، امشب حذف میشود. این قاعده سخت است اما هر استثنایی که بدهید، سیاست تولیدتان به «گاهی ساختنی» تغییر میکند.
برای نامها و ویژگیها هم همین آزمون هست: نام محصول، پلن و قیمت را با کاتالوگ خطبهخط بخوانید. در محتوای سئو که اغلب ماهها بعد از تولید خوانده میشود، ناهمخوانی با کاتالوگ، اعتباری است که در متن نمیآید اما در ذهن خریدار میماند.
آزمون فارسی؛ نیمفاصله، قید ترجمهای و جملهٔ دراز
آزمون فارسی سه سنجهٔ سرراست دارد. نیمفاصله: «پیشبینی» و «میشود» باید نیمفاصله بمانند، نه فاصلهٔ تمام؛ مدلها در اینجا بیثباتاند و متنِ انبوه، خطاها را جمع میکند. قیدهای ترجمهای: «کاملاً»، «عملاً»، «در واقع» و «نکتهٔ قابل ذکر» نشانهٔ ترجمهاند؛ در بازنویسی، یا حذف میشوند یا با قید بومی جایگزین. جملهٔ دراز: جملههای بالای سهچهار خط را بشکنید؛ روانیِ فارسی در تنفس جمله است، نه در پیچیدگی آن.
فراتر از این سه، لحن هم سنجیده میشود: متن تولیدی به «شما»ی بینشان و فعلهای رسمیِ قالبی تمایل دارد؛ خوانندهٔ فارسیزبان همینجا حس «ترجمهبودن» میگیرد. بازنویسی بومی — از انتخاب مثال تا استعارهٔ قابلفهم بازار ایران — موضوع مقالهٔ فارسیسازی محتوای هوش مصنوعی است؛ آن مقاله روش بازنویسی را میگوید، اینجا سنجهٔ پذیرشش: آیا متن خوانده میشود مثل نوشتهٔ کسی که این بازار را دیده؟
یک آزمون میدانی هم به تیمها میدهیم: بند اول را بلند بخوانید. اگر نفستان بُرید یا جمله را دو بار بخوانید تا معنی بگیرد، همان بند بازنویسی میشود؛ آزمون ارزان است و اکثر متنهای «فارسیِ آهنگین» را همان ابتدا میگیرد.
آزمون قصد جستجو و یکتایی
آزمون قصد جستجو با SERP واقعی شروع میشود، نه با حدس: کلمه را جستجو کنید، صفحهٔ اول را بخوانید و بپرسید جستجوکنندهٔ این صفحه چه سوالی داشته و متن ما همان را جواب میدهد؟ متنِ درستِ سوالی دیگر، در بهترین حالت خواندنی و بیترافیک است؛ در بدترین حالت، رتبه نمیگیرد چون به سیگنالهای تعامل هم نمیرسد.
یکتایی نیمی دیگر از این آزمون است: متن تازه با صفحههای موجودِ خودتان قیاس میشود تا همخواری از پیش بسته شود. ساختار h2 را هم با قالب کپیشده مقایسه کنید؛ چیدمان یکسانِ ده مقاله، هم تجربهٔ خواننده را میکُشد هم سیگنال تازگی را کم میکند. فرایند کامل انسانی — چه کسی، با چه ترتیبی، در چه عمقی — موضوع مقالهٔ بازبینی محتوای هوش مصنوعی است؛ آن مقاله فرایند بازبینی را میکاود و اینجا معیار پذیرش و ردِ همان فرایند.
برای قصد جستجو یک آزمون ساده دیگر هم بگذارید: عنوان را بپوشانید و فقط بدنه را بخوانید؛ اگر نمیتوانید حدس بزنید عنوان چه بوده، متن از سؤال دور افتاده. متن خوب با عنوانش همریخت است؛ خواننده در بند دوم باید بوی همان سؤال را بگیرد.
از معیار به فرایند؛ دروازهٔ پذیرش و بازبینی انسانی
معیار وقتی کار میکند که دروازه شود: تولید، خودآزمایی روی چکلیست، بازبینی انسانی تخصصی، انتشار. مسیر کامل کار — نقشها، ابزارها و ترتیب — در گردش کار محتوای هوش مصنوعی آمده؛ آن مقاله کل زنجیره را میسازد و اینجا دروازهٔ پذیرش همانجایی است که چکلیست این مقاله مینشیند. در پلتفرم سوئیت همین دروازه محصول شده است: گیت کیفیت سیمرحلهای کنار بازبینی انسانی اجرا میشود تا خروجی، استاندارد باشد نه خام.
برای تیمهای داخلی، پیام صادقانه این است: چکلیست هزینهٔ سرعت است و ارزش اعتماد. هر متن دو ده دقیقه سنجش بیشتر میخورد؛ در عوض، دامنهای نمیسازید که هر سه ماه یک بار به بازنویسی انبوه نیاز پیدا کند. در کیس ثبتشدهٔ سوئیت، ده محتوای گیتشده در سه ماه به ۲۸۶ صفحهٔ اول رسید — خروجی فرایند دروازهدار، نه حجمِ بیصافی؛ تعمیم بیشرطِ یک نمونه به هر صنعتی نمیکنیم اما الگو تکرارشدنی است.
اگر ترجیح میدهید این دروازه را برونسپاری کنید، معرفی کامل ویژنپرایم سوئیت نقطهٔ شروع است؛ پک محتوای سئو با همان گیت و بازبینی انسانی کار میکند و قیمتش در پک محتوا — ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله، با اشتراکی ۱۵٪ کمتر — مکتوب و بدون مذاکرهٔ پنهان است. برونسپاری دروازهدار، معمولاً ارزانتر از اپراتورِ دروازهبندِ داخلی است.
جمعبندی؛ نمرهٔ حداقلی برای انتشار
جمعبندی را در سه سطر ببندید: چهار گروه معیار — دقت، فارسی، قصد، ارزش افزوده؛ یک چکلیست زنده با سه «نه»ی ممنوع؛ و یک دروازهٔ پذیرش که هیچ متنی از کنارش عبور نکند. معیار کیفیت محتوای AI وقتی به مالکیت تیم درآید، هوش مصنوعی از تهدیدِ کیفیت به ابزارِ سرعت تبدیل میشود؛ وقتی درنمیآید، هر دو طرف زیانکارند.
برای شروع، سادهترین نسخه کافی است: همین چکلیست را در یک برگه پرینت کنید، سه متنِ این هفته را با آن بسنجید و جوابها را کنار هم بگذارید. همان سه متن نشان میدهد ضعف تیم در کدام گروه است؛ اگر همه در فارسی میافتند، نویسنده نمیخواهید، بازنویسی بومی میخواهید؛ اگر همه در دقت، گیتِ منبع را سختگیرانهتر کنید.
حرف آخر برای مدیر محتوا: معیار را بنویسید، حتی ناقص. چکلیستِ مناقصهخورده و رشدکننده، از حافظهٔ طلاییِ نویسندهٔ باتجربه سالمتر است؛ حافظه با آدمها میرود، چکلیست میماند. و متنهایی که از این دروازه رد میشوند، دیگر لازم نیست «تولید هوش مصنوعی» معرفی شوند؛ محتوااند — نقطه.
سفارش پک محتوای سئو
پک محتوا — ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله (اشتراکی ۱۵٪ کمتر)
سفارش پک محتوای سئورصد ما، رشد شما.
سؤالات پرتکرار
ابزار آنلاین نمرهٔ کیفیت محتوای تولیدی میدهد؛ کافی است؟
ابزارها روانی و ساختار را میسنجند اما دقت واقعیت و همخوانی با بازار فارسی را قضاوت نمیکنند. نمرهٔ ابزار ورودی است؛ حکم با بازبینی انسانیِ چکلیستمحور میآید.
چند «نه» در چکلیست یعنی رد؟
قاعدهٔ ما: یک «نه» در سه بند ممنوع — عدد بیمنبع، نام محصول ناهمخوان با کاتالوگ و همخواری — یعنی رد. در بقیهٔ بندها دو «نه» یعنی برگشت به بازبینی. آستانه را مکتوب کنید تا سلیقهمحور نشود.
محتوای تولیدی چقدر باید بازنویسی انسانی شود؟
به نمرهٔ چکلیست بستگی دارد نه درصد ثابت؛ متنی که در دقت و فارسی قبول است، با بازبینی نوری و افزودن تجربهٔ واقعی برند قابل انتشار میشود. درصد ثابتِ از پیش تعیینشده، هزینهٔ بیهدف میسازد.
این معیارها برای محتوای محصول هم کار میکند؟
ستونها یکی است اما وزنها فرق میکند: در محتوای محصول، دقت با کاتالوگ وزن سنگینتر دارد و همخوانی با سؤال خریدار مهمتر از بلند بودن متن. وزن هر گروه را به نوع صفحه وصل کنید.
چطور از یکسانشدن سبک مقالهها جلوگیری کنیم؟
برای هر خوشه یک نمونهٔ مرجع انسانی تعریف کنید و در بازبینی، متن را با آن بخوانید؛ ساختار h2 را هم از قالب کپیشده خارج کنید. تکرارِ چیدمان، نشانهٔ تولیدِ بدون بازبینی است.