آموزش گامبهگام صفحات تکراری و کانونی؛ از تشخیص تا تصمیم
به تجربهٔ ما در ممیزیهای فنی، صفحات تکراری تقریباً همیشه حاضرند؛ منبعشان هم بهندرت یک اشتباه آگاهانه است، معمولاً رفتار عادی سیستم است: افزونهای پارامتر میسازد، قالب نسخهٔ چاپی میدهد، دستهها با شرح مشابه ساخته میشوند. مشکل این است که هیچکدام خودشان را اعلام نمیکنند؛ تکرار ساکت رشد میکند و سیگنالها را پخش میکند تا روزی که در گزارش پوشش سر باز کند.
لایهبندی با خواهرش را صریح بگوییم: معنا و اجرای تگ کانونی — خودارجاع، آدرس مطلق، سناریوها و خطاهای تگ — در آموزش کانونیسازی باز شده است؛ اینجا سمت تشخیص و تصمیم هستیم: تکرار را از کجا پیدا کنیم و برای هر مورد کدام خروجی را انتخاب کنیم. وقتی تصمیم نهایی ادغام شد، پروتکل ششقدمیاش در ادغام مقالههای مشابه آماده است؛ این متن جاده است، آن دو ایستگاههای میانی.
تکرار از کجا میآید؛ منابع رایج
منابع تکرار را به دو دستهٔ فنی و محتوایی تفکیک کنید، چون درمانشان فرق دارد. دستهٔ فنی، همان آدرسهای چندگانهٔ یک محتوا است: پارامترهای ردیابی مثل utm، پارامترهای مرتبسازی و صفحهبندی، نسخهٔ چاپی، تفاوت پروتکل و www و اسلش انتهایی و گاهی کپی سایت روی زیردامنهٔ آزمایشی که فراموش شده بسته شود. اینها محتوایشان عیناً یکی است و ابزار تشخیص، سریع پیدایشان میکند.
دستهٔ محتوایی ظریفتر است: دو دستهبندی با شرح یکسان، صد محصول با توضیح سازندهٔ مشترک، دو مقاله که برای یک قصد نوشته شدهاند و کمکم همپوشان شدهاند. اینجا هیچ آدرس مشابهی در کار نیست؛ شباهت در متن و قصد است. به تجربهٔ ما دستهٔ دوم خسارت بیشتری میزند، چون صفحهها واقعاً رقیب هم میشوند و هیچ تگ پیشفرضی هم جلویشان را نگرفته است. تکرار URL و تکرار محتوایی دو چهرهٔ یک مشکلاند؛ دو دسته را در فهرست تشخیص جدا نگه دارید تا مسیر تصمیم هرکدام درست برود.
چهار راه تشخیص صفحات تکراری
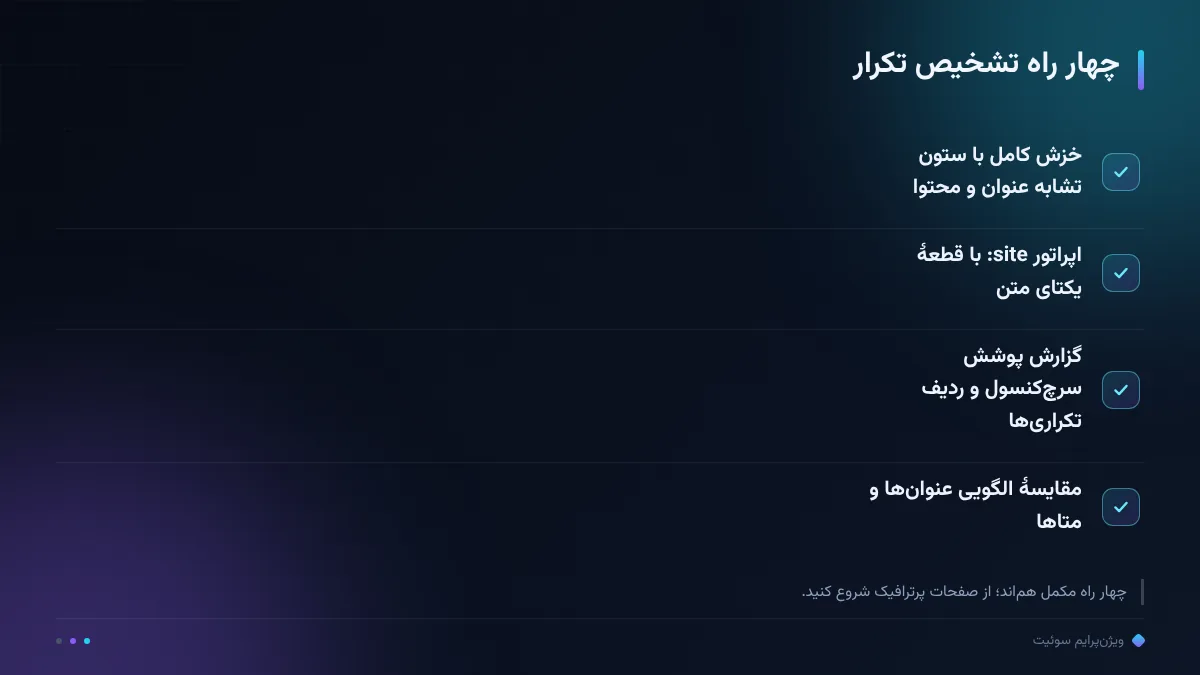
راه اول، خزش کامل با ابزار خزنده است: کل دامنه را بخزید و ستون تشابه عنوان و محتوا را مرتب کنید؛ جفتهایی که بالای جدول میآیند، کاندیداهای اصلیاند. راه دوم، اپراتور site: در جستجو با یک قطعهٔ یکتای متن است — عبارتی را که فقط در آن محتوا هست بین گیومه جستجو کنید و ببینید چند آدرس متفاوت همان جمله را برگردانند؛ روشی ارزان و سریع برای نمونهگیری. راه سوم، گزارش پوشش سرچکنسول است که نسخههای تکراری را تفکیک میکند و اگر تگ کانونی هم ثبت شده باشد، وضعیتش را کنارش نشان میدهد.
راه چهارم، مقایسهٔ الگویی است: عنوانها و توضیحهای متا را در خروجی خزش کنار هم بگذارید؛ الگوهای شبیه مثل «خرید X | فروشگاه» در ده آدرس، جای مهمی را برای بررسی روشن میکند. قاعدهٔ اجرایی ما این است که چهار راه را همیشه با هم استفاده کنید، نه یکی بهجای بقیه؛ خزش جزئیات میدهد، سرچکنسول دید موتور میدهد و اپراتور site: واقعیت فهرستشده را. و از صفحات مهم شروع کنید: صفحاتی که ترافیک و لینک دارند، اولویت بازبینیاند، نه صفحات آرشیوی.
خروجی این مرحله یک فهرست زنده است، نه یک یادداشت پراکنده: هر ردیف آدرسها، روش کشف، نوع تکرار — فنی یا محتوایی — و تاریخ کشف را نگه میدارد. همین سند است که در بخش تصمیم به درخت تصمیم خوراک میدهد و ماهها بعد، مرجع پایش خواهد بود؛ فهرست بیسند، درمان بیحافظه میسازد.
درخت تصمیم؛ چهار خروجی برای هر تکرار
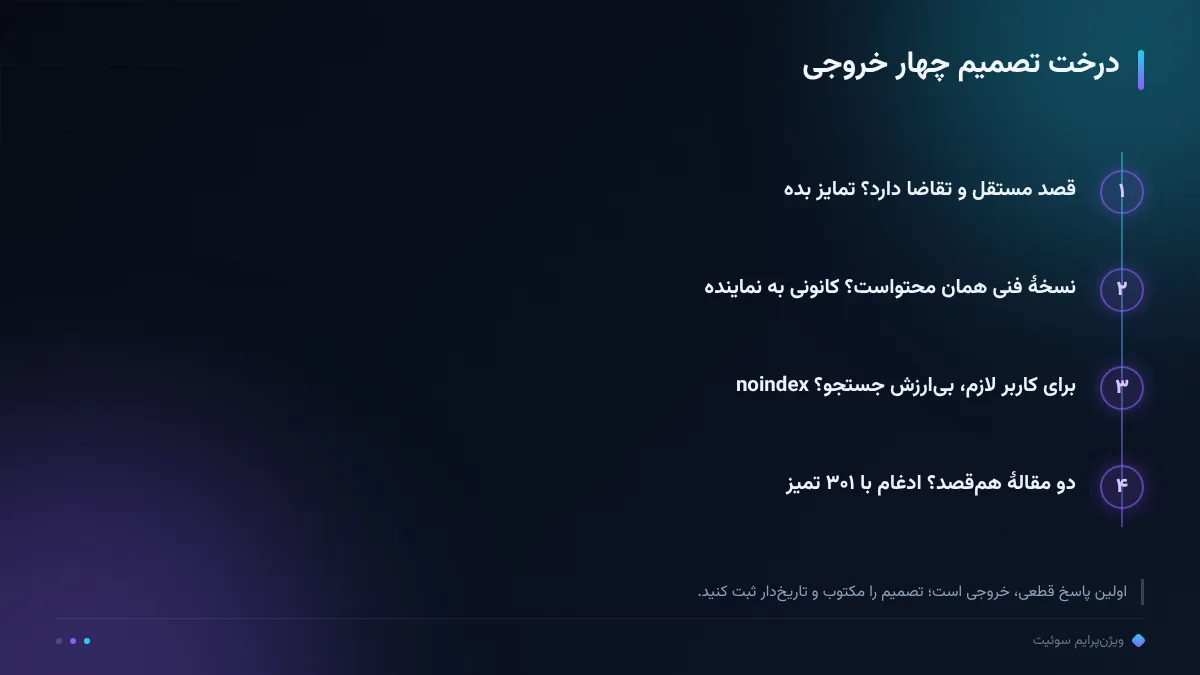
برای هر جفت یا گروه تکراری، چهار سؤال پشتسرهم بپرسید و اولین پاسخ قطعی، خروجی شماست. سؤال اول: هر دو صفحه قصد مستقل و تقاضای خودشان را دارند؟ اگر بله، مشکل شباهت است نه تکرار؛ با زاویه و ساختار تمایزشان دهید و دوباره منتشر کنید. سؤال دوم: یکی نمایندهٔ واقعی است و بقیه نسخهٔ فنی همان محتوا؟ کانونی به نماینده؛ اجرای تگ و شرطهایش در مقالهٔ خواهر باز شده و اینجا تکرار نمیشود.
سؤال سوم: صفحه برای کاربر لازم است ولی ارزش جستجوی مستقلی ندارد — فیلترهای داخلی، صفحهٔ تشکر، نسخهٔ چاپی؟ noindex، نه حذف؛ کاربر مسیرش را دارد، موتور از فهرست بیرونش میکند. سؤال چهارم: دو مقالهٔ همقصد که رقیب هم شدهاند؟ ادغام با ۳۰۱ و انتقال یگانهها به برنده؛ پروتکل کامل انتخاب برنده، انتقال محتوا و پاکسازی لینک در راهنمای ادغام است. دو قاعدهٔ کنار درخت: تصمیم را مکتوب و تاریخدار ثبت کنید و هرگز بیش از یک خروجی را همزمان روی یک گروه امتحان نکنید؛ تداخل درمان، تشخیص بعدی را خراب میکند.
آموزش گامبهگام اجرای تصمیمها
اجرای کانونی سه چیز دارد: تگ روی نسخههای تکراری به سمت نماینده، همراستا کردن لینکهای داخلی با همان انتخاب و حذف نسخههای پارامتری از نقشهٔ سایت؛ جزئیات قالب تگ و سناریوها در آموزش کانونیسازی است. اجرای ۳۰۱ هم قاعدهٔ سادهای دارد: ریدایرکت یکبهیک به آدرس نهایی، بدون زنجیره؛ اگر مسیر دوم هم بازنشسته شده، مستقیم به مقصد نهایی وصل کنید — الگوها و تفاوت ۳۰۱ و ۳۰۲ در ریدایرکت ۳۰۱ و ۳۰۲ آمده است.
اجرای noindex یک شرط فنی حیاتی دارد: صفحه باید قابل خزش بماند. طبق مستندات گوگل، دستور Disallow در robots.txt خزش را میبندد نه ایندکس را؛ صفحهای که خزشش بسته باشد، دستور noindex داخلش هرگز دیده نمیشود و برعکسِ هدف عمل میکند (تاریخ گردآوری: آبان ۱۴۰۵). اجرای بازنویسی هم قبل از انتشار دوباره، تفاوت قصد را مکتوب میخواهد: چه چیزی این صفحه را از خواهرش جدا میکند؟ اگر جواب در یک جمله نیامد، هنوز تصمیم بازنویسی نرسیده است. ترتیب اجرا را هم از کمریسک شروع کنید: کانونی و noindex برگشتپذیرند، ادغام و حذف نه؛ برای هر چهار مسیر، تاریخ اجرا و مسئولش را ثبت کنید تا پایشِ بعدی به همین سند تکیه کند.
خطاهای رایج در درمان تکرارها
خطای اول همان شرط فنی بخش قبل است: noindex پشت Disallow که بیاثر میماند و تیم فکر میکند کار تمام شده. خطای دوم، زنجیرهٔ ۳۰۱ طولانی است: ریدایرکتی به ریدایرکتِ دیگر که سرعت و سیگنال را در مسیر هدر میدهد؛ همیشه مستقیم به مقصد نهایی وصل کنید. خطای سوم، کانونی همهچیز به همهجاست: تگی که صفحات یک خوشه را به آدرسِ بیربط یا صفحهٔ اصلی سایت میفرستد، محتوای واقعی را از فهرست میکشد و جای خالی میسازد.
خطای چهارم، حذف یا ادغام بدون بررسی لینکهای داخلی است: صفحاتی که به آدرس حذفشده اشاره میکنند، ۴۰۴ تولیدی میسازند؛ پیش از بستن هر آدرس، فهرست لینکدهندهها را بگیرید و بهروز کنید. خطای پنجم، درمان یکباره و بیپیشگیری است: پارامتر جدید کمپین بعدی، تکرار تازه میسازد. قاعدهٔ پیشگیری ما این است که تصمیم هر گروه تکراری به قالب و روال تبدیل شود — فیلتر تازه چه کانونی میگیرد، محصول جدید چه الگویی، مقالهٔ همقصد کجا رد میشود — تا ماه بعد دوباره از صفر شروع نکنید.
پایش بعد از اصلاح
پایش را روی دو چشمه بسازید. چشمهٔ اول، سرچکنسول است با همان چهار سنجهٔ رسمی — نمایش، کلیک، نرخ کلیک و میانگین جایگاه — به تفکیک صفحه و با تاریخ ثبت (تاریخ گردآوری: آبان ۱۴۰۵). برای گروههای ادغامشده، مجموعِ برنده و بازندههای قبل را با برندهٔ بعد مقایسه کنید؛ افت جمع، سیگنال انتقال ناقص است. چشمهٔ دوم، خزش ماهانه است که باید نشان بدهد نسخههای تکراری در حال کمشدناند، نه جابهجایی؛ اگر جا خالی ساختهاید، همینجا دیده میشود.
انتظار زمانی را واقعی بگیرید: بازهٔ برآورد ما برای نشستن نتیجه، چهار تا دوازده هفته است؛ خزش و ارزیابی و جابهجایی سیگنالها زمان میخواهد و داوری هفتهٔ اول، تشخیص درست را خراب میکند. و تکرار را هم فصلی تشخیص دهید؛ تکرارها مثل گرد و غبار برمیگردند و روال چهارراهِ تشخیص، ارزانترین ابزار نظافت شماست. هر فصل، سند تصمیمهای قبلی را هم یکبار مرور کنید تا ببینید کدام قاعده کار کرد و کدام دوباره باز شد.
جمعبندی
سه ایستگاه را جمع کنیم: با چهار راه — خزش، اپراتور site:، گزارش پوشش و مقایسهٔ الگو — تکرارها را فهرست کنید؛ با درخت چهارسؤالی، برای هر گروه یک خروجی انتخاب کنید: تمایز، کانونی، noindex یا ادغام با ۳۰۱؛ و اجرا را با ثبت تاریخ، همراستایی لینک داخلی و پایش چهار سنجه ببندید. تکرار ساکت نمیماند اگر روال تشخیص فصلی باشد و تصمیمها مستند بمانند. این چرخه یک بار اجرا نمیشود؛ تمرین فصلی است که سایت را تمیز نگه میدارد.
اگر میخواهید این چرخه روی دامنهٔ شما اجرا شود، ممیزی رایگان دامنه فهرست اولیهٔ تکرارها را از داده میدهد و قابلیتهای پلتفرم پایش مستمر را جایگزین بازبینیهای پراکنده میکند؛ پلن پیشرو همان لایهٔ انتشار خودکار با اپراتور است که نگهداشتن روال را به عادت تبدیل میکند. زمینهٔ کامل سئوی فنی را هم در هاب سئو فنی نوشتهایم و جزئیات تگ کانونی، سناریوها و خطاهایش در مقالهٔ خواهر — آموزش کانونیسازی — در دسترس است.
رصد ما، رشد شما.
سؤالات پرتکرار
چند درصد تشابه یعنی صفحه تکراری؟
عدد قطعی و استانداردی وجود ندارد؛ به تجربهٔ ما عنوان، تگ هدینگ و بخشهای اصلی متن را با هم مقایسه کنید و قصد صفحه را ملاک بگیرید. دو صفحه با قصد مشترک و پوشش مشابه، حتی با تشابه کمتر، رقیب هم میشوند.
تکرار URL با تکرار محتوایی چه فرقی دارد؟
تکرار URL یعنی یک محتوا با چند آدرس — پارامتر، نسخهٔ چاپی، پروتکل — و درمانش معمولاً کانونی است؛ تکرار محتوایی یعنی چند صفحهٔ مستقل با متن و قصد نزدیک و درمانش تمایز یا ادغام با ۳۰۱ است.
پارامترهای UTM رتبه را خراب میکنند؟
اگر تگ خودارجاع روی صفحهٔ تمیز باشد، نه؛ نسخهٔ پارامتری به نسخهٔ اصلی اشاره میکند و مدیریت میشود. قاعدهٔ مکمل ما لینکدادن داخلی به آدرس تمیز است، نه آدرس کمپینی.
کی noindex انتخاب درست است و کی کانونی؟
صفحهای که برای کاربر لازم است ولی ارزش جستجوی مستقلی ندارد — فیلتر، تشکر، چاپ — noindex میگیرد؛ نسخهای که همان محتوای نماینده را تکرار میکند کانونی. معیار، ارزش جستجو است، نه سلیقه.
بعد از ادغام با ۳۰۱ کی نتیجه را ببینیم؟
بازهٔ برآورد ما چهار تا دوازده هفته است؛ مقایسه را روی مجموع صفحات ادغامشده انجام دهید، نه فقط برنده، تا انتقال ناقص زودتر خودش را نشان دهد.