آموزش گامبهگام خطای Discovered not Indexed؛ از کشف تا ایندکس
- خطای Discovered not Indexed یعنی چه و کجا دیده میشود؟
- تفاوت با Crawled not Indexed؛ چرا این تمایز مسیر رفع را تعیین میکند
- چهار دلیل رایج کشفشدن بدون ایندکس
- آموزش گامبهگام تشخیص در سرچکنسول
- رفع محتوایی: لینک داخلی و اولویتبندی صفحات
- رفع فنی: robots.txt، نقشهٔ سایت و فشار سرور
- جدول علت، نشانه و مسیر رفع
- پایش و جمعبندی؛ صبوری با داده
این برچسب را معمولاً دو دسته آدم میبینند: مدیر سایت تازهای که صدها صفحه را یکجا منتشر کرده و نمودار پوشش سرچکنسولش ناگهان خاکستری شده، و مدیر فروشگاهی که صفحات جدید را به نقشهٔ سایت داده و منتظر است فردا صبح در نتایج ببینند. هر دو یک سؤال دارند: «گوگل آدرس را دارد، پس چرا وارد فهرست نمیکند؟» پاسخ کوتاه این است که کشفشدن، درخواستِ نوبت است، نه خودِ نوبت.
چارچوب کلی وضعیتهای ایندکس را در هاب سئو فنی مرور کردهایم؛ این راهنما فقط همین یک دسته را عمیق میکند. اگر در میانهٔ کار مطمئن نیستید کدام دستهٔ گزارش، مسئلهٔ شماست، ممیزی رایگان دامنه وضعیت فنی را قبل از هر تصمیمی صاف میکند تا روی وضعیت اشتباه وقت نگذارید.
خطای Discovered not Indexed یعنی چه و کجا دیده میشود؟
در گزارش Page indexing سرچکنسول، وضعیت «Discovered – currently not indexed» یعنی URL در یکی از مسیرهای کشف — نقشهٔ سایت، لینک از صفحهٔ دیگر، یا ارسال دستی — به گوگل رسیده و صف نخواسته کراول شود. گوگل آدرس را میشناسد ولی هنوز تصمیم نگرفته وقت خزش صرفش کند؛ این تصمیم، ترکیبی از اعتبار دامنه، اولویت نسبی صفحه و ظرفیت خزش است. برای همین این وضعیت در سایتهای تازه و در روزهای انتشار انبوه، طبیعیتر از هر جای دیگری دیده میشود.
دو کلمهٔ «فعلاً» و «اولویت» را جدی بگیرید: بخش بزرگی از این صفها خودبهخود جلو میروند و صفحهها ایندکس میشوند؛ بازهٔ انتظار هم عدد ثابتی ندارد و بسته به اعتبار دامنه و تعداد لینک داخلی، در بازهٔ برآورد چند روز تا چند هفته میماند. مشکل، جایی شروع میشود که روندِ این دسته در طول ماهها رشد میکند یا صفحات مهم شما هفتهها در نوبت میمانند؛ آنوقت است که باید علتها را تشخیص داد و رفع کرد، نه فقط صبر.
تفاوت با Crawled not Indexed؛ چرا این تمایز مسیر رفع را تعیین میکند
دو برچسب خاکستری گزارش پوشش شبیه هماند و دقیقاً برای همین، رفعشان هم شبیه هم نیست. در Crawled not Indexed گوگل صفحه را خوانده و هنوز فهرست نکرده؛ یعنی دور کیفیت و شایستگی محتواست. در Discovered not Indexed گوگل هنوز نیامده بخواند؛ یعنی دور نوبت و اعتبار. اگر این دو را یکی بگیرید، مسیر را جابهجا میروید: برای صفحهای که هرگز خوانده نشده، بهبود متن، دیرترین راهحل است؛ اول باید ترتیب خزش را درست کرد.
تشخیص تفصیلی دستهٔ «خواندهشده ولی فهرستنشده» با علتها و جدول رفعش را در خطای کراول شد ایندکس نشد نوشتهایم و آنجا روی شایستگی محتوا، رندر و تکراریبودن متمرکز شدهایم؛ این مقاله همان محتوای مشترک را تکرار نمیکند و فقط سمت نوبتگیری میرود. یک نکتهٔ عملی برای تفکیک سریع هم داریم: وضعیت لحظهای هر URL را با ابزار بازرسی URL ببینید — اگر گزارش میدهد URL در نقشهٔ سایت است ولی «کراول نشده»، شما سمت Discovered هستید؛ اگر «کراول شده»، مسیر شما مقالهٔ دیگر است.
چهار دلیل رایج کشفشدن بدون ایندکس
دلیل اول، دامنهٔ تازه یا کمارجاع است: خزنده بودجهٔ محدودی برای هر سایت دارد و اول صفحات شناختهشدهتر را میخواند؛ برای دامنهای که هنوز سیگنال انباشته نکرده، صف طولانیتر طبیعی است. دلیل دوم، لینک داخلی ضعیف است: صفحهای که فقط در نقشهٔ سایت هست و هیچ صفحهٔ زندهای به آن اشاره نمیکند، از دید خزنده «یتیم» است و در صف اولویت پایینی میگیرد؛ صفحات یتیم، رایجترین علت قابل رفع این دستهاند.
دلیل سوم، انبوهسازی آدرس است: صدها URL یکجا به نقشه اضافه میشود — نسخههای فیلتر، برچسب، پارامتر — و خزنده مجبور است بین آنها اولویتبندی کند؛ نتیجه، صف طولانی برای همه است، حتی صفحات خوب. دلیل چهارم، فشار سرور و پاسخهای ناپایدار است: وقتی خزش بارها با تأخیر یا خطای موقت روبهرو شود، سرعت صفگیری هم پایین میآید. این چهار دلیل با هم، اکثر پروندههای واقعی این وضعیت را میپوشانند و جالب است که هیچکدام «جریمه» نیست؛ همه قابل رفع با کار درستاند.
آموزش گامبهگام تشخیص در سرچکنسول
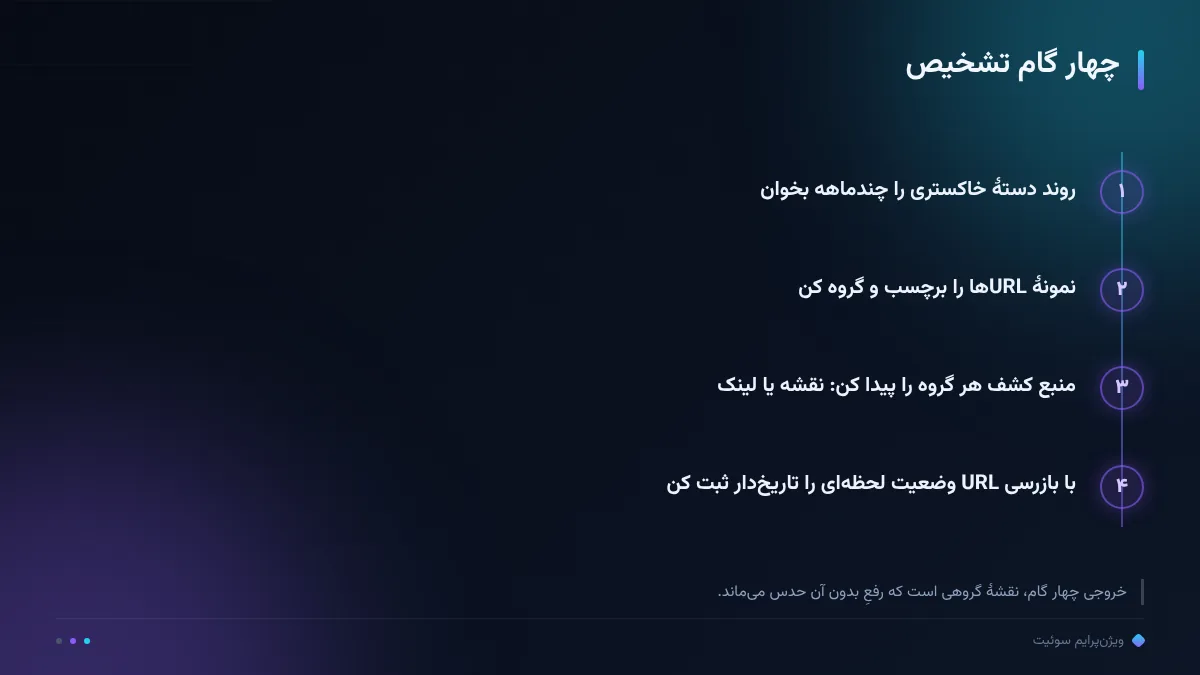
گام اول، روند را بخوانید نه روز را: دستهٔ Discovered not Indexed را در گزارش Page indexing انتخاب کنید و نمودارش را در بازهٔ چندماهه ببینید؛ یک جهش بعد از انتشار انبوه طبیعی است، رشد پیوستهٔ ماهانه یعنی علتِ پابرجا. گام دوم، نمونهبرداری است: بیست تا سی URL از همین دسته بردارید و هرکدام را برچسب بزنید — نوع صفحه، تاریخ انتشار، الگوی آدرس.
گام سوم، منبع کشف را برای هر گروه پیدا کنید: این URLها فقط در نقشه هستند یا از صفحات دیگر هم لینک دارند؟ گروههای بدون لینک داخلی، همانجا اولویت رفع میشوند. گام چهارم، ثبت وضعیت لحظهای است: با ابزار بازرسی URL ببینید هر نمونه الان کجاست — کراولشده، در نوبت، یا مسدود — و تاریخ آن را کنار برچسب بنویسید. همین ثبت تاریخدار، ماه بعد مبنای مقایسهی شماست. خروجی این چهار گام، فهرستی گروهبندیشده است که وارد جدول رفع میشود؛ بدون گروهبندی، هر تلاشی برای رفع، حدسِ سراسری میماند و نتیجهاش قابل داوری نیست.
رفع محتوایی: لینک داخلی و اولویتبندی صفحات
رفعِ محتوایی این وضعیت، یعنی به خزنده دلیل بدهید زودتر بیاید. ابزار اصلی، لینک داخلی است: صفحهٔ در نوبت را از دو سه صفحهٔ مرتبط و قویِ همان سایت با متن لنگر توصیفی لینک بدهید؛ صفحات پربازدید دستهها، مقالههای ایندکسشده و صفحهٔ اصلی، بهترین منابع سیگنالاند. عادت ما این است که هر صفحهٔ جدید، حداقل یک ورودی داخلی از محتوای موجود داشته باشد و چند خروجی به صفحات مرتبط بدهد؛ شبکهای که اینطور ساخته شود، صفها خودشان جلو میروند.
دوم، اولویتبندی آدرسها: از نقشهٔ سایت و انتشار، صفحاتی را که ارزش جستجو ندارند — فیلترها، نسخههای تکراری، برچسبهای کممصرف — بیرون بیاورید تا بودجهٔ خزش به صفحات اصلی برسد؛ کمتر کردنِ صف، سریعتر از بزرگکردن اعتبار جواب میدهد. سوم، برای صفحات مهمِ معطل، بهروزرسانی واقعی هم سیگنال میسازد: محتوای بهتر، دادهٔ تازه و تاریخ بهروزرسانی، اولویت صفحه را بالا میبرد. به تجربهٔ ما ترکیب لینک داخلی و اولویتبندی، بدون هیچ تغییر فنی، بیشترین بخش صفهای طولانی را کوتاه میکند.
رفع فنی: robots.txt، نقشهٔ سایت و فشار سرور
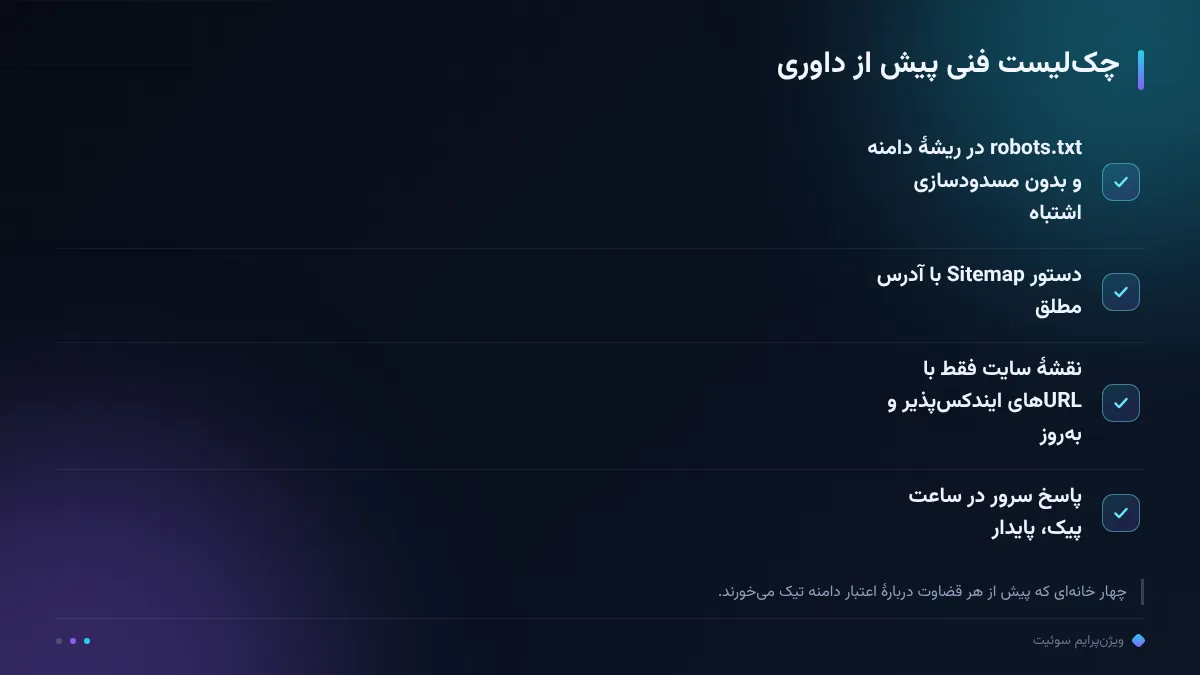
سمت فنی، سه فایل و یک منبع مسئولاند. robots.txt باید در ریشهٔ دامنه باشد و مسیرهای مهم را اشتباه نبندد؛ طبق مستندات Google Search Central، دستور Disallow خزش را مسدود میکند نه ایندکس را (تاریخ گردآوری: آبان ۱۴۰۵) — پس اگر صفحهای ایندکسشده را میخواهید از نتایج بیرون بکشید، Disallow کار را تمام نمیکند و noindex لازم است؛ و اگر مسیری بسته شده، وضعیت آن صفحات به دستهٔ مسدود میرود نه Discovered. این دو را با هم قاطی نکنید تا سرعت رفع درست انتخاب شود.
نقشهٔ سایت، کارت نوبت خزنده است: فقط URLهای ایندکسپذیر و بهروز در آن باشد و اگر در فایل robots.txt دستور Sitemap مینویسید، آدرسش مطلق باشد؛ اصول نقشهٔ سالم را در نقشه سایت XML سالم نوشتهایم و قواعد همین فایل را هم در robots.txt درست باز کردهایم. آخرین منبع، خود سرور است: پاسخ پایدار در ساعت پیک، خزشِ پیوسته را ممکن میکند؛ سروری که گاهی پاسخ نمیدهد، صف را هر بار به عقب میاندازد. این چهار خانه را تیک بزنید و بعد دربارهٔ اعتبار دامنه قضاوت کنید.
جدول علت، نشانه و مسیر رفع
جدول زیر چهار دلیل رایج را به نشانهٔ قابل مشاهده و مسیر رفع وصل میکند؛ از ستون نشانه شروع کنید، نه از ستون علت، چون تشخیص از داده شروع میشود:
| علت | نشانهٔ معمول | مسیر رفع |
|---|---|---|
| دامنهٔ تازه یا کمارجاع | خاکستریِ رشدی بعد از انتشار انبوه، بدون نشانهٔ فنی | صبر هدفمند + لینک داخلی از صفحات قوی |
| لینک داخلی ضعیف یا صفحهٔ یتیم | URL فقط در نقشهٔ سایت است، هیچ ورودی داخلی ندارد | لینک از دو سه صفحهٔ مرتبط و ایندکسشده |
| انبوهسازی آدرس در نقشه | حجم زیادی برچسب و فیلتر در صف؛ صفحات اصلی هم معطل | تمیزکردن نقشه و حذف URLهای بیارزش |
| فشار سرور یا پاسخ ناپایدار | نوسان وضعیت بین کشفشده و کراولشده؛ خطای موقت در بازرسی | کاهش فشار پیک و پایدارسازی پاسخ سرور |
نشانهها از ممیزیهای واقعی است؛ ترکیب دو علت در یک سایت هم رایج است.
یک سطر ذهنی هم برای فصلهای شلوغ نگه دارید: اگر بعد از رفع، سهم خاکستری کم نشد، داوری بعدی را به کیفیت بدهید و مسیر مقالهٔ کراولشدن را بروید؛ جدولهای دو مقاله با هم، هر دو وضعیت را پوشش میدهند و اشتباهگرفتنشان ممکن نمیشود.
پایش و جمعبندی؛ صبوری با داده
پایش این وضعیت با سرچکنسول انجام میشود و ابزار تازهای نمیخواهد: در گزارش Performance، چهار سنجهٔ رسمی — نمایش، کلیک، نرخ کلیک و میانگین جایگاه — روند واقعیِ نتیجه را نشان میدهند (تاریخ گردآوری: آبان ۱۴۰۵) و در گزارش پوشش، روند خاکستریِ این دسته باید بهتدریج کم شود. روتین ما ماهانه است: گرفتن دو روند، بررسی ده URL نمونه و ثبت تاریخدارِ هر اقدام؛ ماهها بعد همین گزارش میگوید کدام تصمیم صف را کوتاه کرد.
جمعبندی: خطای Discovered not Indexed نوبتِ خزنده است، نه جریمه؛ تمایزش با وضعیت کراولشده را درست بخوانید، چهار دلیل رایج را با نمونهبرداری پیدا کنید، لینک داخلی و اولویتبندی را اجرا کنید و فایلهای فنی را تیک بزنید. اگر خواستید همین پایش و انتشار منظم را به تیم بسپارید، قابلیتهای پلتفرم ویژنپرایم سوئیت زنجیرهٔ رصد تا انتشار را یکجا نگه میدارد؛ و به تجربهٔ ما، سایتی که صف ایندکس را نظارتشده مدیریت کند، بعد از هر انتشار انبوه هم آرامش داده دارد.
رصد ما، رشد شما.
سؤالات پرتکرار
Discovered not Indexed خطرناک است؟
بهخودیخود خطا نیست؛ یعنی گوگل آدرس را دیده و هنوز برای خزش اولویتبندی نکرده. اگر روند این دسته ماهبهماه رشد کند یا صفحات مهم هفتهها در نوبت بمانند، جدی بگیرید.
چقدر طول میکشد ایندکس شود؟
عدد قطعی وجود ندارد؛ در بازهٔ برآورد، از چند روز تا چند هفته، بسته به اعتبار دامنه، تعداد لینک داخلی و تازگی محتوا.
با درخواست ایندکس دستی دربیاورم؟
برای چند URL مهم میتواند تسریع کند، اما برای صدها صفحه راهحل نیست؛ ریشه در اولویتبندی، لینک داخلی و نظم نقشهٔ سایت است.
نقش robots.txt در این وضعیت چیست؟
طبق مستندات گوگل، Disallow خزش را میبندد نه ایندکس را؛ مسیرِ بستهشده به دستهٔ مسدود میرود نه Discovered، و برای حذف از نتایج، noindex لازم است (تاریخ گردآوری: آبان ۱۴۰۵).
کی باید نگران شوم؟
وقتی صفحات باکیفیت و مهم شما هفتهها در این وضعیت میمانند یا سهم خاکستری در روند چندماهه رشد میکند؛ در این صورت تشخیص چهارگامی و جدول علتها را اجرا کنید.