خطای Crawled not Indexed چیست؛ آموزش گامبهگام تشخیص و رفع
- خطای Crawled not Indexed یعنی چه و با چه وضعیتهایی اشتباه گرفته میشود؟
- تشخیص در سرچکنسول؛ چهار گام از گزارش پوشش تا بازرسی URL
- شش علت رایج کراولشدن بدون ایندکس
- جدول علت، نشانه و مسیر رفع
- رفع گامبهگام؛ از محتوا تا معماری
- کجا نگران نباشید؛ صفحاتی که ایندکس نشدنشان درست است
- جمعبندی؛ تشخیص دقیق، رفع مرحلهای، پایش صبور
این پیام را تقریباً هر مدیری که گزارش سرچکنسول را نگاه میکند دیده است: صفحاتی که در نمودار پوشش، رنگ خاکستری گرفتهاند و زیر برچسبی نشستهاند که اولش «Crawled» دارد و آخرش «not indexed». ترس رایج این است که فکر کنیم سایت جریمه شده؛ حقیقت معمولاً روزمرهتر و قابلحلتر است. در این راهنما معنای دقیق وضعیت را باز میکنیم، روش تشخیص را چهار گامی میکنیم و برای هر علت، مسیر رفع مشخصی میدهیم. زبان راهنما برای مدیر سایت و تولیدکنندهٔ محتوا ساده نوشته شده؛ هیچکدام از گامها به دانش برنامهنویسی عمیق نیاز ندارد.
چارچوب کلی را در هاب سئو فنی مرور کردهایم؛ این مقاله فقط یکی از وضعیتهای گزارش پوشش را عمیق میکند. اگر پایههای فنی سایت تازه شکل گرفته، پیش از ادامه ممیزی رایگان دامنه تصویر واقعی وضعیت را جلوی شما میگذارد تا با حدس کار نکنید.
خطای Crawled not Indexed یعنی چه و با چه وضعیتهایی اشتباه گرفته میشود؟
طبق مستندات Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵)، «Crawled – currently not indexed» یک وضعیت در گزارش Page indexing سرچکنسول است، نه پیام خطای سرور: صفحه در دسترس بوده، خزنده آن را خوانده، اما تصمیم فهرستسازی هنوز قطعی نشده یا منفی است. کلمهٔ «فعلاً» در تعریف مهم است؛ این وضعیت جابهجاست و صفحات میتوانند بعداً ایندکس شوند، بدون آنکه شما کاری بکنید. همین «فعلاً» است که پرسشهای مدیریتی را سخت میکند؛ بودجهٔ محتوا خرج شده و بازدهی هنوز دیده نمیشود. تصمیم درست این است که وضعیت را با داده بخوانید، نه با احساس.
سه وضعیت دیگر را با آن اشتباه نگیرید: «Discovered – currently not indexed» یعنی صفحه دیده شده ولی هنوز کراول نشده و معمولاً به اولویت و اعتبار دامنه برمیگردد؛ «Not Found (404)» یعنی صفحه پاسخ حذفشدگی میدهد؛ و صفحاتی که با «noindex» حذف شدهاند، تصمیم صریح خودِ سایت هستند. تمایز این چهار حالت، اولین گام تشخیص است؛ برای هر کدام راهحل متفاوتی داریم و یکسانانگاریشان، زحمت را به مسیر اشتباه میفرستد.
تشخیص در سرچکنسول؛ چهار گام از گزارش پوشش تا بازرسی URL
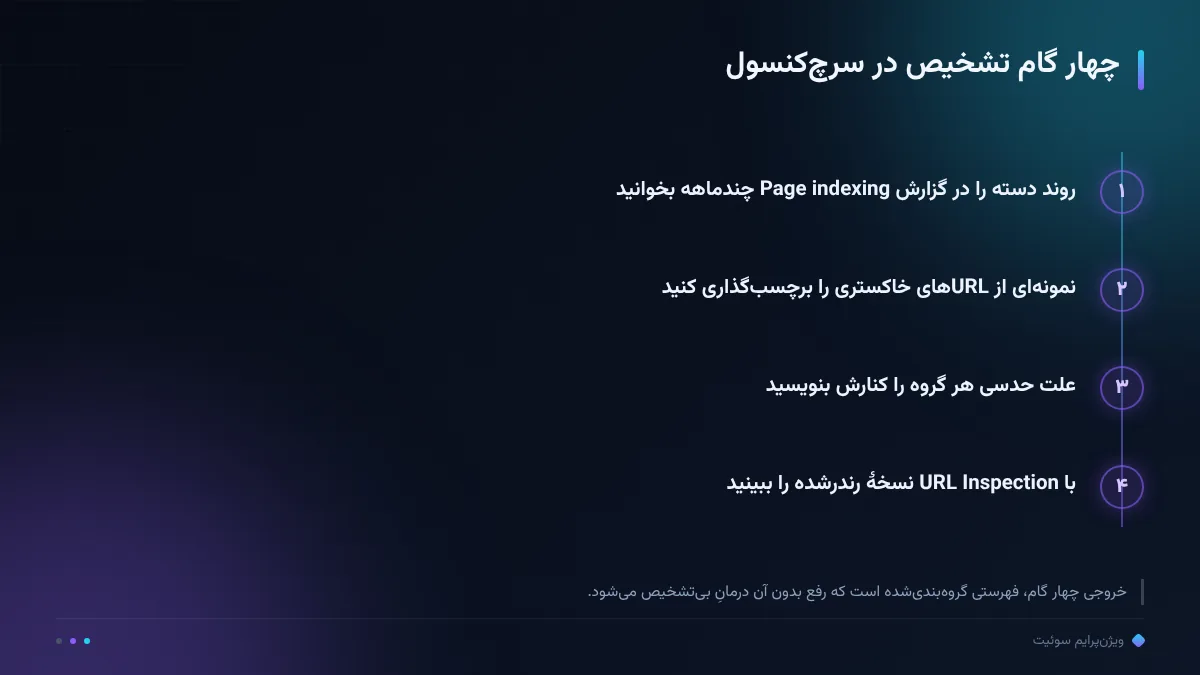
گام اول، نگاه روندی است: در گزارش Page indexing، دستهٔ «Crawled – not indexed» را انتخاب کنید و روند آن را نه در یک روز، که در بازهٔ چندماهه بخوانید؛ جهش موقت طبیعی است، رشد پیوسته زنگ خطر. عادت بد، قضاوت بر اساس هفتهٔ جاری است؛ سرچکنسول دادهٔ دورهای میدهد و خواندن دورهای هم تصمیم دورهای میسازد. گام دوم، نمونهبرداری است: دهها URL از لیست خاکستری بردارید و برای هرکدام یک برچسب ساده بزنید — نوع صفحه، تاریخ انتشار، الگوی آدرس.
گام سوم، دستهبندی علل حدسی است؛ به تجربهٔ ما الگوها در همین نمونهٔ کوچک ظاهر میشوند: همهٔ صفحات برچسب؟ همهٔ نسخههای فیلتردار؟ فقط صفحات تازه؟ گام چهارم، بازرسی تکURL است: در ابزار URL Inspection نسخهٔ کراولشده و رندرشده را ببینید تا مشخص شود گوگل چه چیزی از صفحه دیده است. خروجی این چهار گام، فهرستی گروهبندیشده است که وارد بخش علتها میشود؛ بدون این گروهبندی، هر تلاشی برای رفع مثل درمان بدون تشخیص میماند.
شش علت رایج کراولشدن بدون ایندکس
علت اول، محتوای نازک یا تکراری است؛ صفحاتی که متن کافی، تصویر یا دادهٔ یکتا ندارند — نمونهٔ رایجاش صفحات فیلتر و برچسبهاست. علت دوم، دوبلگی آدرس است: چند نسخه از یک محتوا با پارامترهای متفاوت و تعیین نشدن نسخهٔ اصلی با canonical؛ گوگل یکی را انتخاب میکند و بقیه بیرون میمانند.
علت سوم، مشکل رندر است؛ اگر محتوای اصلی فقط پس از اجرای جاوااسکریپت ظاهر میشود و رندر شکست میخورد، گوگل صفحهای تقریباً خالی خوانده است. علت چهارم، بودجهٔ خزش و اعتبار دامنه است؛ سایتهای تازه یا کمارجاع، صفحات را در صف انتظار میبینند و صفحات مهمتر زودتر ایندکس میشوند.
علت پنجم، ارزش جستجوی پایین است؛ صفحاتی که برای هیچ پرسشی بهینه نشدهاند یا نیتشان با صفحهای دیگر یکی است، شایستهٔ فهرست شدن شمرده نمیشوند. علت ششم، نشانههای کیفیت کل دامنه است؛ در بهروزرسانیهای گستردهٔ اصلی، طبق گفتهٔ گوگل راهحل خاصی وجود ندارد و تمرکز باید روی کیفیت کلی محتوا باشد و بازگشت هم میتواند ماهها طول بکشد (تاریخ گردآوری: آبان ۱۴۰۵). این شش علت با هم، تقریباً همهٔ پروندههایی را که در ممیزیهای ما باز شده پوشش میدهند. برای همین است که در ممیزیها همیشه دو پرسش میپرسیم: شایستگی هر صفحه چیست و اولویت خزنده برای رفتن به آن چیست؟
جدول علت، نشانه و مسیر رفع
جدول زیر شش علت را به نشانهٔ قابل مشاهده و مسیر رفع وصل میکند؛ از ستون نشانه شروع کنید، نه از ستون علت، چون تشخیص از داده شروع میشود:
| علت | نشانهٔ مشخص | مسیر رفع |
|---|---|---|
| محتوای نازک | متن کم و شباهت زیاد به صفحات دیگر | غنیسازی یا ادغام صفحات |
| دوبلگی URL | نسخههای پارامتردار یک صفحه | canonical منسجم و پاکسازی الگو |
| مشکل رندر | محتوای خالی در نسخهٔ رندرشدهٔ بازرسی | رندر سمت سرور یا سادهسازی |
| اعتبار پایین دامنه | صفحات تازه و مهم، دیر ایندکس میشوند | لینک داخلی، انتظار، تمرکز بر صفحات کلیدی |
| ارزش جستجوی پایین | صفحهای بیپرسش هدف | noindex یا ادغام با صفحهٔ مرتبط |
| کیفیت کل دامنه | افت همزمان در چند دسته | برنامهٔ بلندمدت کیفیت، نه فیکس فوری |
به تجربهٔ ما بیشترین رفع نتیجهدار در دو ردیف اول میافتد؛ صفحات نازک و دوبلگی، بار بزرگتری از دستهٔ خاکستری را میسازند و اصلاحشان هم سریعتر جواب میدهد. ستون نشانه را از دو جا بگیرید: گزارش پوشش برای الگوی گروهی و بازرسی URL برای عمق تکصفحه؛ وقتی نشانه و علت همخوان شدند، مسیر رفع خودش را نشان میدهد.
رفع گامبهگام؛ از محتوا تا معماری
رفع را از گروههای پرشمار شروع کنید و ترتیب کار ثابت بماند: اول محتوا — غنیسازی یا ادغام صفحات نازک با یک صفحهٔ شایسته؛ بعد ساختار — تعیین نسخهٔ اصلی در دوبلگیها و پیوند دادن صفحات یتیم از صفحات پرقدرت؛ بعد فنی — رفع مشکل رندر برای گروههایی که در بازرسی خالی دیده میشدند. این ترتیب را عوض نکنید؛ فیکس فنی روی محتوای نازک، فقط یک صفحهٔ خالیتر و سریعتر میسازد.
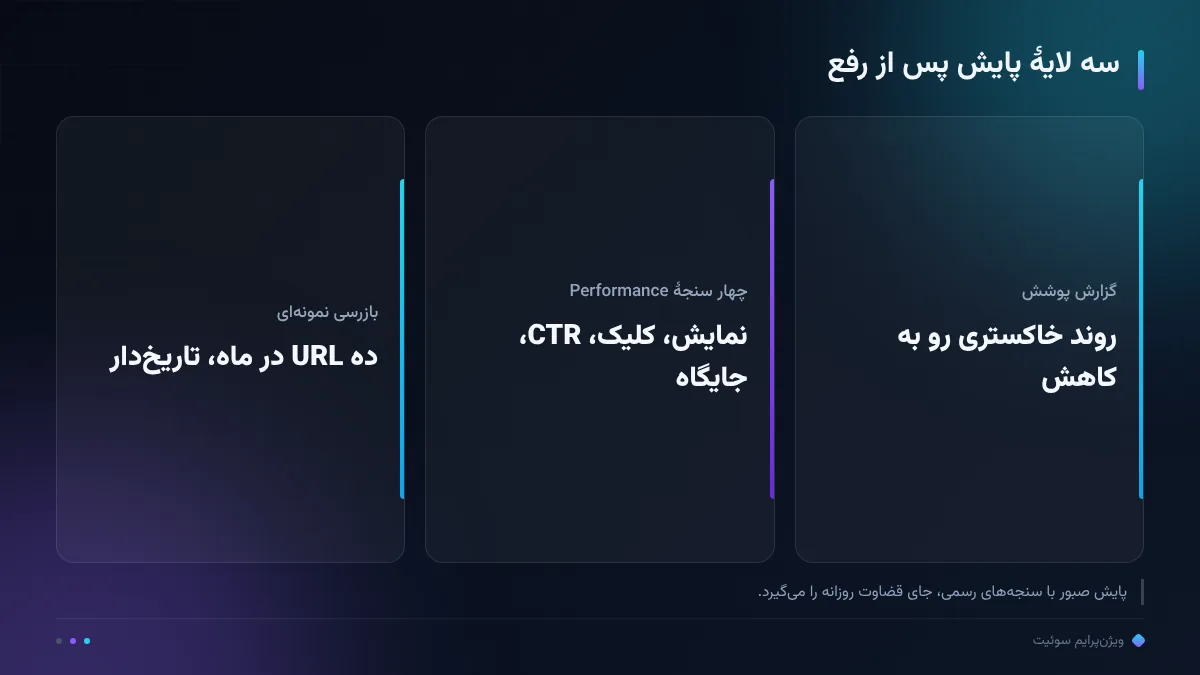
در پایان هر مرحله، نقشهٔ سایت بهروز را مبنای اعلام قرار دهید؛ ساختار سالمش را در نقشه سایت XML سالم مرور کنید تا فقط صفحات واقعاً شایسته در فهرست باشند. برای پایش، چهار سنجهٔ رسمی گزارش Performance — نمایش، کلیک، CTR و جایگاه — را دورهبهدوره بخوانید (تاریخ گردآوری: آبان ۱۴۰۵) و روند دستهٔ خاکستری را کنارش ثبت کنید. به تجربهٔ ما جابهجایی صفحات اصلاحشده به فهرست، از چند روز تا چند هفته طول میکشد؛ درخواست ایندکس را فقط برای صفحات اولویتدار و بعد از اصلاح واقعی استفاده کنید.
کجا نگران نباشید؛ صفحاتی که ایندکس نشدنشان درست است
همهٔ ردیفهای خاکستری پروندهٔ شکست نیستند؛ صفحات نتایج جستجوی داخلی، نسخههای فیلتردار کاتالوگ، صفحات تشکر و پرداخت، و نسخهٔ چاپی محتوا معمولاً ارزش جستجوی مستقلی ندارند و بیرون ماندنشان از فهرست، رفتار درست موتور است. اگر چنین صفحاتی در دستهٔ خاکستری زیاد دیده میشوند، کار درست این است که با noindex یا بازآرایی لینکدهی داخلی، مسیرشان را صریح کنید تا سهم بیشتری از توجه خزنده به صفحات کلیدی برسد. معیار تصمیم هم ساده است: اگر این صفحه فردا در نتایج ظاهر شود، برای جستجوگر ارزشی دارد؟ اگر جواب منفی است، بیرون ماندن نعمت است.
یک اشتباه رایج را هم همینجا ببندید: بستن مسیرها با robots.txt برای حذف از فهرست. طبق مستندات Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵)، دستور Disallow مانع کراول میشود، نه ایندکس؛ صفحهای که کراول نشود حتی امکان شنیدن noindex را هم ندارد. تنظیمات درست فایل رباتها را در robots.txt درست مرور کردهایم؛ برای حذف از فهرست، noindex یا حذف واقعی مسیر درست است.
جمعبندی؛ تشخیص دقیق، رفع مرحلهای، پایش صبور
جمعبندی راهنما: وضعیت «Crawled not indexed» یک رأی کیفیت موقت است، نه حکم نهایی؛ چهار گام تشخیص، شش علت رایج و جدول علت-نشانه-رفع را در اختیار دارید. ترتیب رفع را حفظ کنید — محتوا، ساختار، فنی — و انتظار واقعبینانه داشته باشید؛ به تجربهٔ ما پروژهای که با گروهبندی درست شروع شود، ظرف یک تا دو ماه بازهٔ واضحی از بهبود پوشش نشان میدهد. سند کوچک اما ماندگاری هم بسازید: تصمیمها و تاریخهایشان را ثبت کنید تا در جلسهٔ بعدی، استدلال جای حدس را بگیرد.
اگر نمیخواهید این چرخه را دستی مدیریت کنید، دموی رایگان پلتفرم ویژنپرایم سوئیت زنجیرهٔ رصد تا انتشار امن را یکجا نشان میدهد و ممیزی رایگان دامنه وضعیت فعلی را پیش از هر اقدام مشخص میکند. و یادتان بماند: صفحاتی که واقعاً شایستهاند، دیر یا زود وارد فهرست میشوند؛ کار شما ساختن شایستگی است، نه فشار بر موتور جستجو.
رصد ما، رشد شما.
سؤالات پرتکرار
Crawled not Indexed یعنی سایت جریمه شده؟
نه؛ در اکثر موارد رأی کیفیت است نه جریمه. روند دسته و نمونهبرداری صفحات تصمیم میگیرد پیام شما افت کیفیت است یا کافی نبودن شایستگیِ تکصفحه.
بعد از رفع، چند طول میکشد صفحات ایندکس شوند؟
به تجربهٔ ما از چند روز تا چند هفته و برای دامنههای تازه گاهی حدود یک ماه. نشانهٔ پیشرفت، جابهجایی صفحات از دستهٔ خاکستری به ایندکسشده در گزارش پوشش است.
باید برای همهٔ صفحات درخواست ایندکس بدهم؟
نه؛ درخواست ایندکس برای صفحات اولویتدارِ اصلاحشده سودمند است و تکرار ماشینی آن فایدهای ندارد. اول شایستگی صفحه را بالا ببرید، بعد درخواست بدهید.
robots.txt جلوی ایندکس را میگیرد؟
خیر؛ طبق مستندات Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵) دستور Disallow کراول را میبندد نه ایندکس را. برای حذف از فهرست از noindex یا حذف واقعی صفحه استفاده کنید.
با وضعیت Not Found چه فرقی دارد؟
Not Found یعنی صفحه پاسخ ۴۰۴ میدهد؛ در Crawled not Indexed صفحه سالم است و خوانده شده، فقط شایستگی یا اولویتش برای فهرستشدن کافی نبوده است.