ابزار تشخیص متن AI به زبان ساده؛ محدودیتها و استفادهٔ درست
- ابزار تشخیص متن AI چه میبیند و چه چیزی را نمیبیند؟
- زیر درپوش؛ دو سیگنالی که مدلها میسنجند
- چرا نتیجهٔ درصدها قابل امضا نیست؛ پنج دلیل
- موضع گوگل؛ کیفیت مهم است، نه روش تولید
- استفادهٔ مسئولانه؛ چهار دریچه پیش از انتشار
- این مسیر، راه فرار از تولید محتوا نیست
- سه قدم برای تیمهای کوچک
- جمعبندی؛ سه جملهای که با خود ببرید
اعتراف اول کار: ما هم اگر فقط به عدد نگاه کنیم گول میخوریم. هیچ سازندهای دقت قطعی منتشر نمیکند و هیچ عددی از این ابزارها به دست تیم ما نرسیده که بخواهد آن را امضا کند. پس این راهنما نه دفاع است، نه محکومیت؛ نقشهٔ استفادهٔ درست است — برای کسی که متناش را جدی میگیرد.
زاویهٔ ما روشن است: میبینیم این ابزارها چه چیزی را میسنجند و چه چیزی از دیدشان پنهان میماند، بعد سراغ موضع گوگل و گامهای عملی میرویم. اگر دنبال فهرست «بهترین دیتکتور» هستید، جای درستی نیستید؛ چون به تجربهٔ ما چنین فهرستی بدون توضیح محدودیتها، بیشتر از آن که کمک کند، گمراه میکند.
ابزار تشخیص متن AI چه میبیند و چه چیزی را نمیبیند؟
ابزار تشخیص متن AI در بهترین حالت یک «سرنخسنج» است: به شکل و قافیهٔ جملهها نگاه میکند و حدس میزند این جملهها از چه مسیری آمدهاند. آنچه میبیند، بافت کلمههاست — اینکه واژهٔ بعدی چقدر قابل حدس آمده، جملهها چقدر هماندازه و یکنواختاند و لحن چقدر مسطح پیش میرود.
آنچه نمیبیند مهمتر است: نمیبیند ادعای متن راست است یا نه، نمیداند نویسنده تجربهٔ واقعی دارد یا خواندهها را بازگو میکند، منبع آمار را چک نمیکند و از تازگی اطلاعات سر در نمیآورد. برای همین، درصدی که تحویل میگیرد دربارهٔ «کیفیت» نیست؛ دربارهٔ «سبک» است. این دو را با هم اشتباه بگیرید، تصمیم اشتباه میگیرید.
تشبیه سادهای برای این تفاوت هست: نگهبانِ ورودی ساختمان. نگهبان شکل ورود را میبیند — کی آمد، چطور آمد، چه حسی میداد — اما نمیداند داخل اتاق چه گفتید و آیا حرفتان راست بود. این ابزارها هم نگهبانِ ورودیاند: در انتخاب زمانِ «بررسی جدیتر» کمک میکنند و در قضاوتِ «قابل اعتماد است یا نه» کاری از دستشان برنمیآید.
زیر درپوش؛ دو سیگنالی که مدلها میسنجند
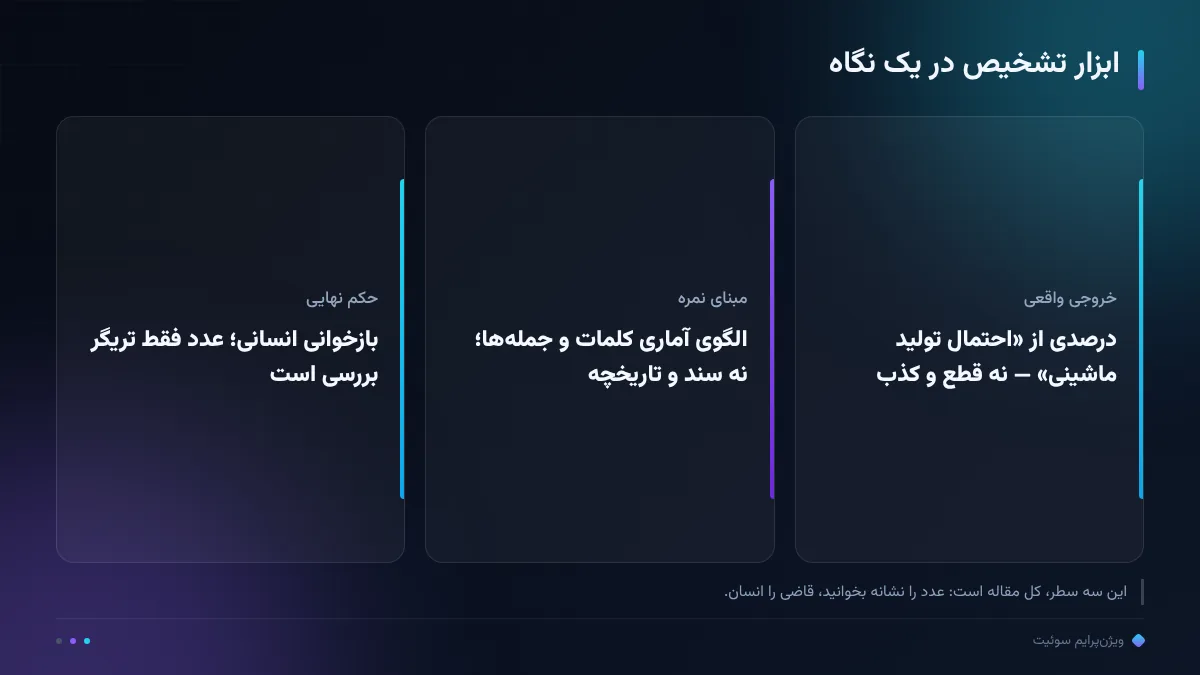
دو سیگنال رایج در این ابزارها را میشود به زبان ساده توضیح داد. سیگنال اول، «قابل حدسبودن» است: مدلهای زبانی واژهٔ بعدی را با احتمال انتخاب میکنند؛ متنی که هر لحظه دقیقاً همان واژهٔ مورد انتظار بیاید، امتیاز ماشینبودن بالاتری میگیرد. سیگنال دوم، «یکنواختی» است: جملههای همطول، پاراگرافهای همقالب و نبودِ انحرافهای شخصی.
دقت کنید هر دو سیگنال دربارهٔ شکل هستند، نه جوهر. متن دستنویسِ خشک و اداری ممکن است «ماشینی» علامت بخورد و متن ماشینِ ویرایششده با خاطره و مثال، «انسانی». برای همین کارت کنار این بخش را نگه دارید: مرز آنچه مدل میبیند و نمیبیند، کل ماجراست.
چرا نتیجهٔ درصدها قابل امضا نیست؛ پنج دلیل
چرا نتیجهٔ درصدها قابل امضا نیست؟ پنج دلیل. اول، ویرایش انسانی: یک دور بازنویسیِ دستی، نتیجه را کاملاً عوض میکند. دوم، فارسیِ رسمی و قالبی: نامههای اداری و مقالههای آکادمیک ذاتاً یکنواختاند و بهسختی «انسانی» علامت میخورند. سوم، متن کوتاه: روی دو-سه پاراگراف، هیچ آماری معنادار نیست.
چهارم، ترکیب انسان و ماشین: بیشتر محتواهای واقعی امروز مخلوطاند و ابزارها برای این مرز طراحی نشدهاند. پنجم، نسخهها: خروجی دو ابزار یا دو نسخهٔ یک ابزار بر سر یک متن ممکن است قرینهٔ هم باشد. دادهٔ قطعی از نرخ خطا منتشر نشده است؛ به تجربهٔ ما چون سازندگان خودشان در مستنداتشان هشدار میدهند که نتیجه را بهتنهایی ملاک قرار ندهید، این احتیاط بیجا نیست. الگوی «یکنواختیِ بیروح» را که رایجترین خطای محتوایی است، در «محتوای بی روح هوش مصنوعی؛ چرا نتیجه نمیدهد و علتهای پنهان کجاست؟» جداگانه باز کردهایم.
جمع این پنج دلیل به یک قاعده ساده میرسد: هرچه متن کوتاهتر، رسمیتر و کمویرایشتر باشد، احتمال خطای نتیجه بیشتر است؛ و برعکس، متن بلند و شخصیتر نتیجهٔ نزدیکتری میدهد — اما همچنان بدون قاطعیت. برای همین در کارِ روزمرهٔ ما، هر عددی که از این ابزارها بیرون بیاید فقط یک معنی دارد: برو یک دورِ دیگر با دقت بخوان.
موضع گوگل؛ کیفیت مهم است، نه روش تولید
سؤال پرتکرار مدیران: اگر با هوش مصنوعی تولید شود، گوگل جریمه میکند؟ جواب مستندات روشن است: گوگل میگوید محتوای باکیفیت را فارغ از روش تولید پاداش میدهد و آنچه سیاستهای اسپم آن را هدف گرفته، تولید انبوهِ بدون ارزش افزوده است، نه استفادهٔ مسئولانه از ابزار (مستندات Google Search Central، تاریخ گردآوری: آبان ۱۴۰۵). یعنی محور سنجش، کمکرسانی واقعی به خواننده است.
برای اینکه این موضع گنگ نماند، یک تفکیک کاربردی: گوگل بین محتوای کمکی و تولید انبوهِ بیارزش فرق میگذارد. محتوای کمکی جواب مشخصی برای پرسش مشخص است؛ حتی اگر پیشنویسش با کمک مدل آمده باشد، ارزش افزودهٔ ویرایش و تجربه دارد. تولید انبوهِ بیارزش اما برای اشغال کلمهها نوشته میشود، نه برای راضیکردن خواننده. ابزار تشخیص در این تفکیک نقشی ندارد؛ قضاوت با کیفیت نهایی است.
این موضع یک پیامد عملی دارد: انرژیای که صرف «مخفیکردن ردپای ماشین» میکنید، در جای درستی خرج نمیشود. همان انرژی را بگذارید سراغ اضافهکردن تجربه، مثال واقعی و بررسی اعداد — همان چیزهایی که ابزار تشخیص هم نمیبیند و خواننده و گوگل هر دو میبینند. راهنمای «چکلیست گیت کیفیت برای محتوای هوش مصنوعی؛ ۱۲ مورد قبل از انتشار» همین مسیر را گامبهگام میکند.
استفادهٔ مسئولانه؛ چهار دریچه پیش از انتشار
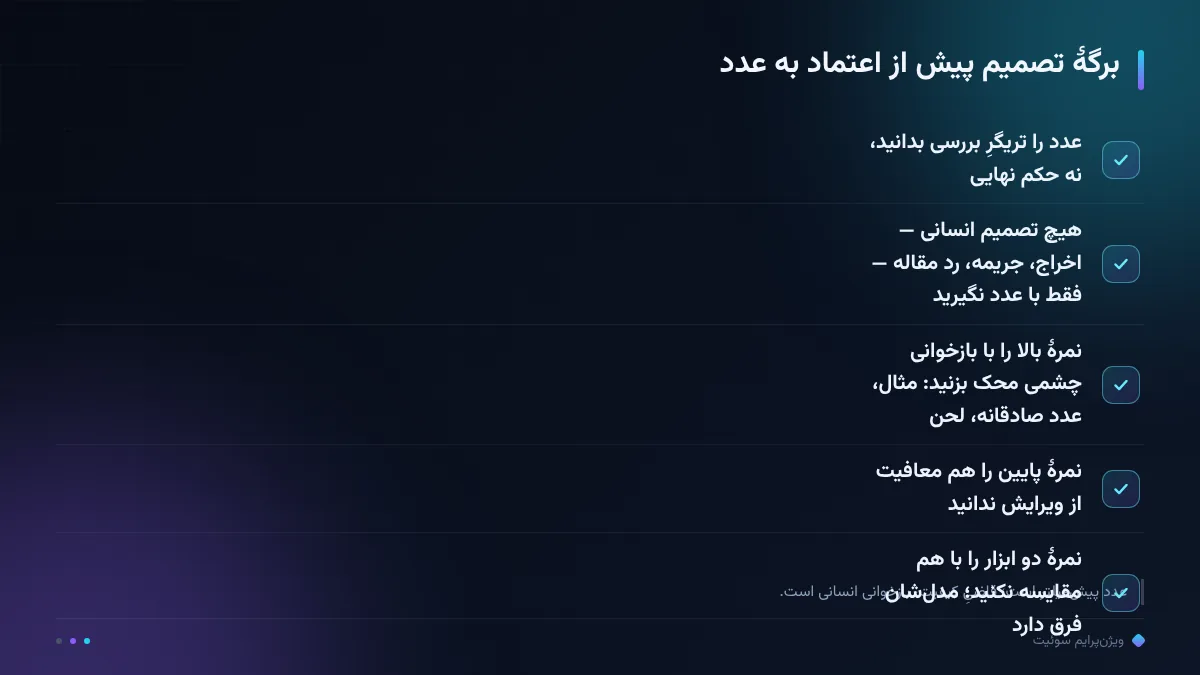
استفادهٔ مسئولانه یعنی ابزار را از مقام داور به مقام سرنخدهنده تنزل دهید و چهار دریچه را پیش از انتشار ببندید. دریچهٔ اول، خواندن کامل پیشنویس توسط یک انسان که موضوع را میفهمد — نه نگاه سرسری. دریچهٔ دوم، بررسی هر عدد و ادعا با منبع؛ اگر عددی منبع نداشت، حذف یا بازنویسی میشود.
دریچهٔ سوم، افزودن چیزی که ماشین ندارد: تجربهٔ خودتان، مثال مشتری واقعی، نظر کارشناس. دریچهٔ چهارم، ویرایش زبانی و لحن برند تا متن به صدای شما نزدیک شود. به تجربهٔ ما همین چهار دریچه فرق میان «انتشار سریع» و «انتشار قابل دفاع» را میسازد، چون خروجیِ نهایی را از پاسخ عمومی به جواب اختصاصیِ کسبوکار شما تبدیل میکند.
نکتهٔ کوچک اما مؤثر: نسخهٔ نهایی را با تاریخ ویرایش و نام بازبین آرشیو کنید. وقتی سه ماه بعد بحثی سر منشأ یک ادعا درگرفت، همین آرشیو نشان میدهد هر لایه از کدام مرحله آمده و مسئولیت کجا بود. تیمهایی که این کار را میکنند، از بحثهای بیپایان «این متن مال کی بود؟» خلاص میشوند.
این مسیر، راه فرار از تولید محتوا نیست
یک سوءتفاهم پرهزینه را صریح رد کنیم: استفاده از این ابزارها راه فرار از تولید محتوا نیست. اگر بدون ویرایش و بدون دانش موضوعی منتشر کنید، نتیجه همان محتوای بیروحی است که هیچ جستجویی را ارضا نمیکند و برند را هم بیاعتبار میکند؛ ابزار تشخیص فقط زنگ این خطر را زودتر میزند. گوگل هم بارها گفته هدفش مبارزه با محتوای بیارزشِ انبوه است.
هزینهٔ این سوءتفاهم را هم بشمارید: تیمی که ابزار را جای فرایند مینشاند، صد صفحه در ماه منتشر میکند و هیچکدام نگه نمیدارد؛ تیمی که ابزار را جای سرنخ مینشاند، شاید چهل صفحه منتشر کند اما هر صفحه دستکم یک چیزِ تازه دارد — دادهٔ خودشان، تجربهٔ پشتیبانی، خطای رایج مشتری. در جستجوی امروز، فاصلهٔ این دو تیم با گذشت زمان بیشتر میشود، نه کمتر.
جای درست هوش مصنوعی در خط تولید، «دستیار» است نه «جایگزین»: پیشنویس اولیه، فهرست زاویهها، بازآرایی ساختار — و بعد، انسانِ آشنا به موضوع. مقایسهٔ دقیق این دو نقش و مرزشان را در «AI نویسنده یا دستیار نویسنده به زبان ساده؛ بدون اصطلاح فنی» نوشتهایم؛ جمع آن دو مقاله یک جمعبندی ساده دارد: ابزار هزینهٔ تولید را کم میکند، نه مسئولیت کیفیت را.
سه قدم برای تیمهای کوچک
برای تیمهای کوچک، سه قدم عملی کافی است. قدم اول: یک سیاست یکصفحهای بنویسید که در آن نقش ابزار مشخص شود — پیشنویس بله، انتشار مستقیم خیر — و همهٔ اعضا امضا کنند. قدم دوم: برای هر پیشنویس، یک «مالک انسانی» تعیین کنید که نامش پای نتیجهٔ نهایی باشد؛ مسئولیتِ بینام، عملاً هیچ است.
قدم سوم: درصدِ ابزار را فقط بهعنوان زنگ هشدار ببینید؛ عدد بالا یعنی «بررسی جدیتر»، نه «دور انداختن». با همین سه قدم، هم از مخاطرهٔ انتشار بیواسطه دور میشوید و هم مزیت سرعتِ تولید را از دست نمیدهید — ترکیبی که تیمهای دو-سه نفره بیش از همه به آن نیاز دارند.
یک قدم کوچک فرهنگی هم اضافه کنید: در جلسهها از «ابزار گفت» حرف نزنید؛ بگویید «بازبینی گفت». زبانِ تیم، مرزِ نقشها را میسازد؛ تا وقتی عدد ابزار در جلسه حکم صادر کند، سیاست مکتوب هم مقاومت نمیکند. در هر گزارش محتوایی که منتشر میکنید، دو ستون آخر را همین امروز رزرو کنید: درصدِ سرنخ و نامِ بازبین.
جمعبندی؛ سه جملهای که با خود ببرید
سه جمله را با خود ببرید: ابزار تشخیص متن AI سبک را میسنجد نه کیفیت را، و درصدش سرنخ است نه مدرک؛ موضع گوگل کیفیت را پاداش میدهد نه روش تولید را؛ و استفادهٔ مسئولانه یعنی چهار دریچهٔ خواندن، استناد، تجربه و ویرایش — پیش از انتشار، نه بعد از اعتراض خواننده.
اگر خواستید همین گیت را به ممیزی و تولید محتوا وصل کنید، پلن بینش سوئیت ممیزی و ده محتوای سئو در ماه را یکجا میدهد و دموی رایگان پلتفرم مسیرش را نشان میدهد؛ جزئیات در صفحهٔ محصول سوئیت آمده است. برای سنجش وضعیت فعلی سایت هم ممیزی رایگان دامنه نقطهٔ شروع خوبی است.
رصد ما، رشد شما.
سؤالات پرتکرار
نتیجهٔ «۱۰۰٪ ساخت انسان» از این ابزارها معتبر است؟
نه بهعنوان مدرک؛ دادهٔ قطعی از دقت آنها منتشر نشده و خطای هر دو جهت گزارش شده است. به تجربهٔ ما درصد بالا فقط یعنی بررسی جدیتر پیش از انتشار.
گوگل محتوای تولیدشده با هوش مصنوعی را جریمه میکند؟
مستندات گوگل میگوید کیفیت مهم است، نه روش تولید؛ هدف سیاستهای اسپم، تولید انبوه بدون ارزش افزوده است. استفادهٔ مسئولانه با ویرایش انسانی مشکلی ندارد.
بهترین ابزار تشخیص متن AI کدام است؟
بهتنهایی هیچکدام ملاک نیست؛ دو ابزار میتوانند قرینهٔ هم جواب دهند. ترکیب سرنخِ ابزار با گیت ویرایش انسانی نتیجهٔ قابل اتکایی میدهد که هیچ درصدی نمیدهد.
متن فارسی رسمی چرا همیشه «ماشینی» علامت میخورد؟
چون نامههای اداری و مقالههای قالبی ذاتاً یکنواختاند و ابزارها یکنواختی را با ماشینبودن اشتباه میگیرند. این محدودیت سبک است، نه حکم دربارهٔ کیفیت.
حداقل چند کلمه برای نتیجهٔ معنادار لازم است؟
روی متن کوتاه دو-سه پاراگرافی هیچ ابزاری آمار معناداری نمیدهد؛ برای سرنخ، متن کامل مقاله را بسنجید و نتیجه را کنار بازبینی انسانی بگذارید.
میشود کلاً از تولید محتوا صرفنظر کرد و با ابزار کار را ساخت؟
نه؛ ابزار هزینهٔ تولید را کم میکند، نه مسئولیت کیفیت را. بدون دانش موضوعی و ویرایش، خروجی همان محتوای بیروحی میشود که نتیجه نمیدهد.