مطالعهٔ موردی: خطاهای واقعی AI در محتوای تخصصی
مرز با همسایههای هاب: در انتخاب ابزار AI برای تیم محتوا انتخاب ابزار برای تیم محتوا باز شده و در محتوای محصول با هوش مصنوعی تولید محتوای محصول با کمک AI آمده است؛ اینجا پرسش بعدی است — وقتی گردش کار برقرار شد، چه خطاهایی واقعاً سراغتان میآید و کدام لایهٔ کنترل، هر خطا را میگیرد؟ پاسخ کوتاه همین است: چهار خانوادهٔ خطا، چهار دروازهٔ کنترل؛ جزئیات و نمونههای هر دو در ادامهٔ همین مطالعه میآید.
یک شفافسازی روششناختی: این کیس روایت تجربهٔ میدانی ماست — الگوهایی که در بازبینی محتوای تیمهای مختلف دیدهایم — بدون درصد ساختگی؛ هر جا عدد لازم است، میگوییم داده نداریم و چارچوب میدهیم. همین صداقت، خودش اولین درس کیس است: تیمی که آمار نامعتبر را در متن نپذیرد، در هیچ دروازهای کمکاری نمیکند.
کیس؛ تیم محتوای تخصصی و گردش کار AI بهعلاوهٔ انسان
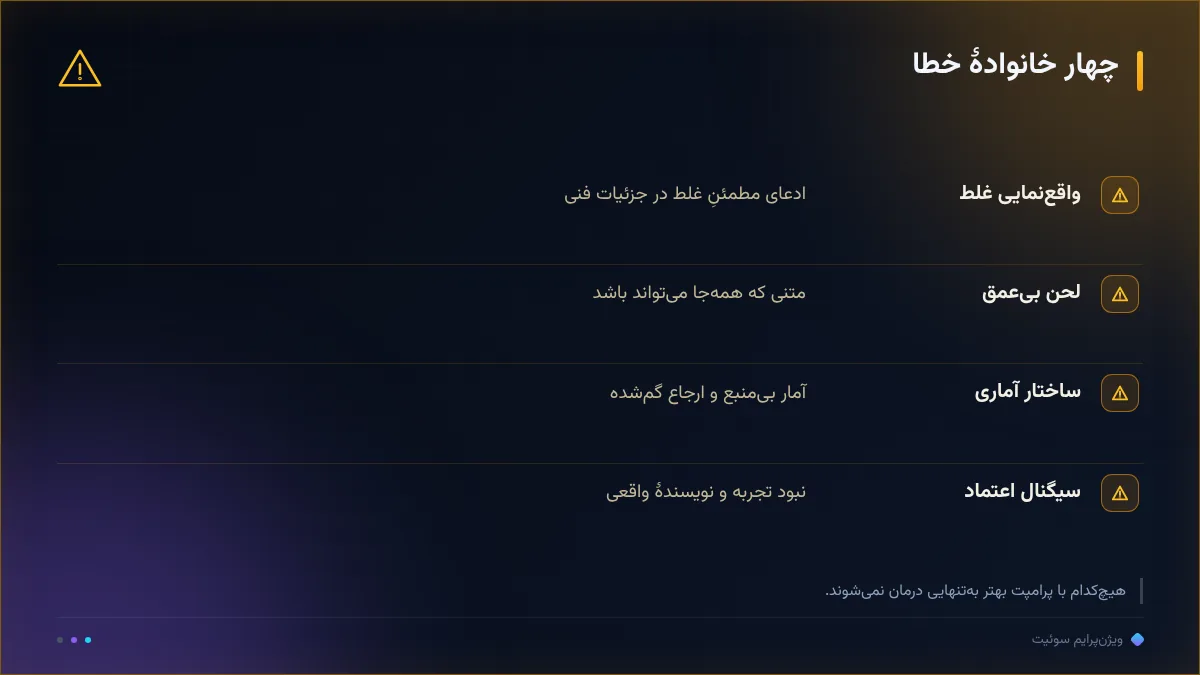
بستر کیس چنین است: تیم محتوای یک کسبوکار تخصصی (مشاورهٔ فنی و B2B) با تقویم فشرده، گردش کار AI بهعلاوهٔ انسان را اجرا کرد: پیشنویس اول با مدل، بازنویسی و تأیید با کارشناس حوزه. در چند ماه بازبینی، چهار خانوادهٔ خطا تکرار شد و الگو آنقدر ثابت بود که به چرخهٔ کنترل تبدیل شد؛ همین الگوها را در ادامه باز میکنیم. نکتهٔ مهم این است که هیچکدام از خطاها «خرابی فنی» نبودند — مدل کار خودش را میکرد؛ شکاف، در لایهٔ نظارت بود.
از تجربهٔ ما تیمهایی که خطا را مشکل ابزار میبینند، ابزار را عوض میکنند و همان خطاها با چهرهٔ تازه برمیگردند؛ تیمهایی که خطا را مشکل فرایند میبینند، دروازهٔ کنترل میسازند و هم خانوادهٔ خطا کم میشود، هم سرعت انتشار حفظ میشود. این تفکیکِ «ابزار یا فرایند» تصمیمساز کل کیس است. روش ثبت الگوها هم ساده بود: هر پیشنویس بعد از انتشار یک بار بازبینی ویرایشی میشد و هر اصلاح، با برچسب نوع خطا در فهرست ثبت میشد؛ بعد از چند دور، توزیع اصلاحها چهار خوشهٔ ثابت را نشان داد. همین سادگی را توصیه میکنیم: شما هم نیازی به داشبورد پیچیده ندارید؛ یک فهرست مشترک با چهار برچسب، بعد از دو ماه چهرهٔ واقعی خطاهای تیم شما را میکشد.
خطاهای واقعنما؛ وقتی مدل با اعتماد بهنفس اشتباه میکند
خانوادهٔ اول، خطاهای واقعنمایی است: جملهای که طبیعی و مطمئن نوشته شده ولی از نظر فنی غلط است — نام افزونهای که وجود ندارد، پارامتری با مقدار پیشفرض غلط، تاریخ رویدادی که چنین نبوده. ویژگی خطرناک این خانواده اعتماد بهنفس لحن است؛ جملهٔ غلط، مطمئنتر از جملهٔ درست به نظر میرسد. در بازبینی کیس، بیشترین بروز این خطاها در مباحث جزئی بود — همانجایی که کارشناس میگوید «جزئی است، نمیخوانم» و دقیقاً همانجا مدل آزادانه میسازد.
کنترل مخصوص، دروازهٔ واقعیت است: هر ادعای قابل راستیآزمایی — نام، عدد، تاریخ، سازگاری — با منبع اولیه چک میشود، نه با «شبیه درست بودن». قاعدهٔ عملی ما: اگر کارشناس نتواند منبع را در سی ثانیه نشان بدهد، جمله یا حذف میشود یا به صیغهٔ محتاط بازنویسی. این دروازه روی کل متن اجرا میشود اما وزنش روی جزئیات فنی است. الگوی پرتکرار در کیس چنین بود: خطای واقعنما تقریباً همیشه در جملههای «قیددار مطمئن» پنهان بود — «همیشه»، «هرگز»، «طبق مستندات رسمی» — بدون اینکه مستنداتی در کار باشد. ویراستار ما یاد گرفت به این سه قید حساس شود؛ هر جا یکی از آنها بود، دروازهٔ واقعیت با وسواس بیشتری اجرا میشد و ادعای بیمنبع بهطور محسوس کم شد.
خطاهای AI در محتوا؛ خانوادهٔ لحن و عمق
خانوادهٔ دوم، خطای لحن و عمق است: متنی که همهجا میتواند باشد — بدون یک تجربهٔ دستاول، بدون مثال واقعی، بدون اختلاف نظر. این متن غلط نیست و همین است که گرانتر از غلط تمام میشود: در نتایج تخصصی، فاصلهٔ «درست اما عمومی» با «قابل اعتماد» دقیقاً همان چیزی است که خوانندهٔ حرفهای تشخیص میدهد و موتور جستجو هم در ارزیابی کیفیت دنبال همین تفاوت است. در کیس، بیشترین بازگشت کاربر به صفحات ویرایشنشده دیده میشد؛ نشانهای که این خطا هزینهٔ رفتاری واقعی دارد.
کنترل مخصوص، دروازهٔ لحن و عمق است: هر بخش باید حداقل یکی از این سه را داشته باشد — تجربهٔ مستند به تجربهٔ ما، مثال واقعی از پروژهها، یا موضع روشن دربارهٔ مناقشهٔ حوزه. اگر هیچکدام نیست، آن بخش یا انسانی میشود یا حذف؛ متنی که هیچ چیز «شما» ندارد، لایق برند شما نیست. برای اینکه این دروازه گران نشود، دو قالب آماده کردیم: قالب «چون دیدیم» که هر ادعای کلی را به یک مشاهدهٔ پروژهای گره میزند و قالب «مخالف ما» که در هر موضوع، یک اختلاف نظر واقعی تیم را مینویسد. این دو قالب نیمساعت کار اضافه میکنند و عمقی میسازند که خوانندهٔ حرفهای در چند خط تشخیص میدهد.
خطاهای ساختاری؛ آمار ساختگی و ارجاع گمشده
خانوادهٔ سوم، خطای ساختاری است و آمار در مرکزش: عددی که بهنظر آماری میآید ولی منبع ندارد، یا منبعش را از دست داده است. الگوی کیس چنین بود: مدل عدد را با لحن قطعی میآورد، ویراستار عدد را نگه میداشت چون «متن را قوی میکند»، و انتشار با آمار بیمنبع انجام میشد. خطای دوم این خانواده، ارجاع گمشده است: نقلقول از منبعی که در متن مشخص نیست و خواننده نمیتواند راستیآزمایی کند.
کنترل مخصوص، دروازهٔ ساختار است و سختگیرانهترین دروازه است: آمار بیرونی فقط با نام منبع و تاریخ گردآوری؛ اگر منبع در دسترس نیست، عدد حذف یا به «بازهٔ برآورد بازار» با قید صادقانه تبدیل میشود. برای درونسازمانی هم قاعده داریم: عدد داخلی فقط با برچسب منبع مکتوب داخلی. این دروازه از تجربهٔ ما بیشترین اصطکاک را دارد و بیشترین ارزش را؛ هر جملهٔ آماری که از این دروازه رد میشود، قابل دفاع است. برای دادهٔ داخلی هم پروتکل کوچکی گذاشتیم: هر عددی که از گزارشهای خود تیم میآید، باید بازهٔ اندازهگیری مکتوب داشته باشد — «سهماههٔ منتهی به فلان تاریخ» — و در متن هم میآید؛ بدون بازه، عدد داخلی هم قابل نقل نیست. این پروتکل از بحثهای بیپایان «این عدد از کجا آمد؟» هم خلاص کرد.
خطاهای سیگنال اعتماد؛ تجربهای که در متن نیست
خانوادهٔ چهارم، نبود سیگنال اعتماد است: متنی که نویسندهٔ انسانی، تجربهٔ میدانی یا مسؤولیت محتوا را نشان نمیدهد — همان چیزی که چارچوب ای-ای-ای-تی روی آن تأکید میکند و در ای-ای-ای-تی چیست و چرا مهم است باز شده است. در کیس، این خانواده جایی پیدا شد که تیم پیشنویس را کامل از مدل میگرفت و فقط تغییرات ظاهری میداد؛ خروجی، متن بینویسنده بود: بدون خط تجربه، بدون جزئیات میدانی، بدون چرایی انتخابها.
کنترل مخصوص، دروازهٔ اعتماد است: امضای نویسندهٔ واقعی با صفحهٔ نویسنده، حداقل یک لایهٔ تجربهٔ دستاول در متن، و شفافیت دربارهٔ نقش AI — اینکه کدام لایه با کمک مدل آمده و چه کسی مسؤول نهایی است. این شفافیت ضعف نیست؛ در بازار تخصصی، خوانندهای که بداند متن از چه مسیری آمده، اعتماد بیشتری میکند تا متنی که ادعای انسانی بینشانه دارد. لایهٔ دوم این دروازه بیرونِ متن است: صفحهٔ نویسندهٔ واقعی با سابقهٔ مرتبط، صفحهٔ دربارهٔ ما که مسؤولیت محتوایی را روشن میکند و راه ارتباطی که خواننده بتواند ایراد بگیرد. این لایه یک بار ساخته میشود و به همهٔ انتشارها وصل میماند؛ سایتهایی که این زیرساخت را ندارند، هر پیشنویس خوبی را با زیربنای بیاعتبار منتشر میکنند.
چرخهٔ کنترل ویرایشی؛ چهار دروازه پیش از انتشار
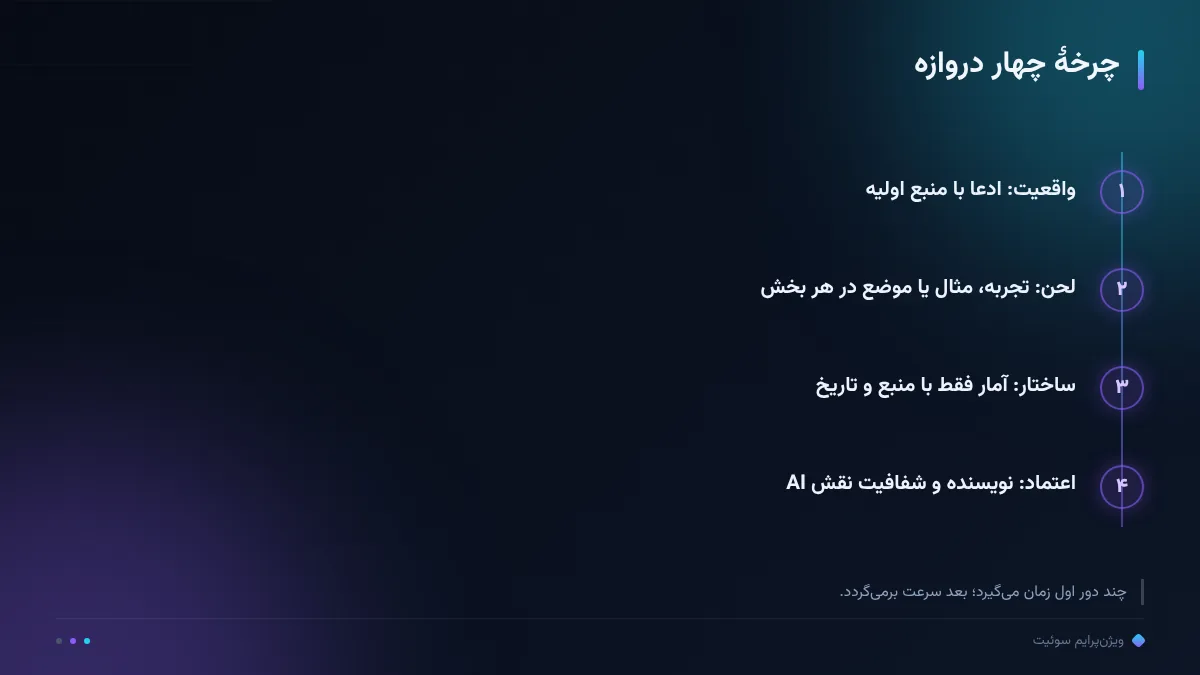
چهار دروازه بهترتیب اجرا میشوند و هر کدام پاسخ روشن میخواهند. دروازهٔ اول، واقعیت: ادعاها با منبع اولیه؛ ردشدنی ندارد. دروازهٔ دوم، لحن و عمق: تجربه، مثال یا موضع در هر بخش. دروازهٔ سوم، ساختار: آمار فقط با منبع و تاریخ، ارجاعها قابل پیگیری. دروازهٔ چهارم، اعتماد: نویسنده، تجربه، شفافیت نقش AI. از تجربهٔ ما این چرخه در ابتدا زمان میگیرد و بعد از چند دور، ویراستار الگوها را آنقدر میشناسد که سرعت به حالت عادی برمیگردد — با متنی که قابل دفاع است.
جمعبندی کیس در یک جمله است: AI سرعت تولید را داد و چرخهٔ کنترل، اعتبار را نگه داشت؛ بدون چرخه، سرعت فقط آهنگ تولید خطا را بالا میبرد. اگر محتوای فعلی شما با این چهار خانواده نمیخواند، ممیزی رایگان دامنه نقاط ضعف را مشخص میکند و اگر ظرفیت گردش کار انضباطی گلوگاه است، پک محتوای سئو همین استانداردها را در تقویم محتوایی اجرا میکند؛ چرخه را از پیشنویس بعدیتان شروع کنید — چهار دروازه، چهار پاسخ، انتشار قابل دفاع. ادامهٔ نقشه — از انتخاب ابزار تا گردش کار تیمی — در هاب هوش مصنوعیها برای محتوا نگه داشته میشود و این کیس، ستون تشخیصی آن هاب است. یک توصیهٔ اجرایی برای شروع: دروازهها را همزمان راه نیندازید؛ از دروازهٔ واقعیت شروع کنید که بیشترین ریسک را میبندد، بعد ساختار، بعد لحن و اعتماد. و مقاومت تیم را جدی بگیرید: ویراستاری که فکر میکند این چرخه برای کندکردن اوست، راههای میانبر پیدا میکند؛ نقش چرخه را در جلسهٔ تیم توضیح بدهید — سرعت تولید که حفظ میشود، اعتبار است که دیگر نمیسوزد.
رصد ما، رشد شما.
سؤالات پرتکرار
خطاهای AI را میشود فقط با پرامپت بهتر درمان کرد؟
نه بهتنهایی؛ به تجربهٔ ما پرامپت بهتر فراوانی خطا را کم میکند اما حذف نمیکند. درمان پایدار، چرخهٔ کنترل ویرایشی است: چهار دروازه پیش از انتشار.
مهمترین دروازه کدام است؟
دروازهٔ واقعیت — چککردن هر ادعای قابل راستیآزمایی با منبع اولیه. بیشترین خطای اعتبارِ تخریبکننده از خانوادهٔ واقعنمایی میآید.
آمار ساختگی مدل را چطور تشخیص دهیم؟
قاعده ساده است: آمار بیرونی فقط با نام منبع و تاریخ گردآوری میماند؛ اگر منبع در سی ثانیه پیدا نشد، عدد حذف یا به بازهٔ برآورد با قید صادقانه تبدیل میشود.
آیا باید استفاده از AI را در متن اعلام کنیم؟
شفافیت دربارهٔ نقش AI و مسؤولیت نهایی نویسندهٔ انسانی، اعتماد را کم نمیکند؛ بالا میبرد. سیگنالهای تجربهٔ دستاول را هم جایگزین نمیکند.