چکلیست robots.txt درست؛ ۱۰ مورد قبل از انتشار
راهنمای گامبهگام آموزش گامبهگام نوشتن robots.txt ساخت فایل را از صفر باز میکند؛ این مقاله گیتِ دهموردی پیش از انتشار است: فایل را نوشتهاید و میخواهید مطمئن شوید بیخطر است. فاصلهٔ این دو مهم است، چون robots.txt تنها فایل پرریسک سایت است؛ یک خط اشتباهش میتواند کل دامنه را از خزنده پنهان کند.
چرا پیش از انتشار؟ چون اثر این فایل فوری و سراسری است: خطای صفحهای در محتوا یک صفحه را کماثر میکند، اما خطای robots.txt میتواند فروشگاه، نقشهٔ سایت و مسیرهای فایل را یکجا از دید خزنده ببرد و کشفش سخت است. گیت پایین، ده چک را از بنیان تا تست نهایی مرتب میکند؛
چکلیست robots.txt درست چرا پیش از انتشار میآید؟
کاری که این فایل میکند و نمیکند را از همین ابتدا روشن کنید: robots.txt به خزنده میگوید کدام مسیرها را نخزد؛ دربارهٔ ایندکس حرف نمیزند. صفحهای که بسته شده ممکن است همانطور — حتی بدون محتوا — در نتایج دیده شود، چون گوگل آدرس را از لینکهای بیرونی شنیده است. پس کارِ اصلی این فایل صرفهجویی در خزش است، نه حذف از نتایج؛ این تفاوت، سر و روی همهٔ قاعدهها را عوض میکند ده چکِ گیت هم روی همین فهم بنا شدهاند و همین را باید در ذهن نگه دارید
گیت دو زمانِ اصلی دارد: پیش از راهاندازی دامنه یا سابدامنهٔ تازه، و پیش از هر تغییر بزرگ — مهاجرت، تعویض قالب، افزودن زیرساخت. فایلهایی که سالها بدون بازبینی ماندهاند معمولاً قواعد روزهای اول را دارند و مسیرهای تازهٔ سایت بدون قاعده مانده است. نسخهٔ فعلی را با تاریخ در پروندهٔ تیم نگه دارید تا تفاوتها قابل مقایسه و بازگشت باشند؛ این پروندهٔ کوچک، حافظهٔ فنی دامنه است.
بنیان فایل؛ مسیر ریشه و قواعد ساده
مورد اول، جای فایل: robots.txt باید در ریشهٔ دامنه با همین نام و حروف کوچک در دسترس باشد؛ آدرسِ «example.com/robots.txt» — نه در پوشهٔ قالب و نه با پسوند دیگر. طبق مستندات Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵) فایل باید در ریشهٔ دامنه باشد و خزنده همانجا به دنبالش میرود. مورد دوم، یکتایی: هر زیردامنه فایل خودش را میخواهد؛ «blog.example.com» بدون فایل، قواعد دامنهٔ اصلی را به ارث نمیبرد.
مورد سوم، ساخت قواعد است: هر بلوک با User-agent شروع میشود و خطهای Disallow زیر آن میآیند؛ مسیرها نسبت به ریشه نوشته میشوند و قاعدهٔ خالی یعنی «همهچیز مجاز». ساده بنویسید و برای هر بلوک کامنت بگذارید: فایلی که سال بعد کسی نفهمد چرا مسیری بسته شده، در بازبینی بعدی کورکورانه باز میشود. چند بلوکِ کم و خوانا، همیشه از دهها قاعدهٔ تو در تو بهتر است.
مورد چهارم، کدگذاری و حجم: فایل متنی سادهٔ UTF-8 و در حد چند کیلوبایت؛ خطای کدگذاری میکند که خزنده کل فایل را نادیده بگیرد و همهچیز را مجاز فرض شود. قواعد بیاثر را حذف کنید — قاعدهای که مسیری را میبندد که اصلاً وجود ندارد، فقط خوانایی را میگیرد. وقتی این چهار مورد بنیان رد شد، سراغ منعها بروید؛ جایی است که بیشترِ دامنهها میسوزند.
منعها؛ چه چیزی را ببندیم و چه چیزی را نه
مورد پنجم، انتخاب مسیرهای بسته است. آنچه بسته میشود فقط مسیرهای بیارزشِ خزش باشد: پنل مدیریت، سبد خرید و تسویهحساب، نتایج جستوجوی داخلی، پارامترهای نشست و فایلهای فنی. ارزش هر بستن با یک پرسش سنجیده میشود: اگر خزنده این مسیر را نمیخزد، چه چیزی از دست میدهد؟ اگر پاسخ «هیچ» است، بستن درست است؛ اگر پاسخ «فهم صفحههای دیگر» است، همانجا باز بگذارید.
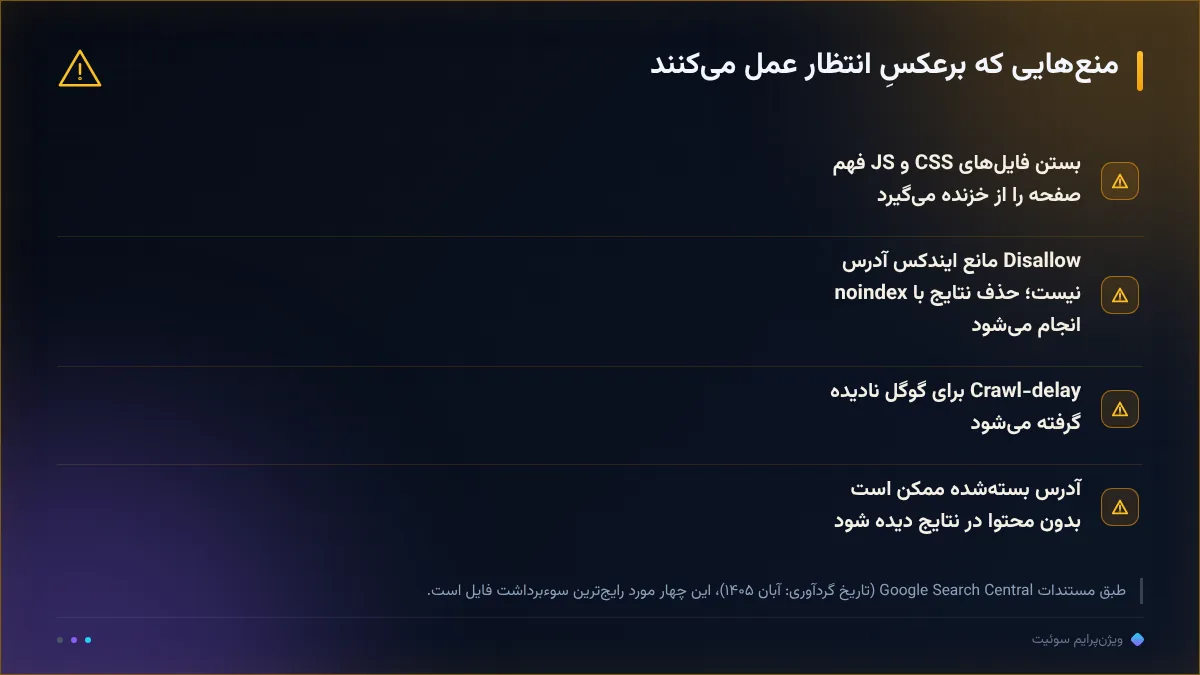
دو منعِ برعکسِ انتظار را حتماً بدانید. اول، CSS و JS را نبندید؛ خزنده باید صفحه را همانطور که مرورگر میبیند ببیند وگرنه فهمش از صفحه ناقص میشود و رندر درست از دست میرود. دوم، Disallow جایگزین noindex نیست: طبق مستندات Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵) بستن مسیر مانع ایندکس نیست و گوگل هم Crawl-delay را نادیده میگیرد؛ برای حذف از نتایج، خود صفحه باید noindex باشد و در دسترس خزنده بماند.
نتیجهٔ عملی این دو: اگر صفحهای متای noindex دارد، مسیرش را در robots.txt نبندید؛ خزنده باید صفحه را ببیند تا noindex را بخواند. بستن مسیرِ صفحهٔ noindexشده رایجترین تعارض ممیزیهای ماست؛ نتیجهاش آدرسهایی است که نه خزیده میشوند و نه از نتایج میروند.
نقشهٔ سایت و دستورهایی که اثر ندارند
مورد ششم، معرفی نقشهٔ سایت: دستور Sitemap با آدرس مطلق نوشته میشود — کامل از https تا انتهای فایل — و همان نقشه در سرچکنسول هم ثبت شده باشد. این دستور اختیاری است اما مسیر کوتاهی میسازد تا خزنده صفحات ارزشمند را از مسیر رسمی بیابد؛ الگوی آدرسها و ساخت نقشهٔ سالم در الگوهای آدرس و نقشهٔ سایت XML سالم گامبهگام باز شده است و دو فایل از روز انتشار باید با هم همخوان بمانند و در بازبینی فصلی کنار هم دیده شوند.
مورد هفتم، شناخت دستورهای بیاثر است تا به آنها اتکا نکنید: Crawl-delay برای گوگل نادیده گرفته میشود و اگر نگران فشار روی سرورید، راهحل واقعی ظرفیت سرور و پایش لاگ است؛ نوشتن Noindex داخل robots.txt اثر ندارد و Allow فقط در موارد مشخص معنا میگیرد. قاعدهٔ کلی: هر دستوری را که نمیدانید چرا هست، پرسش کنید؛ این فایل جای امید و حدس نیست و هر خطش باید کار مشخصی داشته باشد.
خطاهای رایجی که دامنه را میسوزاند
پنج خطای رایج را تیک بزنید. یکی، «Disallow: /» بهجامانده از محیط آزمایشی — رایجترین عامل ناپدیدشدن کامل دامنه بعد از مهاجرت. دو، بستن مسیرهای CSS و JS قالب تازه. سه، تعارض با noindex که بالاتر توضیح داده شد. چهار، آدرس نقشهٔ سایت بهصورت نسبی که خوانده نمیشود. پنج، فایل خالی یا خطای سرور در جای فایل؛ در نبود فایل خزنده همهچیز را مجاز فرض میکند، اما وضعیتِ نامشخص خطر است، نه راحتی.
اثر این خطاها به مسیرهای بسته ختم نمیشود؛ صفحاتی که به آدرسهای بسته لینک میدهند اعتبارشان در مسیر بنبست مینشیند و گزارش خطاهای خزش سرچکنسول پر از آدرسهای بیدلیل میشود. چرخهٔ کامل پیداکردن و رفع این وضعیتها در چرخهٔ پایش خطای 404 و لینکهای شکسته آمده است؛
راه تشخیص زودهنگام، مقایسه است: فهرست مسیرهای بستهٔ فایل را کنار صفحات مهم دامنه بگذارید و بپرسید کدام صفحهٔ پولساز به مسیری میرسد که بسته شده. این پرسش پنجدقیقهای در ممیزیهای ما چند بار دامنهها را از هفتهها نادیدهماندن نجات داده است؛
تست، انتشار و پایش فصلی
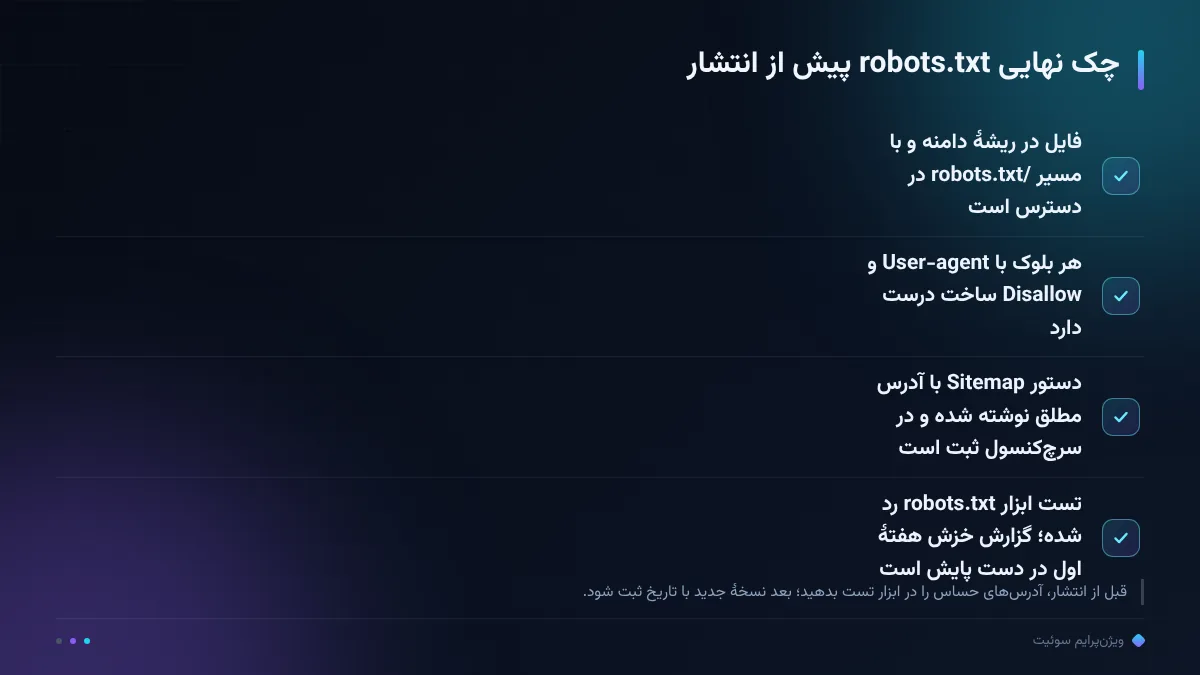
مورد هشتم تا دهم تست و پایشاند. پیش از انتشار، فایل را در ابزار تست robots.txt آزمایش کنید: آدرسهای حساس را یکییکی بدهید و ببینید اجازه یا منع از کدام قاعده میآید. بعد از انتشار، گزارشهای خزش و پوشش ایندکس سرچکنسول را هفتهٔ اول ببینید تا افت نمایش یا جهش خطاها را زود بگیرید؛
پایش فصلی هم به همین گیت بچسبد: با هر مهاجرت، قالب تازه یا زیرساخت جدید، گیت دوباره اجرا و نسخهٔ جدید در پروندهٔ تیم ثبت میشود. زنجیرهٔ کامل رصد تا انتشار امن، کاری است که پلتفرم سوئیت در امکانات و خدمات سوئیت یکجا بسته است تا گیتهای فنی مثل همین فایل در شلوغی انتشار از یاد نروند.
یک عادت دیگر هم اضافه کنید: بعد از هر تغییر فایل، دو گزارش سرچکنسول را در همان هفته با هفتهٔ پیش مقایسه و در پروندهٔ تیم بنویسید. صفحهٔ فنی بدون سند، دو ماه بعد برای همهٔ تیم ناشناخته است
جمعبندی؛ ده مورد در ده دقیقه
جمعبندی ده مورد: ریشهٔ دامنه و یکتایی فایل، ساخت درست قواعد، کدگذاری سالم، بستنِ فقط مسیرهای بیارزش، بازماندن CSS و JS، نقشهٔ سایت با آدرس مطلق، شناخت دستورهای بیاثر، پرهیز از پنج خطای رایج، تست پیش از انتشار و پایش بعد از آن. فایلی که این ده چک را رد کند، دیگر منبع ناپدیدشدن دامنه نیست؛ ابزار صرفهجویی در خزش است
اگر فایل فعلی دامنهتان را از بر نیستید، از دیدِ وضع شروع کنید: ممیزی رایگان دامنه وضعیت خزش و ایندکس را پیش از هر تغییر نشان میدهد و نقشهٔ کامل مقالههای فنی در هاب سئو فنی مرتب است. قاعدهٔ آخر را هم مکتوب کنید: هیچ تغییری در robots.txt بدون تست و بدون نسخهٔ ثبتشده در پروندهٔ تیم اعمال نمیشود
اگر فقط یکی از این ده مورد را فردا اجرا میکنید، مورد تست پیش از انتشار را بردارید؛ هیچ چک دیگری اینقدر ارزان و نجاتبخش نیست. باقی موارد هم با فصلیشدن بازبینی — سه ماه یکبار و بعد از هر تغییر بزرگ — خودشان به عادت تیم تبدیل میشوند.
رصد ما، رشد شما.
سؤالات پرتکرار
فایل robots.txt چند بار در سال بازبینی میشود؟
حداقل فصلی، و همیشه بعد از مهاجرت، تعویض قالب یا افزودن سابدامنه. تغییر کوچک در مسیرهای سایت یعنی بازبینی همان روز.
بستن یک صفحه در robots.txt آن را از گوگل حذف میکند؟
نه؛ طبق مستندات Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵) Disallow خزش را میبندد نه ایندکس را. برای حذف از نتایج، noindex روی خود صفحه لازم است.
برای کمکردن فشار خزنده، Crawl-delay بگذاریم؟
برای گوگل بیاثر است. اگر سرور زیر فشار است، ظرفیت سرور را رفع کنید و لاگ و گزارش خزش سرچکنسول را پایش کنید.
دستور Sitemap داخل robots.txt لازم است؟
پیشنهاد میشود؛ با آدرس مطلق نوشته شود و همان نقشه در سرچکنسول هم ثبت باشد تا دو مسیر همخوان بمانند.
محیط آزمایشی و مسیرهای مدیریت را میبندیم؟
بله؛ محیط آزمایشی را با رمز و در صورت نیاز با Disallow ببندید، اما مطمئن شوید نسخهٔ زنده هرگز فایل staging را به ارث نمیبرد — رایجترین عامل ناپدیدشدن دامنه همین است.