آموزش گامبهگام نوشتن robots.txt درست
robots.txt اولین سندی است که هر خزندهٔ معتبر، قبل از ورود به سایت شما میخواند. اگر این فایل نباشد، خزنده آزاد است همهجا برود؛ اگر نادرست باشد، ممکن است برگههای پرداخت، نتایج جستجوی داخلی یا صفحات پنل کاربران را ببلعد و بودجهٔ خزش را هدر بدهد. در بدترین حالت دیدهشدهٔ ما، یک خط «Disallow: /» در فایل استیجینگ منتقلشده به دامنهٔ اصلی، هفتهها صفحات فروشگاه را از خزیدن انداخته بود و رشد رتبهها متوقف شد؛ چون صفحهای که خزیده نشود، بهروزرسانی هم نمیشود.
نکتهٔ مهمی که در جلسات ممیزی مدام تکرار میکنیم: مسدودکردن در robots.txt یعنی «نخزن»، نه «از نتایج حذف شو». صفحهای که مسدود است ولی لینک بیرونی دارد، ممکن است همچنان بدون توضیحات در نتایج ظاهر شود. پس این فایل ابزار مدیریت خزش است، نه ابزار حذف از ایندکس؛ برای حذف، مکانیزمهای دیگری مثل حذف URL در سرچکنسول یا تگ noindex وجود دارد.
robots.txt چیست و چه کاری در خزش میکند؟
robots.txt یک فایل متنی ساده است که طبق پروتکل حذف رباتها (RFC 9309) رفتار خزندهها را تنظیم میکند (تاریخ گردآوری: آبان ۱۴۰۵). هر خزندهٔ شناختهشدهای — از Googlebot تا باتهای موتورهای فارسی — اول این فایل را از ریشهٔ دامنه میگیرد و تصمیم میگیرد کدام مسیرها را بخزد. قاعدهها مسیرمحورند: یعنی پیشوندِ مسیر را با آدرس مقایسه میکنند، نه کل آدرس را. به همین دلیل «Disallow: /cart» هم «/cart» و هم «/cart/checkout» را میپوشاند؛ این رفتار پیشوندی، هم ابزار قدرتمند فایل است و هم منبع بیشترین اشتباهها.
دستهای از خزندهها قاعدهها را برای گروه خودشان میخواهند: با بلوکهای User-agent جدا میتوانید برای Googlebot و برای باتهای ناشناس رفتار متفاوت تعریف کنید. در ممیزیهایمان معمولاً یک گروه عمومی برای همهٔ خزندهها کافی است و گروههای اختصاصی فقط وقتی معنا میگیرند که بخواهید رفتار یک خزندهٔ خاص را متفاوت کنید.
robots.txt درست: قالب استاندارد و دستورهای اصلی
یک robots.txt درست چهار جزء دارد: گروه User-agent، قاعدههای Disallow و Allow، و معرفی نقشهٔ سایت. جدول زیر خلاصهٔ کاربرد هر دستور است:
| دستور | کارش چیست | نکتهٔ مهم |
|---|---|---|
| User-agent: * | گروه قواعد برای همهٔ خزندهها | خزندهٔ خاص فقط بلوک خودش را میخواند |
| Disallow: /مسیر | ممنوعکردن خزش یک پیشوند مسیر | خالی یعنی بدون ممنوعیت؛ / یعنی کل سایت |
| Allow: /مسیر | استثناکردن مسیر داخل یک Disallow | برای بازگذاشتن فایلهای css/js کنار Disallow مفید است |
| Sitemap: آدرس | معرفی نقشهٔ سایت به خزندهها | آدرس مطلق با https میگیرد، نه مسیر نسبی |
| Crawl-delay | فاصلهٔ بین درخواستها | گوگل از آن چشمپوشی میکند؛ روی سرعت سرور اثر مستقیم دارد |
خلاصهٔ دستورهای استاندارد؛ جزئیات کامل در مستندات پروتکل (تاریخ گردآوری: آبان ۱۴۰۵).
در وردپرس استاندارد، دو مسیر بیشترین بحث را میسازند: «/wp-admin/» که معمولاً ممنوع میشود (بهجز Allow: /wp-admin/admin-ajax.php که کارکرد سایت به آن وابسته است) و مسیرهای نتایج جستجوی داخلی مثل «/?s=» که بلاکردنشان از ساخت صفحات بیکیفیت جلوگیری میکند. در ووکامرس، سبد خرید و تسویهحساب («/cart/» و «/checkout/») کاندیدای ممنوعسازیاند، چون محتوای یکتایی ندارند و بودجهٔ خزش را میبلعند.
آموزش گامبهگام نوشتن فایل در هفت قدم
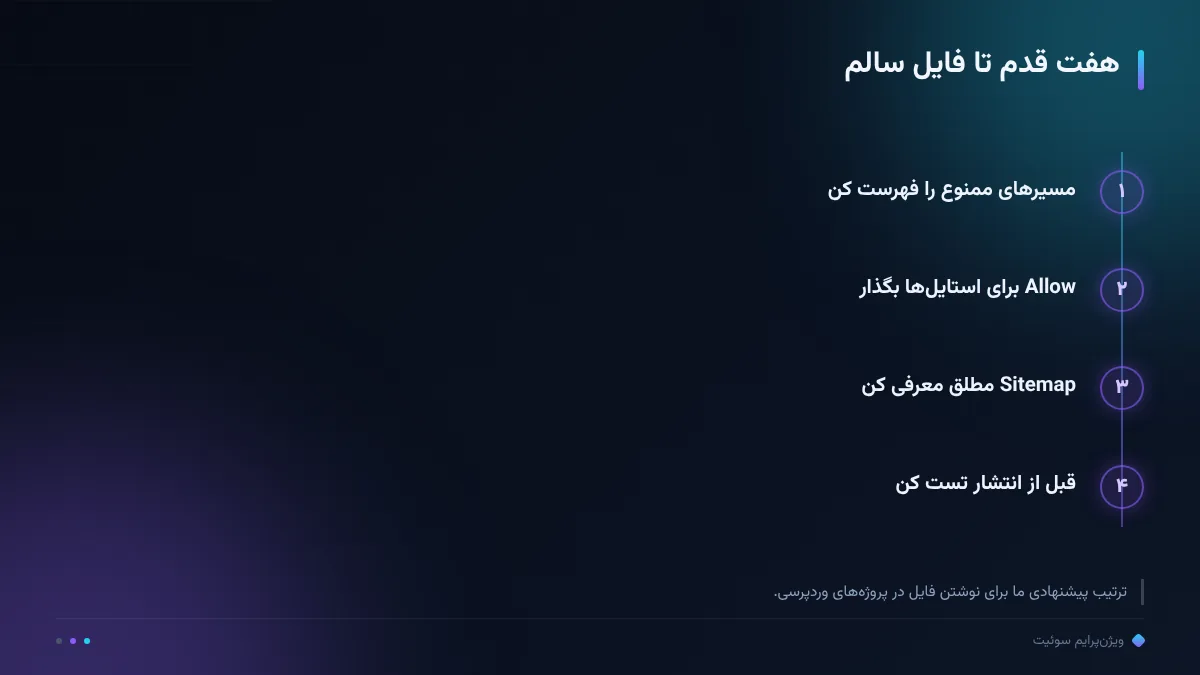
قدم اول، فهرستکردن چیزی است که نباید خزیده شود: پنلها، نتایج جستجوی داخلی، پارامترهای رهگیری، صفحههای تشکر و پرداخت. قدم دوم، مسیرهایی است که باید آزاد بمانند حتی داخل مسیرهای ممنوع: فایلهای استایل و اسکریپت، چون گوگل برای رندر و تحلیل صفحه به آنها نیاز دارد. قدم سوم نوشتن گروه عمومی است؛ قدم چهارم افزودن Allow برای استثناها؛ قدم پنجم معرفی نقشهٔ سایت با آدرس مطلق؛ قدم ششم تست در ابزار گزارش robots.txt سرچکنسول؛ و قدم هفتم، انتشار و پایش دو هفتهایِ خطاهای خزش. این ترتیب ساده، ۹۰ درصد خطاهای رایج را قبل از انتشار میگیرد.
یک نمونهٔ آماده برای فروشگاه وردپرسی با ووکامرس:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /cart/
Disallow: /checkout/
Sitemap: https://example.ir/sitemap_index.xml
این قالب را کپی نکنید و منتشر کنید؛ اسم دامنه را بگذارید، مسیرهای اختصاصی قالب خودتان را اضافه کنید و حتماً قدم ششم یعنی تست را اجرا کنید. فایلی که بدون تست میرود سرِ سایت، ریسکش بهمراتب بیشتر از سودش است.
اشتباههای رایجی که ترافیک را میکشند
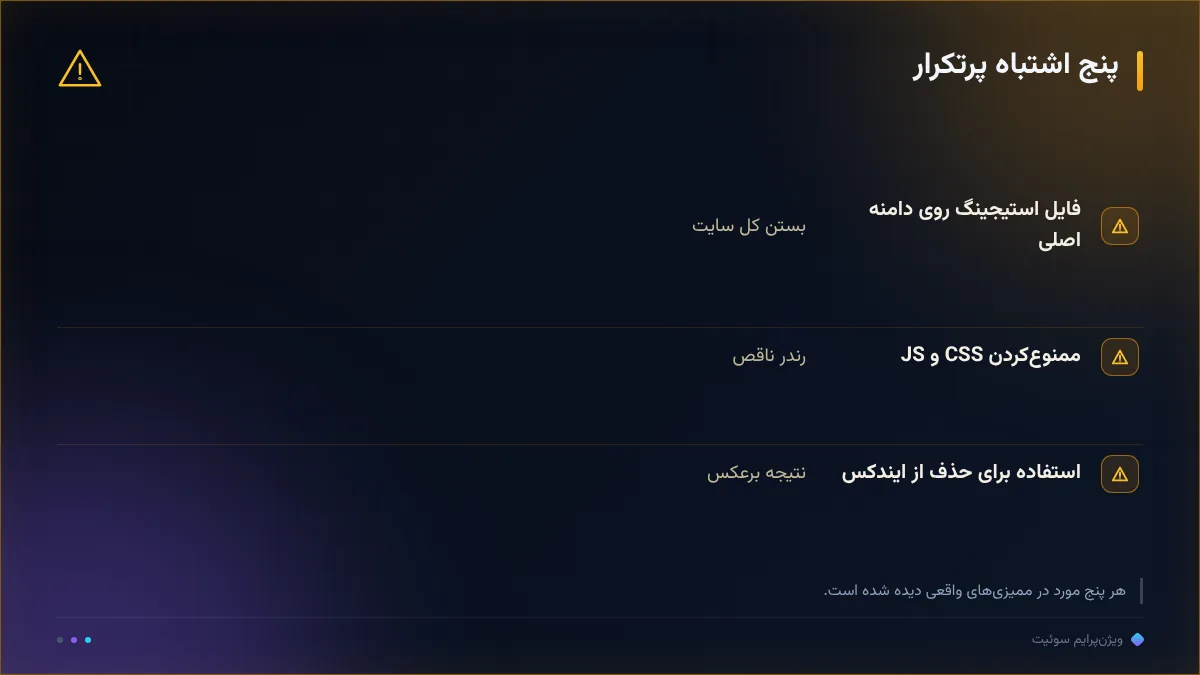
پرتکرارترین اشتباه، انتشار فایل استیجینگ روی دامنهٔ اصلی است؛ فایلی که حاوی «Disallow: /» بوده و کل سایت را میبندد. بعد از آن، ممنوعکردن پوشهٔ قالب یا افزونههایی میآید که CSS و JS را سرو میکنند — نتیجهاش رندر ناقص و افت درک گوگل از صفحه است. اشتباه سوم، بلاکردن تصاویر برای «کاهش فشار سرور» است که سایت را از جستجوی تصویر حذف میکند. اشتباه چهارم، استفادهٔ اشتباه از robots.txt برای حذف از نتایج است؛ مسدودشده خزیده نمیشود، پس دستور noindex داخل صفحه هرگز دیده نمیشود و آدرس میماند. اشتباه پنجم، آدرس نسبی برای Sitemap است که نادیده گرفته میشود.
در ممیزیهای دهصفحهای، هر بار حداقل یکی از این پنج مورد را میبینیم؛ برای همین قدم ششم راهنما، تست قبل از انتشار است، نه بعد از افت ترافیک.
رابطهٔ robots.txt با نقشهٔ سایت
نقشهٔ سایت و robots.txt دو نقش مکمل دارند: نقشه میگوید «این صفحات مهماند، ببین» و robots.txt میگوید «این مسیرها را نیا». خط Sitemap داخل robots.txt مسیر کشف را برای خزندههای تازهوارد کوتاه میکند، ولی جایگزین ثبت نقشه در سرچکنسول نیست؛ هر دو را انجام دهید. یک قانون طلایی: هیچ صفحهای که داخل نقشهٔ سایت است نباید در robots.txt ممنوع باشد — این تناقض، سیگنال کیفیت را مخدوش میکند و در گزارشهای خزش بهشکل نوسان ایندکس دیده میشود.
برای سایتهای محتوایی بزرگ، رصد هفتگی «Discoverd - currently not indexed» کنار وضعیت robots.txt کمک میکند بفهمید آیا فایل دارید صفحات خوب را از مسیر خزش دور میکنید یا نه.
تست فایل قبل از انتشار
گزارش robots.txt در سرچکنسول، نسخهٔ زندهٔ فایل را میخواند، تاریخ آخرین بهروزرسانی را نشان میدهد و اجازه میدهد آدرسهای مشخص را تست کنید تا ببینید تحت قاعدههای فعلی خزیده میشوند یا نه (تاریخ گردآوری: آبان ۱۴۰۵). پیش از انتشار، همین تست را روی فایل جدید اجرا کنید؛ در محیط استیجینگ هم میتوانید با ابزارهای خط فرمانی باز بودن مسیرها را شبیهسازی کنید. بعد از انتشار هم دو هفته گزارش خطاهای خزش را زیر نظر بگیرید و تغییرات مهم ایندکس را با تاریخ تغییر فایل مقایسه کنید. این روتین کوچک، ما را در پروژهها از چند خطای بزرگ نجات داده است.
جمعبندی: چند خط، اثر بزرگ
robots.txt کوچکترین فایل سایت شماست و یکی از پراثراترینها. یک robots.txt درست سه کار میکند: بودجهٔ خزش را روی صفحات ارزشساز متمرکز میکند، صفحات بیکیفیت را از خزش دور نگه میدارد و مسیر کشف نقشهٔ سایت را باز میگذارد. اگر مطمئن نیستید فایل فعلیتان سالم است، ممیزی رایگان دامنه همین بخش را در کنار نه لایهٔ دیگر بررسی میکند؛ و اگر خروجی ممیزی را میخواهید خودکار به اجرا برسانید، هاب سئو فنی و هاب سنجش و سرچکنسول نقشهٔ کامل مسیر را میدهند. به تجربهٔ ما، اصلاح همین فایل در سایتهای وردپرسی بزرگ، ظرف یک تا دو ماه در گزارش خزش اثر عددی روشنی میگذارد؛ چون مشکلی که مانع ورود خزنده میشود، قبل از هر بهینهسازی دیگری باید برداشته شود.
رصد ما، رشد شما.
سؤالات پرتکرار
فایل robots.txt دقیقاً کجا قرار میگیرد؟
در ریشهٔ دامنه؛ یعنی باید با آدرس example.ir/robots.txt باز شود. در وردپرس معمولاً روت پروژه یا با فیلتر robots_txt قابل بازنویسی است.
آیا Disallow یعنی صفحه از گوگل حذف میشود؟
نه. Disallow فقط خزش را قطع میکند. صفحهای که لینک بیرونی دارد ممکن است بدون توضیحات در نتایج بماند؛ حذف واقعی با noindex یا حذف URL انجام میشود.
سایتی که اصلاً robots.txt ندارد مشکل دارد؟
سایتهای کوچک معمولاً بدون آن هم سالماند، چون همهچیز آزاد است. از جایی که صفحات پنل، جستجوی داخلی یا کاتالوگ بزرگ پیدا میشود، مدیریت خزش ارزش واقعی پیدا میکند.
تغییر robots.txt چه زمانی اثرش را نشان میدهد؟
فایل همان لحظه سرو میشود، ولی اثر روی خزش تدریجی است؛ گوگل معمولاً فایل را کمتر از یک روز کش میکند و تغییر رفتار خزش را طی چند روز میبینید.
Crawl-delay برای فشار کمتر روی سرور خوب است؟
برای گوگل بیاثر است و از آن چشمپوشی میکند. اگر فشار سرور جدی است، راه درست ارتقای هاست یا استفاده از CDN است، نه این دستور.