سیاست گوگل درباره محتوای AI برای سایتهای فارسی؛ نکتههای مخصوص بازار ایران
- سیاست گوگل درباره محتوای AI در دو جمله؛ ملاک کیفیت است
- تفاوت این بحث با AI Overviews و GEO
- برای فارسی چه چیزهایی سنگینتر میشود؟
- ویرایش انسانی؛ چهار ایستگاه از پیشنویس تا انتشار
- راستیآزمایی اعداد و ادعاها؛ قانون منبع و تاریخ
- ترجمهها و محتوای بینزبانه؛ کپی نکنید، بومی کنید
- شش اشتباه رایج بازار ایران و راهحل هرکدام
- فرایند سهلایهٔ انتشار و جمعبندی
در ممیزیهایمان، پرسش «اگر با هوش مصنوعی بنویسم گوگل سایت را جریمه میکند؟» از همهٔ پرسشهای فنی تکرارشوندهتر است. پشت این پرسش یک نگرانی واقعی نشسته: مدیر سایت فارسی همتاهای خودش را دیده که با متنهای خام ضربه خوردهاند و نمیداند مرز کجاست. پاسخ کوتاه را در آغاز خواندید؛ اما همین پاسخ بدون لایهٔ اجرایی، هیچ تصمیم روزمرهای در تیم محتوا عوض نمیکند.
برای اینکه جای این مطلب در خوشه دقیق شود: سیاست گوگل درباره محتوای AI؛ مرز میان پذیرش و اسپم سیاست را با تاریخچه و آزمونهای پیش از انتشار توضیح داده؛ AI Overviews چیست و وضعیت فارسی کجاست سراغ لایهٔ پاسخ گوگل در نتایج رفته و چگونه در منابع AI ذکر شویم برای سایتهای فارسی مسیر GEO را باز کرده است. این مقاله لایهٔ سوم است: بعد از اینکه فهمیدید مجاز است، دقیقاً چه کارهایی متن فارسی شما را به استاندارد میرساند.
سیاست گوگل درباره محتوای AI در دو جمله؛ ملاک کیفیت است
گوگل موضعش را بارها و بهشکل عمومی تکرار کرده است: راهنمای Search Central میگوید رتبهبندی به محتوایی پاداش میدهد که برای مردم ساخته شده، نه برای موتور جستجو؛ و ابزار تولید — قلمِ انسانی یا مدل زبانی — در این گفته متغیر تعیینکننده نیست (تاریخ گردآوری: آبان ۱۴۰۵). سمت تاریک مرز هم روشن است: سیاست اسپم گوگل با تولید انبوه صفحات بیارزش — آنچه گوگل «سوءاستفادهٔ مقیاسی» مینامد — برخورد میکند، فارغ از اینکه انبوهسازی با دست انجام شده یا با اتوماسیون.
اگر بخواهیم همین گفتهٔ عمومی را با رصد سایتهای فارسی ترجمه کنیم: صفحاتی که یک پرسش واقعی را کامل جواب میدهند و ارزش یکتایی دارند، در بهروزرسانیهای هستهٔ اخیر سرِ جای خود ماندهاند؛ صفحاتی که برای پوشش کلمهها انبوه تولید شدهاند جا خالی کردهاند. به تجربهٔ ما این با روند عمومی گفتهٔ خود گوگل دربارهٔ بهروزرسانیهای هسته سازگار است: تمرکز بر کیفیت کلی محتوا، نه یک ترفند مشخص (تاریخ گردآوری: آبان ۱۴۰۵).
یک نکتهٔ مخصوص بازار ایران: آمار رسمی جریمه یا سهم محتوای AI در نتایج فارسی منتشر نمیشود و هر عدد بیمنبعی در این باره را با احتیاط بخوانید. چیزی که قابل اندازهگیری است رفتار صفحات خودتان است؛ چهار سنجهٔ رسمی سرچکنسول — نمایش، کلیک، CTR و میانگین جایگاه — پیش و پس از هر تغییر محتوایی، حکم را میسازند.
تفاوت این بحث با AI Overviews و GEO
سه بحث در این خوشه کنار هم پیدا میشوند و اگر قاطی شوند، هر سه را غلط اجرا میکنید. بحث اول «مجاز بودن»: سیاست گوگل چه میگوید و مرز اسپم کجاست — موضوع همین مقاله. بحث دوم «ماندن در لایهٔ پاسخ»: AI Overviews لایهٔ خلاصهٔ تولیدی گوگل در بالای نتایج است و اثرش بر کلیک جداگانه بررسی شده. بحث سوم «ذکر شدن در منابع AI»: چطور دستیارهای پرسشوپاسخ نام شما را بهعنوان منبع بیاورند.
تفاوت عملیاش در پرسشها و سنجههاست. برای سیاست، پرسش «این متن ارزش یکتا دارد؟» است و سنجهاش ماندگاری صفحات در بهروزرسانیهای هسته؛ برای AI Overviews، پرسش «خلاصهٔ گوگل کلیک ما را کم میکند؟» است و سنجهاش CTR در سرچکنسول؛ برای GEO، پرسش «آیا در پاسخها نقلقول میشویم؟» و سنجهاش رصد ماهانهٔ پرسشهای هدف. اگر متن فارسی از گیت سیاست رد نشود، دو بحث دیگر عملاً بیاثر میشوند؛ ترتیب اینها تصادفی نیست.
برای جدا نگهداشتن بحثها یک راه ساده به تیمهایمان میدهیم: در جلسهٔ برنامهریزی، سه ستون مجزا با سه پرسش بالا بچینید و هر اقدام را زیر یکی از ستونها بنویسید. به تجربهٔ ما بیشترین اتلاف وقت جایی رخ میدهد که تیم برای «مجاز بودن» راهحلِ «ماندن در لایهٔ پاسخ» را اجرا میکند — مثلاً ساختار را برای نقلقول بهینه میکند در حالی که مشکلش متن بیارزش است. تشخیص درست پرسش، نصف جواب است.
برای فارسی چه چیزهایی سنگینتر میشود؟
اگر موضع گوگل برای همهٔ زبانها یکی است، چرا بخشی مخصوص فارسی؟ چون اجرای استاندارد برای فارسی دشوارتر است. مدلهای زبانی روی دادهٔ فارسیِ کمتر و ناهمگونتری آموزش دیدهاند؛ نتیجه را در بازبینی متنها میبینیم: نیمفاصلههای جاافتاده، «می شود» بهجای «میشود»، اصطلاحهایی که در هیچ جلسهٔ کاری ایرانی شنیده نمیشود و جملههایی که ترجمهبودنشان از فاصله پیدا است.
لایهٔ دوم بومیبودن نمونههاست: پیشنویس خودکار مثالها را با واحد پول خارجی، آدرسهای غیرایرانی و تعطیلاتی میچیند که در تقویم ما نیست. خوانندهٔ فارسیزبان در همان مثال اول حس میکند این متن برای او نوشته نشده؛ و سیگنال رفتاری — بستن سریع صفحه — چیزی است که هیچ گفتوگویی دربارهٔ مجازبودن نمیپوشاند.
لایهٔ سوم منبع است: آمار معتبر فارسی کم است، پس مدل یا عدد میسازد یا منبع بینام میآورد. به تجربهٔ ما همین سه لایه — زبان، نمونه، منبع — مرز متن قابلانتشار و متن خام را در بازار ایران میسازد، چون هر سه مستقیم به اعتماد خواننده وصلاند.
ویرایش انسانی؛ چهار ایستگاه از پیشنویس تا انتشار
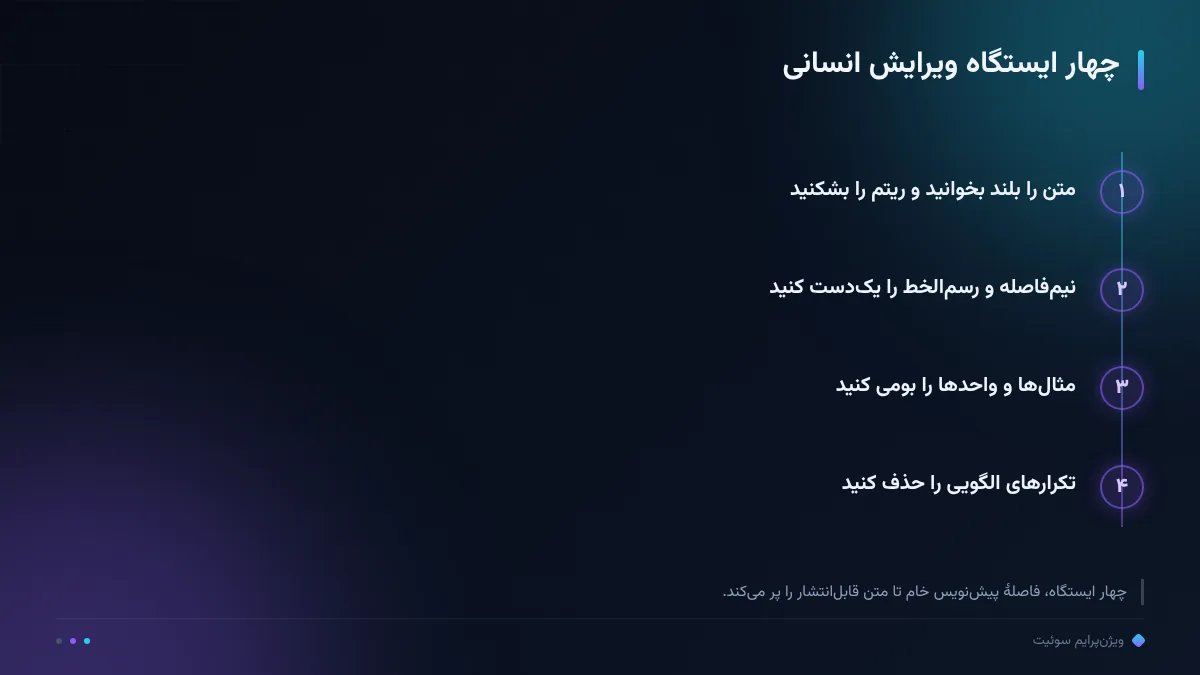
ویرایش انسانی یعنی بازنویسی لایهبهلایه، نه چک غلط املایی. ایستگاه نخست خواندن بلند است: متن را یکبار با صدای بلند بخوانید؛ جایی که نفس میبُرد یا جمله یکنواخت شده، همانجا بشکنید یا کوتاه کنید. ریزش خواننده بیشتر از بیمحتوایی، از ریتم بیروح میآید.
ایستگاه دوم رسمالخط است: نیمفاصله، همزه و شبهجملهها را یکدست کنید. این لایه ارزانترین تفکیک بین «ترجمهٔ ماشینی» و متن حرفهای است و نویسههای فارسی را از حالت خام خارج میکند. ایستگاه سوم بومیسازی است: مثالها، واحدها و اسامی را با بازار ایران عوض کنید؛ هر مثال بیگانه یک حلقهٔ ارتباط گمشده است.
ایستگاه چهارم حذف تکرارهای الگویی است: اگر «علاوه بر این» و «در مجموع» در هر پاراگراف تکرار شدهاند، حذفشان کنید؛ ریتم یکنواخت امضای متن خودکار است. بعد از این چهار ایستگاه، متن باید بتواند پرسش «اگر نویسندهٔ آشنا با بازار مینوشت، چه تفاوتی داشت؟» را با تفاوت کم جواب دهد؛ اگر تفاوت زیاد است، هنوز آمادهٔ انتشار نیست.
راستیآزمایی اعداد و ادعاها؛ قانون منبع و تاریخ
قانون داخلی ما ساده است: هر عدد یا ادعای بیرونی باید نام منبع و تاریخ گردآوری داشته باشد؛ اگر منبع معتبری پیدا نشد، یا حذف میشود یا در قاب تجربهٔ حرفهای مینشیند — «به تجربهٔ ما … چون». پیشنویسهای خودکار با اعداد پراعتمادبهنفس پر میشوند؛ گاهی منبعی میآورند که وجود ندارد یا عددی که در آن منبع نیست.
سه چک سریع کافی است: آدرس منبع باز میشود؟ عدد عیناً در همان صفحه هست؟ تاریخی که عدد به آن تعلق دارد کی است؟ عدد قدیمیِ بیتاریخ خطرش از نبودِ عدد هم بیشتر است، چون معتبر جلوه میکند و بعداً در جلسهٔ فروش به پشتوانهٔ شما استناد میشود.
در بازار ایران که آمار رسمی کم است، صادقانه «بازهٔ برآورد بازار» بنویسید و بگویید بر پایهٔ کدام تجربه برآورد کردهاید. این صداقت هم خواننده را نگه میدارد و هم تیم را از ادعای بیپشتوانه دور میکند؛ دوباره میگویم، معیار ما در گیت انتشار همین است، نه حدسهای پرشور پیشنویس.
ترجمهها و محتوای بینزبانه؛ کپی نکنید، بومی کنید
الگوی رایج را همه دیدهاید: مقالهٔ انگلیسی خوب پیدا میشود، ترجمهٔ ماشینی میشود، انتشار. از نظر سیاست، ترجمه ممنوع نیست؛ مسئله ارزش یکتاست. وقتی دهها سایت همان یک منبع انگلیسی را ترجمه کنند، نتایج فارسی ده نسخهٔ تقریباً یکسان میگیرد و هیچکدام دلیل ماندن ندارد.
کار عملی این است که به ترجمه لایهای اضافه کنید که فقط شما دارید: آمار داخلی، تجربهٔ پروژه، نمونهٔ مشتری ایرانی، قیمتها و شرایط بازار ایران. یک عدد اختصاصی یا یک تجربهٔ مکتوب، ترجمه را از «نسخهٔ دیگر» به «منبع» تبدیل میکند. به تجربهٔ ما مقالهٔ بومیشده با یک دادهٔ اختصاصی، از ده ترجمهٔ تمیز بهتر عمل میکند، چون چیزی برای نقلقولشدن و ارجاعگرفتن دارد که بقیه ندارند.
سه لایهٔ بومیسازی که در پروژههایمان همیشه جواب داده: جایگزینی مثال با یک سناریوی ایرانی واقعی (حتی یک جمله کافی است)، اضافهکردن یک دادهٔ مال خودتان مثل نتیجهٔ نظرسنجی مشتریان یا آمار داخلی، و تنظیم لحن با واژهنامهٔ برند. هیچکدام ساعتها وقت نمیگیرد، اما تفاوت را در همان پاراگراف اول حس میکند؛ خوانندهای که حس کند متن برای او نوشته شده، بیشتر میماند و بیشتر اعتماد میکند.
شش اشتباه رایج بازار ایران و راهحل هرکدام
| اشتباه | نشانهٔ ملموس | راهحل |
|---|---|---|
| انتشار پیشنویس خام | ریتم یکنواخت و نیمفاصلهٔ جاافتاده | چهار ایستگاه ویرایش پیش از انتشار |
| اعداد بیمنبع | آمار بدون نام منبع و تاریخ | قانون منبعوتاریخ یا حذف عدد |
| ترجمهٔ خام منابع خارجی | مثالها با واحد پول و آدرس خارجی | بومیسازی نمونهها + دادهٔ اختصاصی |
| انبوهسازی صفحات مشابه | ده صفحه برای ده کلمهٔ نزدیک با یک محتوا | صفحهٔ مستقل فقط برای پرسشهای واقعی |
| حذف نویسنده و اعتبار | صفحهٔ بدون نویسندهٔ مسئول | نام نویسنده، سابقهٔ مکتوب، صفحهٔ دربارهٔ ما |
| بازنویسی صرف رقبا | متن با همان اسکلت و همان مثالها | افزودن زاویه و دادهٔ خودتان |
این شش مورد، پرتکرارترین یافتههای ممیزیهای ما در سایتهای فارسی است.
میبینید که هیچکدام از این شش مورد به «ممنوعیت AI» ربط ندارد؛ همه به استاندارد کیفیت ربط دارد. دقیقاً همان مرزی که گفتهٔ عمومی گوگل ترسیم میکند: صفحه برای مردم ساخته شده یا برای پرکردن نتایج؟ همین یک پرسش را در گیت انتشار بپرسید و پاسخ را با شواهد بدهید، نه با احساس.
فرایند سهلایهٔ انتشار و جمعبندی
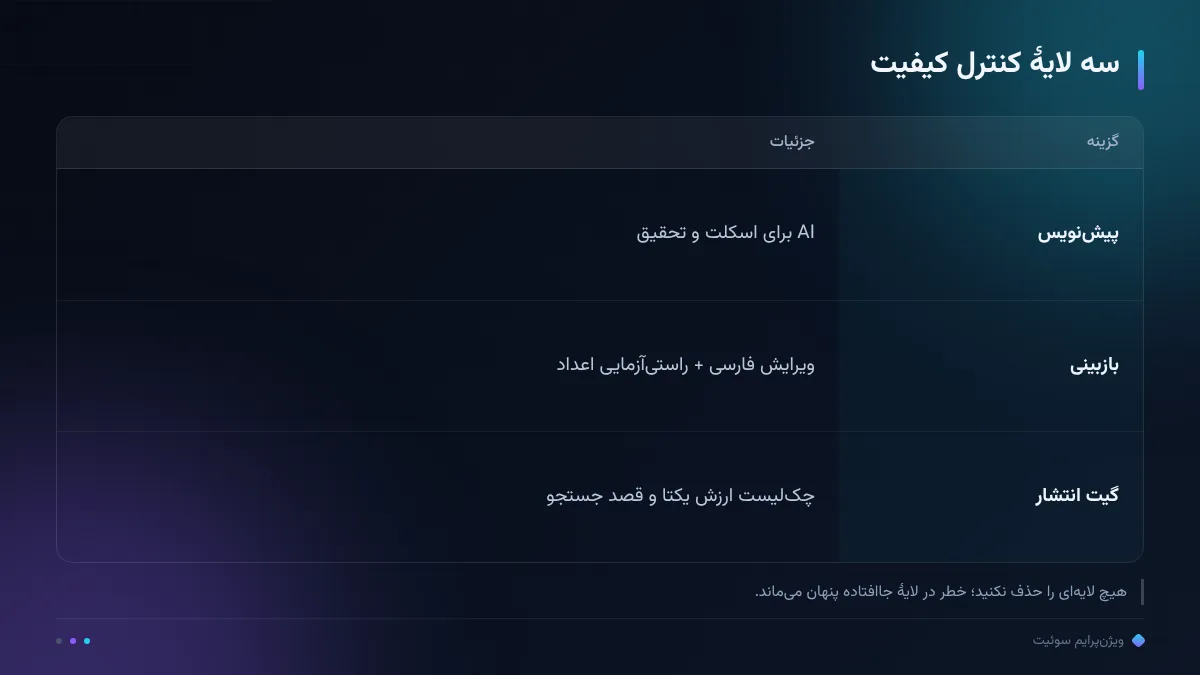
فرایندی که در سوئیت برای محتوای AI میچینیم سه لایه دارد: پیشنویس با هوش مصنوعی برای اسکلت، تحقیق و پیشنهاد ساختار؛ بازبینی انسانی برای زبان فارسی، بومیسازی و راستیآزمایی؛ و گیت انتشار که ارزش یکتا، تناسب با قصد جستجو و استنادها را سنجیده و بعد اجازهٔ انتشار میدهد. گیت کیفیت سیمرحلهای ما همین مسیر را مکانیزه کرده است: محتوای استاندارد، نه AI خام.
جمعبندی و سه کار همین ماه: نخست، متنهایی که با پیشنویس خودکار منتشر کردهاید را با چهار ایستگاه ویرایش بازخوانی کنید؛ دوم، قانون «منبع و تاریخ» را برای همهٔ اعداد فعال کنید؛ سوم، برای هر مقاله یک نویسندهٔ مسئول تعیین کنید. سیاست گوگل درباره محتوای AI ترس نمیخواهد، فرایند میخواهد — و فرایند، همان چیزی است که گفتهٔ عمومی گوگل از اول پاداش داده است: محتوای مفید برای مردم.
رصد ما، رشد شما.
سؤالات پرتکرار
آیا گوگل محتوای تولیدشده با هوش مصنوعی را جریمه میکند؟
طبق گفتهٔ عمومی گوگل، روش تولید ملاک نیست و کیفیت ملاک است؛ برخورد هم با اسپمِ سوءاستفادهٔ مقیاسی است، نه با هر متنِ عبورکرده از بازبینی انسانی (تاریخ گردآوری: آبان ۱۴۰۵).
سهم محتوای AI در سایت چقدر باشد امن است؟
هیچ عدد رسمیای وجود ندارد و ما معیار درصد را رد میکنیم. معیار درست این است که هر صفحه از گیت ویرایش انسانی، راستیآزمایی و ارزش یکتا رد شود، فارغ از سهم پیشنویس اولیه.
بازبینی انسانی برای متن فارسی چه چیزهایی را چک میکند؟
چهار ایستگاه: خواندن بلند برای ریتم، یکدستکردن نیمفاصله و رسمالخط، بومیسازی مثالها و واحدها، و حذف تکرارهای الگویی مثل «علاوه بر این» در همهٔ پاراگرافها.
چطور اعداد پیشنویس AI را راستیآزمایی کنم؟
سه چک: لینک منبع باز شود، عدد عیناً در همان منبع باشد و تاریخ عدد مشخص باشد؛ اگر منبع نیامد، عدد حذف میشود یا در قاب «به تجربهٔ ما» بازنویسی میکنیم.
کدام پلن سوئیت گیت کیفیت و بازبینی انسانی را دارد؟
همهٔ محتواهای پلنها از گیت کیفیت سیمرحلهای با بازبینی انسانی میگذرند؛ برای شروع کشف رایگان را فعال کنید و پلن بینش — ۲٫۹ میلیون تومان/ماه (ممیزی + ۱۰ محتوای سئو) حجم ماهانه را میپوشاند.