مطالعهٔ موردی: سهم گوگل در جستجوی ایران
- چرا برای سهم موتورهای جستجو در ایران عدد رسمی کمیاب است
- سهم گوگل در ایران: آنچه تجربهٔ میدانی میگوید
- زمینهٔ کیس: سایتی که رشدش وابسته به جستجو بود
- قدم اول: خواندن چهار سنجهٔ سرچکنسول
- قدم دوم: پاسخ به پرسشهای واقعی کاربر فارسی
- نتیجه: اعداد کیس ثبتشدهٔ سوئیت
- محدودیتها؛ آنچه این اعداد نمیگویند
- جمعبندی: برنامهٔ محتوا را بر پایهٔ واقعیت بازار بچینید
هر برنامهٔ سئو با یک سؤال شروع میشود: کاربر فارسیزبان کجا جستجو میکند و کدام موتور مسیر رشد ماست؟ جواب این سؤال را معمولاً با عددهای آماری میخواهند؛ ولی برای بازار ایران، عدد رسمی و مستقلی در دسترس نیست و هر عددی که بدون روششناسی ببینید باید محتاط خوانده شود. این مطالعهٔ موردی بهجای حدسزدن، از دو چیز شروع میکند: رفتار میدانی پروژههای واقعی و چهار سنجهٔ قابل راستیآزمایی در سرچکنسول.
ساختار روایت، مثل بقیهٔ کیسهای ثبتشدهٔ سوئیت است: زمینه، دادهها، قدمهای اجرا، نتیجهٔ عددی و محدودیتها. هدف، ثبت یک تجربهٔ تکرارشدنی است — نه وعدهٔ تکرار عدد نتیجه؛ چون هیچ کیسی، حتی کیسی که کاملاً مستند شده، تعمیمپذیری صددرصدی ندارد.
چرا برای سهم موتورهای جستجو در ایران عدد رسمی کمیاب است
سنجش «سهم موتورهای جستجو» در بازارهای بزرگ با پنلهای کاربری و دادههای مرورگر انجام میشود؛ این زیرساخت برای ایران بهصورت عمومی و منظم منتشر نمیشود و خود گوگل هم سهم کشوری منتشر نمیکند. نتیجه این است که عددهای پراکندهای که در شبکهها میچرخند، معمولاً منبع و روش مشخصی ندارند. ما در گزارشهایمان از هر عددی که روششناسیاش را توضیح نمیدهد میگذریم و بهجای آن، از دو دادهٔ مطمئنتر استفاده میکنیم: رفتار واقعی ورودی سایتهایی که مدیریت میکنیم و گزارش Performance سرچکنسول که مستقیم از گوگل میآید.
این کمبود داده مسئلهٔ کوچکی نیست؛ تصمیم بودجه به آن گره خورده است. اگر سهم گوگل را بدانید، میفهمید اولویت محتوا کجا باشد، کدام قالب گزارش به مدیر بدهید و کجا نباید پول خرج کنید. برای همین در این کیس، بهجای ادعای درصد، الگوی رفتاری را مستند میکنیم — الگویی که خودتان هم میتوانید روی دادهٔ سایت خودتان تکرار کنید.
سهم گوگل در ایران: آنچه تجربهٔ میدانی میگوید
به تجربهٔ ما و گزارشهای عمومی، جستجوی ارزشساز فارسی عملاً از گوگل میآید: کاربر موبایل با مرورگر پیشفرضش مستقیم به جستجوی گوگل میرود، و مسیرهای دیگر — موتورهای داخلی، جستجوی شبکههای اجتماعی — سهم پراکنده و وابسته به سن و سبک مخاطب دارند. در پروژههای سوئیت، ورودی ارگانیک را هر ماه تفکیک میکنیم؛ الگوی تکرارشونده این است که تقریباً تمام ترافیک ارگانیک معتبر از گوگل میآید و بقیهٔ مسیرها نوسانی و حاشیهایاند. این جمله را عمداً بدون درصد مینویسیم؛ چون برای بازار ایران عدد مستقل و قابل استناد نداریم و هر عددی که بدون منبع اعلام شود، اعتبار گزارش را پایین میآورد.
معنی این واقعیت برای برنامهٔ محتوا دو لایه دارد. لایهٔ اول: بودجهٔ محتوا و بهینهسازی را روی پرسشهایی بگذارید که در گوگل فارسی جستجو میشود؛ اینجا اصلیترین صحنهٔ رقابت است. لایهٔ دوم: وابستگی تککاناله ریسک است؛ کانالهای مکمل مثل خبرنامه، ورود مستقیم و حضور در پلتفرمهای اجتماعی را کنارش نگه دارید تا نوسان الگوریتم، کل آمد سایت را نلرزاند. به تجربهٔ ما سایتهایی که فقط روی یک کانال دویدهاند، در دورههای نوسان بیپشتوانهاند؛ چون هیچ مسیر پشتیبان برای برقراری تماس با مخاطب ندارند.
زمینهٔ کیس: سایتی که رشدش وابسته به جستجو بود
کیسی که اینجا روایت میکنیم، سایتی محتوایی-خدماتی بود که کل برنامهٔ رشدش بر جستجوی ارگانیک بنا شده بود؛ نه تبلیغ فعال، نه شبکهٔ اجتماعی پرقدرت. وضعیت شروع، آشناست: صفحات ایندکسشده ولی نمایش کم، پرسشهای پراکنده، و CTR پایین در نتایج. تیم محتوایی داشت ولی تقویم انتشار بر اساس حدس میچید، نه بر اساس پرسشهای واقعی کاربران. بازهٔ اندازهگیری، سهماههٔ منتهی به آبان ۱۴۰۵ تعریف شد و همهٔ اعداد از گزارش Performance سرچکنسول خوانده شد — نه از ابزارهای برآوردی.
یک تصمیم در ابتدای کیس، مسیر را عوض کرد: بهجای انتشار روزانهٔ مقالههای پراکنده، کار روی خوشههای موضوعیِ پرسشمحور را انتخاب کردیم. این انتخاب بعداً در اعداد خودش را نشان داد؛ ولی در لحظهٔ تصمیم، با مقاومت هم همراه بود — چون تعداد مقالههای ماهانه ظاهراً کمتر میشد. اگر داخل تیم شما هم «تعداد» معیار است، این بخش از روایت را برایش نگه دارید.
بازهٔ اندازهگیری را هم از همان روز مکتوب کردیم: شروع و پایان مشخص، منبع اعداد مشخص، و قاعدهٔ «هیچ قضاوتی در هفتهٔ تغییرات بزرگ». این قاعده ساده بعداً دو بار کارآمدیاش را نشان داد؛ یکبار وقتی نوسان کوتاهمدت وسوسهٔ تصمیم عجولانه میساخت و یکبار وقتی رشد هفتهای خاص، مسئولین را تشویق به اعلام نتیجهٔ زودهنگام میکرد. کیسی که بازهٔ اندازهگیری مکتوب ندارد، در جدلهای داخلی بیدفاع است؛ این تجربهٔ عملی ما در همهٔ پروژههاست.
قدم اول: خواندن چهار سنجهٔ سرچکنسول
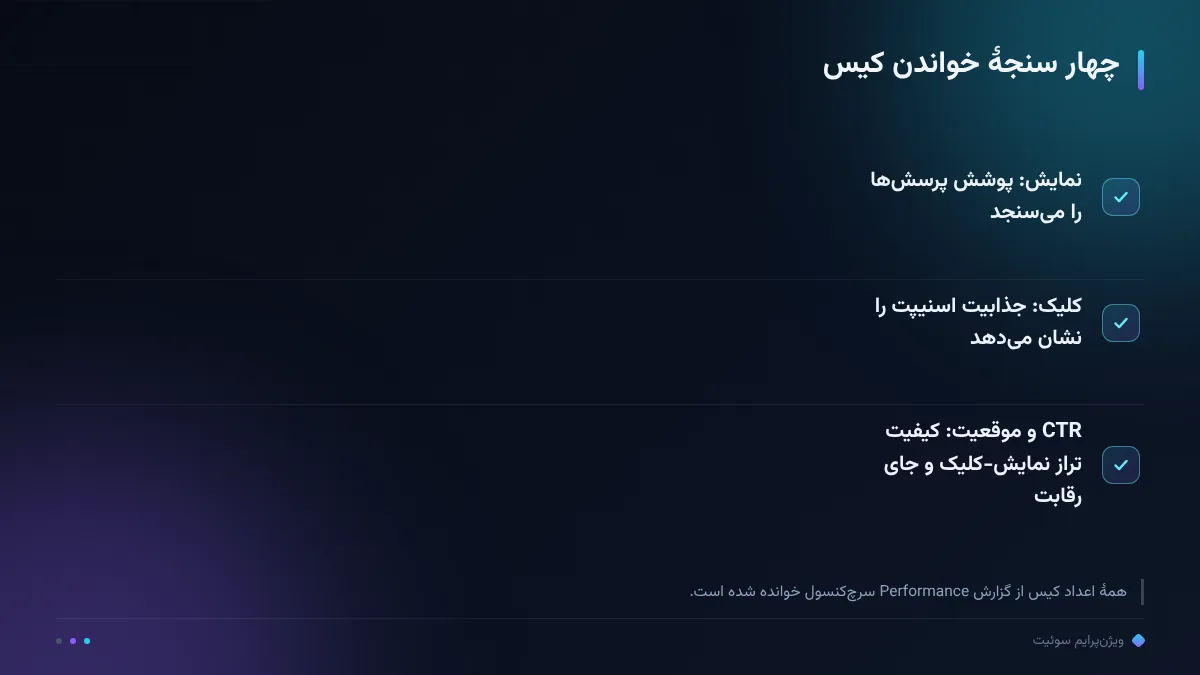
گزارش Performance سرچکنسول چهار سنجهٔ استاندارد دارد: نمایش، کلیک، CTR و میانگین موقعیت (تاریخ گردآوری: آبان ۱۴۰۵). این چهار عدد را ما ستونهای تصمیم میدانیم: نمایش میگوید پوشش پرسشها چقدر است، کلیک میگوید از آن پوشش چه چیزی جذب شده، CTR کیفیت تراز نمایش-کلیک را نشان میدهد و میانگین موقعیت جای شما در رقابت را. جدول زیر نقش هر سنجه را در همین کیس خلاصه میکند:
| سنجه | چه چیزی را نشان میدهد | در این کیس چطور خواندیمش |
|---|---|---|
| نمایش | پوشش پرسشهای هدف در نتایج | رشد آرام نمایش یعنی خوشهها دارند کشف میشوند |
| کلیک | جذابیت اسنیپت در برابر رقبا | کلیک قبل از رتبه جلو افتاد؛ نشانهٔ اسنیپت درست |
| CTR | نسبت کلیک به نمایش | معیار قضاوت کیفیت عنوان و دیسکریپشن |
| میانگین موقعیت | جای کلی در رقابت | برای تشخیص صفحات نزدیکِ صفحهٔ اول استفاده شد |
چهار سنجهٔ استاندارد گزارش Performance سرچکنسول؛ مبنای خواندن کیس.
نکتهٔ اجرایی: این چهار عدد را صفحهبهصفحه ببینید، نه فقط در جمع سایت. در جمع، میانگینها واقعیت را میپوشانند؛ در تفکیک، صفحات «پرنمایشِ کمکلیک» و «نزدیکِ صفحهٔ اول» — دو گروه با بالاترین بازگشت سرمایه — خودشان را نشان میدهند.
قدم دوم: پاسخ به پرسشهای واقعی کاربر فارسی
فهرست پرسشها از سه جا درآمد: پیشنهادهای جستجو، گزارش پرسشهای خود سرچکنسول و سؤالهای واقعی کاربران در پشتیبانی. برای هر پرسش یک صفحهٔ هدف تعریف شد و قالب محتوا ساده بود: جواب مستقیم در همان پاراگراف اول، بعد عمق و مثال و جزئیات اجرایی. لحن فارسی طبیعی نگه داشته شد — همان عبارتهایی که کاربر واقعاً مینویسد، با املای متنوعش — نه معادلهای کتابی. این جزئیات در جستجوی فارسی اهمیت مضاعف دارد؛ چون تنوع املایی و نیمفاصله، فاصلهٔ زبان کاربر با زبان سایت را میسازد.
خوشهبندی هم کار را منظم کرد: پرسشهای همخانواده زیر یک صفحهٔ اصلی گرد آمدند و با لینک داخلی به هم وصل شدند. به تجربهٔ ما همین لینکسازی درونی، اعتبار صفحات فرعی را به صفحهٔ اصلی خوشه میبرد و در نتیجه صفحاتِ نزدیکِ مرز صفحهٔ اول، پلهٔ آخر را راحتتر برمیدارند. انتشار هم تداوم داشت: برنامهٔ ماهانهٔ ثابت، بهجای موجهای بینظم؛ چون انباشت سیگنال کیفیت تدریجی است.
یک جزء کوچک ولی مؤثر هم اسنیپت بود: عنوان و دیسکریپشن هر صفحهٔ هدف، با وعدهٔ دقیق همان صفحه نوشته شد و برای صفحات پرنمایش، نسخهٔ جایگزین آماده ماند. دلیلش ساده است: وقتی نمایش رشد میکند، تنها چیزی که بین نمایش و کلیک میماند، جذابیت همین دو خط است؛ و به تجربهٔ ما بهبود اسنیپت، سریعترین اصلاح قابلاجرای کل زنجیره است — بدون هیچ تغییری در ساختار سایت.
نتیجه: اعداد کیس ثبتشدهٔ سوئیت
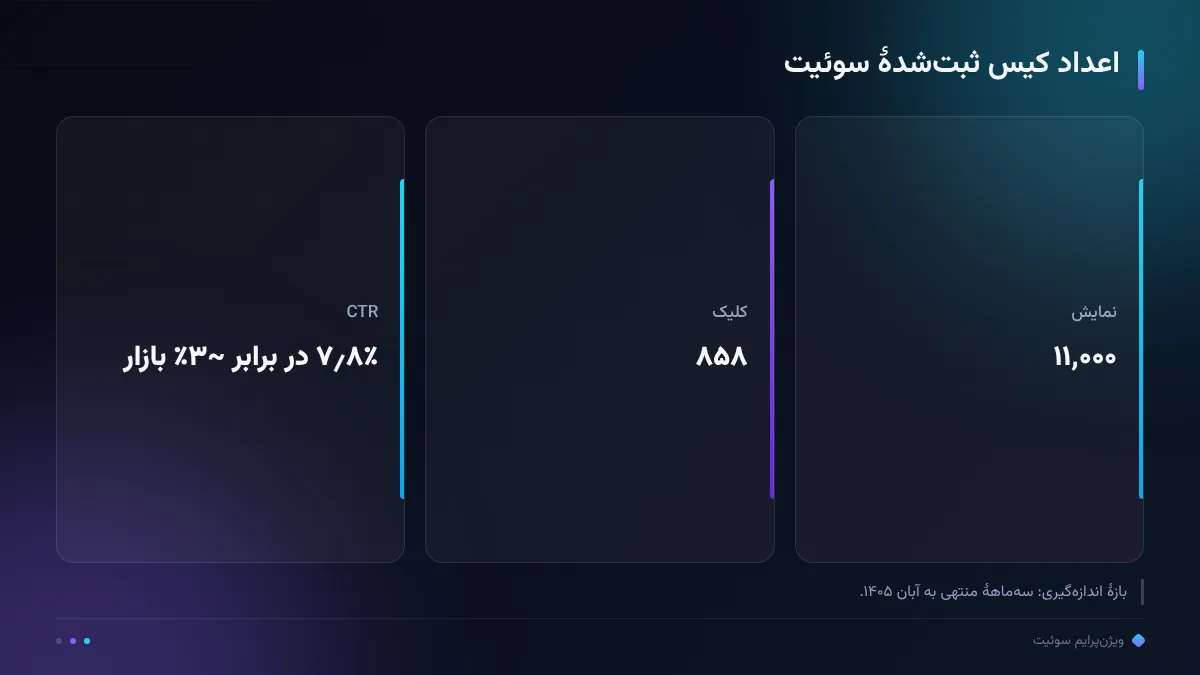
نتیجهٔ بازهٔ اندازهگیری سهماههٔ منتهی به آبان ۱۴۰۵، با برچسب «کیس ثبتشدهٔ سوئیت»: ۱۱٬۰۰۰ نمایش و ۸۵۸ کلیک با CTR ۷٫۸ درصد — در برابر حدود ۳ درصد میانگین بازار در همان بازه. دو نکته مهم است: اول، کلیک زودتر از رتبه جلو افتاد؛ یعنی بخشی از بهبود از اسنیپت بهتر آمد، نه فقط از جابهجایی رتبه. دوم، رشد نمایش یعنی گوگل صفحات خوشه را برای پرسشهای تازه هم در حال کشف بود؛ نشانهای که ساختار موضوعی درست کار کرده است.
یک کیس دوم هم برای مقایسه ثبت شده: در کیس liuna، ۱۰ محتوای تولیدشده در ۳ ماه به ۲۸۶ صفحهٔ اول رسید — با همین برچسب «کیس ثبتشدهٔ سوئیت» و با یادداشت صادقانهای که خودش اضافه میکند: فروشگاه بود، نه آژانس. جمع این دو کیس یک پیام میدهد: ساختار پرسشمحور و تداوم انتشار، در دو نوع کسبوکار متفاوت قابل اجرا بوده است؛ ولی تعمیم عدد نتیجه به هر سایتی، ادعایی است که میکنیم و نمیکنیم.
محدودیتها؛ آنچه این اعداد نمیگویند
صادقانه بگوییم این اعداد چه چیزی را نمیگویند. اول، یک کیس سهماهه تعمیمپذیر نیست؛ نوسان فصلی و ترکیب پرسشها روی CTR اثر میگذارد و ترکیب پرسشهای هر سایتی متفاوت است. دوم، «میانگین بازار حدود ۳ درصد» یک مرجع تجربی برای مقایسه است، نه عدد آماری مستقل. سوم، این نتیجه به اجرای منظم گره خورده بود؛ همان کار با تیم بیثبات یا بدون گیت کیفیت، نتیجهٔ مشابهی نمیسازد. ما هیچ وعدهای از رتبه یا ترافیک نمیدهیم؛ آنچه تکرارشدنی است، ساختار کار است — نه عدد نتیجه.
محدودیت دادهٔ بازار را هم تکرار کنیم: چون سهم موتورهای جستجو در ایران عدد رسمی منتشرشده ندارد، کل بحث سهم در این مقاله صبورانه «کیفی و مبتنی بر تجربهٔ میدانی» نگه داشته شده است. اگر بعد از این تاریخ منبع مستقلی منتشر شود، اعداد این کیس را کنارش گذاشتیم و دوباره میخوانیم؛ این روتین راستآزمایی بخشی از روش ماست.
جمعبندی: برنامهٔ محتوا را بر پایهٔ واقعیت بازار بچینید
جمع این مطالعهٔ موردی سه تصمیم عملی است: اول، بودجهٔ محتوا را روی جستجوی گوگل فارسی متمرکز کنید — چون تجربهٔ میدانی و گزارشهای عمومی، چیرگی این کانال را تأیید میکند — ولی یک کانال مکمل هم نگه دارید. دوم، قضاوت را به چهار سنجهٔ سرچکنسول بسپارید، نه به حس؛ همان چهار عددی که در این کیس مسیر را روشن کرد. سوم، تداوم را بخرید: خوشهٔ پرسشمحور + انتشار منظم + بازخوانی ماهانهٔ اعداد. اگر خواستید اعداد کیسهای بیشتر را ببینید، کیسهای ثبتشدهٔ سوئیت و هاب آمار و ترندهای جستجو نقطهٔ ادامهٔ مسیرند؛ و برای شروع با دادهٔ خودتان، ممیزی رایگان دامنه تصویر وضعیت فعلی را میدهد.
اگر بخواهید همین مسیر را روی سایت خودتان از فردا شروع کنید، ترتیب ما این است: اول گزارش Performance را به تفکیک صفحه بگیرید و دو گروه «پرنمایشِ کمکلیک» و «نزدیکِ صفحهٔ اول» را جدا کنید؛ بعد برای ده پرسشِ پرتکرارِ واقعی مخاطب، صفحات هدف با جواب مستقیم بنویسید؛ و در پایان ماه، همان چهار سنجه را کنار عددهای شروع بگذارید. این حلقهٔ کوچک، همان چیزی است که در کیس بالا کار کرد؛ فاصلهٔ «دانستن سهم گوگل» تا «سود بردن از آن» در همین سه قدم بسته میشود.
رصد ما، رشد شما.
سؤالات پرتکرار
سهم گوگل در ایران دقیقاً چند درصد است؟
عدد رسمی و مستقلی منتشر نشده؛ ما عمداً درصد نمیگوییم. به تجربهٔ میدانی و گزارشهای عمومی، سهمش در جستجوی ارزشساز فارسی چیره است و هر عددی بدون روششناسی را محتاط بگیرید.
CTR ۷٫۸ درصد یعنی چه؟
یعنی از هر ۱۰۰ نمایش در نتایج، ۷٫۸ کلیک گرفته شده؛ در بازهٔ سهماههٔ منتهی به آبان ۱۴۰۵ و در برابر حدود ۳ درصد میانگین بازار. CTR به ترکیب پرسشها و اسنیپت وابسته است.
اعداد این کیس از چه منبعی خوانده شده؟
از گزارش Performance سرچکنسول — نمایش، کلیک، CTR و میانگین موقعیت — نه از ابزارهای برآوردی. بازهٔ اندازهگیری سهماههٔ منتهی به آبان ۱۴۰۵ بوده است.
آیا برای موتورهای دیگر هم باید بهینه کنیم؟
اولویت با گوگل است، چون جستجوی معتبر فارسی از آنجا میآید. مسیرهای دیگر را اگر مخاطب خاصی دارید بسنجید؛ تصمیم را روی دادهٔ ورودی سایت خودتان بگیرید، نه روی حدس.
آیا نتیجهٔ این کیس برای سایت من تکرار میشود؟
ساختار کار تکرارشدنی است، نه عدد نتیجه: خوشهٔ پرسشمحور، جواب مستقیم، تداوم انتشار و پایش چهار سنجه. هیچکس بهدرستی نمیتواند عدد نتیجه را از قبل قطعی وعده بدهد.