آموزش گامبهگام خواندن لاگ سرور برای سئو
ابزارهای سئو از بیرون به سایت نگاه میکنند و تخمین میزنند؛ لاگ سرور از داخل ثبت میکند. هر درخواستی که به سرور میرسد — خزنده، کاربر، اسکنر — در لاگ سطری دارد: چه زمانی، چه آدرسی، از چه مبدأیی، با چه وضعیتی و چه حجمی. همین پروندهٔ خام است که همهٔ حدسهای ابزار با آن راستیآزمایی میشود و هر جا گزارشها گویا نیستند، سرانجامِ ماجرا را نشان میدهد.
به تجربهٔ ما لاگخوانی سئویی کارِ هر روز نیست و نباید باشد؛ ابزار مفیدِ موقعیتهای خاص است: بعد از مهاجرت، وقتی ایندکس بدون توضیح افت کرده، وقتی فروشگاه پارامترهای زیادی دارد یا وقتی ظن هدررفت خزش هست. در هاب سنجش و سرچکنسول دادههای رسمی را رصد میکنیم؛ لاگ همان لایهٔ زیرین است که وقتی دادههای رسمی توضیح نمیدهند، از سمت سرور جواب میدهد. این راهنما، همان مسیر عملی خواندن آن لایه است.
لاگ سرور و سئو؛ چرا دادهٔ واقعی از حدس ابزار بهتر است؟
تفاوت از نگاهکردن شروع میشود. ابزارهای خزش به دامنه سر میزنند و از الگوها نتیجه میگیرند؛ خزندهٔ موتور جستجو برنامهٔ خودش را دارد: اولویتبندی آدرسها، ریتم بازگشت و واکنش به وضعیتها. لاگ سرور و سئو از همینجا به هم میرسند: لاگ نشان میدهد خزنده واقعاً چه آدرسهایی را چند بار خواست، چه پاسخی گرفت و کجا وقتش هدر رفت — چیزی که هیچ ابزار بیرونی نمیتواند ثبت کند، چون آن سمتِ دیوار است و خزندهٔ واقعی آنجا رفتار میکند، نه ابزار شما.
سه موقعیت، لاگ را از «دانش خوب» به «نیاز فوری» ارتقا میدهد. اول، افت ایندکس یا محو شدن صفحاتی که در گزارشهای رسمی توضیح روشنی ندارند. دوم، فروشگاههای بزرگ با فیلتر و پارامترهای زیاد، که ظن هدررفت خزش دارند و بهسختی با گزارشهای سطح بالا قابلتفسیرند. سوم، پس از مهاجرت یا تغییر زیرساخت، که رفتار واقعی خزنده سریعترین بازخورد سلامت ساختار تازه است. در هر سه، لاگ جواب را از خود سرور میگیرد، نه از تخمین؛ و دقیقاً برای همین، تحلیلش را بهجای حدس میگذارد.
کدام لاگ را از کجا بگیرید؟
منبع اصلی، access log وبسرور است — در nginx و apache با فرمتهای متداولِ سطربهسطر. اگر هاست شما پنل مدیریت دارد، معمولاً لاگ خام یا نسخهٔ پردازششدهٔ آن قابلدانلود است؛ در هاست اشتراکی ممکن است دسترسی محدود یا پاکسازی دورهای داشته باشید؛ در این حالت از پشتیبانی هاست بازهٔ کوتاه را بخواهید یا لاگ لایهٔ CDN را درخواست کنید. دو منبع جایگزین هم هست: لاگ لایهٔ کش و لاگ فایروال؛ برای سئو، access log وبسرور مرجع است چون درخواستهای رسیده به اپلیکیشن را کامل ثبت میکند و همان چیزی را دارد که خزنده واقعاً دیده است.
یک نکتهٔ مسئولیتپذیر: لاگ شامل IP و نشانیهای بازدید کاربران واقعی هم هست. برای تحلیل سئو فقط به سطرهای رباتها نیاز دارید؛ پیش از هر اشتراکگذاری، داده را ناشناسسازی کنید یا فقط ستونهای فنی را نگه دارید و بازهٔ نگهداری را کوتاه تعریف کنید. بازهٔ تحلیل هم مشخص است: از دو هفته حداقل و ۲۸ روز ترجیح؛ تا ریتم هفتگی خزنده — موج و فروکش — در نمونه دیده شود. با بازهٔ کوتاهتر، اعدادی که میبینید تصادف روز است، نه الگوی سایت.
آموزش گامبهگام تحلیل لاگ در پنج قدم
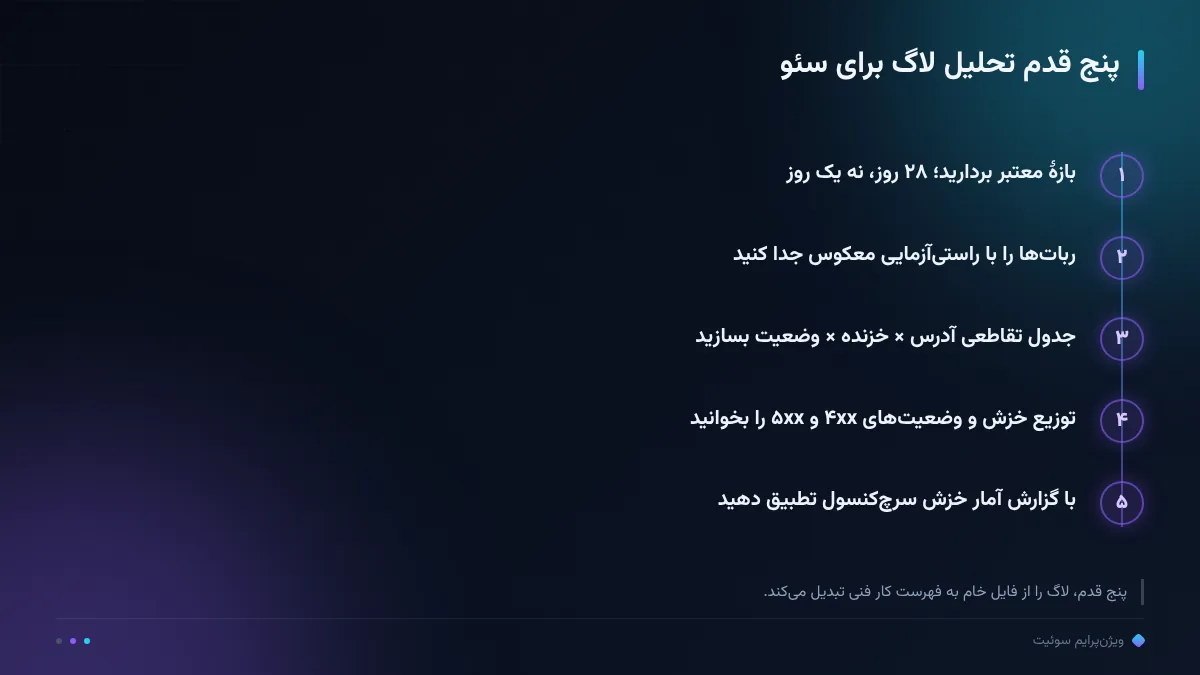
قدم اول، برداشتن بازهٔ معتبر است: فایل لاگ ۲۸ روزه یا دو بازهٔ دوهفتهای، نه یک روز؛ تکروز ریتم خزنده را نمیخواند. قدم دوم، جدا کردن صادقانهٔ رباتهاست: فیلتر بر اساس user-agent نقطهٔ شروع است اما کافی نیست، چون جعل user-agent رایج است؛ در صورت امکان، IP مبدأ را به دامنه معکوس برگردانید و فقط سطرهایی را نگه دارید که دامنهٔ معتبر خزنده برمیگردانند. همینجا اعتراف صادقانه باشد: تشخیص قطعی «خزندهٔ واقعی» همیشه ساده نیست و بخشی از سطرها ابهامشان میماند؛ قاعدهٔ ما تحلیل دو نسخه است — نسخهٔ سخاوتمندانه و نسخهٔ سختگیرانه — تا نتیجه به الگوی مشترک هر دو وابسته باشد، نه به یک فیلتر تکی.
قدم سوم، ساختن جدول تقاطعی است: آدرس در سطر، نوع خزنده و کد وضعیت در ستون؛ شمارش درخواستها، روزهای خزش و آخرین زمان بازدید هر آدرس. قدم چهارم، خواندن سیگنالهاست: توزیع خزش بین بخشهای سایت، سهم آدرسهای پرتکرار، صفحات عمیقی که هرگز خزیده نشدند و جمع وضعیتهای ۴xx و ۵xx. قدم پنجم، تطبیق با سرچکنسول است: گزارش آمار خزش همان روایت را از طرف گوگل میدهد؛ جایی که لاگ و این گزارش همنظرند موضوع قطعیتر است و جایی که اختلاف دارند، یعنی لایهای — کش، CDN یا فایروال — میانشان حرف میزند و همان لایه را بررسی کنید.
سیگنالهای بودجهٔ خزش؛ کجا خزنده هدر میرود؟
بودجهٔ خزش عدد واحدی نیست که سایتها داشته باشند؛ سیگنالهای کیفیاش را در لاگ میخوانید. چهار الگوی رایج هدررفت: آدرسهای پارامتردار و فیلترهای فروشگاهی که سهم بزرگی از خزش را میگیرند و ارزش ایندکس تازهای ندارند؛ صفحات تکراری با نشانیهای چندگانه که خزنده را بین نسخهها میچرخانند — تشخیص و تصمیمشان در آموزش صفحات تکراری و کانونی آمده است؛ ریدایرکتهای زنجیرهای که هر بار یک پرش اضافه در لاگ ثبت میکنند؛ و آدرسهای مردهای که هنوز درخواست میگیرند و ۴۰۴ میدهند. چهار الگو، چهار فهرست کار جدا میسازند.
دو قاعدهٔ کنترل هم دارد. اول، robots.txt را درست بنویسید: طبق مستندات Google Search Central، دستور Disallow مانع خزش است نه ایندکس، و گوگل دستور Crawl-delay را نادیده میگیرد (تاریخ گردآوری: آبان ۱۴۰۵)؛ پس مسدودسازی حسابشدهٔ مسیر پارامترها فقط با فهمِ ایندکسشدنی که همین حالا از خزش خارج شدهاند درست است. دوم، سرعت پاسخ را جدا ببینید: وقتی سهم زیادی از درخواستها ۵xx یا کند است، خزنده ریتمش را کم میکند؛ ریشهٔ آن طرف سرور است و در آموزش TTFB و سرعت سرور باز شده است. لاگ علت نمیسازد؛ مقصر را از میان گزینهها حذف میکند.
پنج خطای رایج در خواندن لاگ
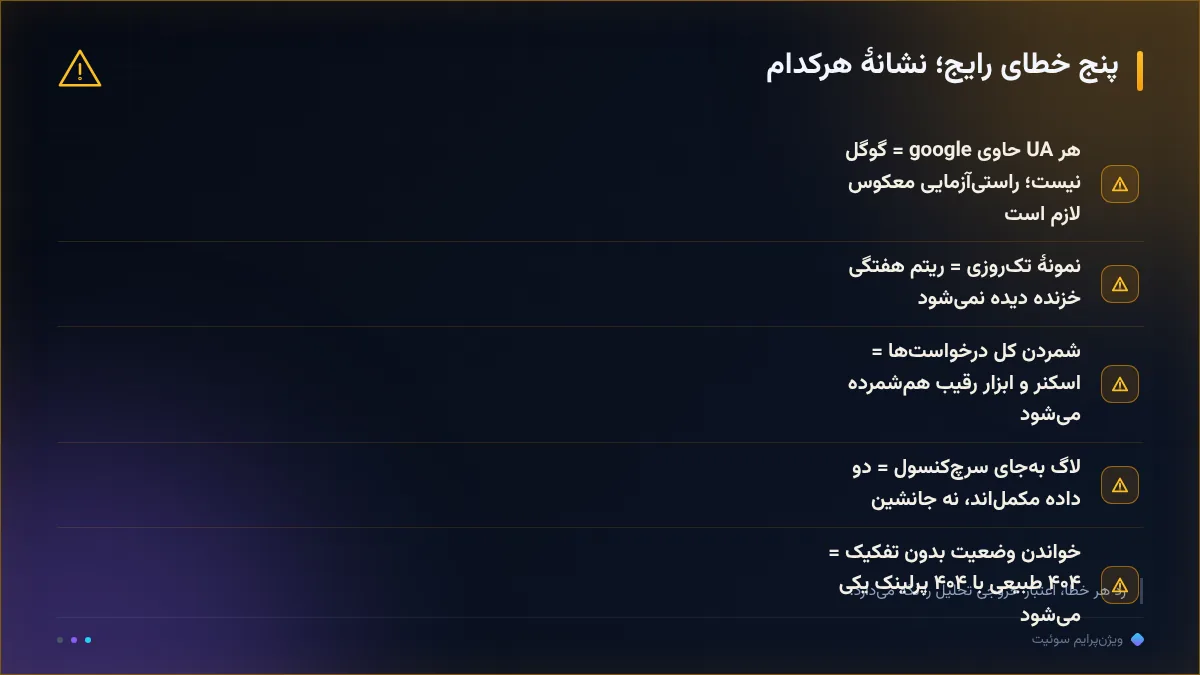
خطای اول، همهشمردن است: هر user-agentای که در اسمش google دارد، گوگل نمیشود؛ جعل رایج است و بدون راستیآزمایی معکوس، شمارش شما متورم میشود. خطای دوم، نمونهٔ تکروزی است؛ ریتم خزنده هفتگی است و یک روز، هم میتواند اوج باشد هم فروکش. خطای سوم، شمردن همهٔ درخواستها بهعنوان خزش موتور جستجو است؛ اسکنرها و ابزارهای رقیب هم در لاگاند و سهمشان جدا میشود، وگرنه تفسیر، از پایین غلط است.
خطای چهارم، جانشینسازی لاگ بهجای سرچکنسول است؛ این دو مکملاند: یکی سمت سرور و کامل برای همهٔ خزندهها، دیگری روایت رسمی گوگل با فیلترهای آماده. خطای پنجم، خواندن وضعیتها بدون تفکیک است؛ ۴۰۴ برای آدرسی که واقعاً حذف شده طبیعی است، اما ۴۰۴ برای آدرسهای پرلینک هشدار جدی است و تصمیمشان متفاوت است. اگر رد این پنج خطا را بروید، خروجی تحلیل از «اعداد جالب» به «تصمیم قابلدفاع» تغییر میکند و فهرست کارتان دیگر بر پایهٔ یک فیلتر بدبخت بنا نمیشود:
جمعبندی؛ روتین فصلی لاگخوانی
لاگخوانی سئویی کار هر روز نیست؛ روتین فصلی کوتاه است: یک بازهٔ ۲۸ روزه بردارید، دو نسخهٔ تحلیل بسازید، چهار الگوی هدررفت را چک کنید و نتیجه را با گزارش آمار خزش سرچکنسول تطبیق دهید. خروجی، فهرست کوتاهی است: پارامترهایی که باید کنترل شوند، ریدایرکتهایی که باید بریده شوند، صفحاتی که مسیر خزششان بسته شده و وضعیتهای ۵xx که ریشهٔ سروری دارند. سه موقعیت را هم بیرون از تقویم نگه دارید: بعد از مهاجرت، بعد از افت ایندکس بیتوضیح و هنگام رشد سریع فروشگاه؛ در هر سه، لاگ زودتر از بقیهٔ ابزارها حرف میزند.
اگر در این بازبینی، لایهای سرور-محور یا ساختاری نیاز به اصلاح پیدا شد، ممیزی رایگان دامنه نقطهٔ شروع خوبی است؛ و برای دیدن اینکه لایهٔ تولید و انتشار محتوا چطور روی همین زیرساخت مینشیند، قابلیتهای پلتفرم را ببینید. جمعبندی روش ما همان سه سطر است: لاگ برای پروندهها، سرچکنسول برای روتین، و هر تصمیم با الگوی مشترکِ هر دو:
رصد ما، رشد شما.
سؤالات پرتکرار
لاگ سرور به زبان ساده چیست؟
دفتر ثبت همهٔ درخواستهایی است که به سرور رسیده: زمان، آدرس، مبدأ و وضعیت پاسخ؛ برای سئو، سطرهای خزندهها مهماند.
بدون دسترسی به لاگ هم میشود سئوی فنی کرد؟
بله؛ سرچکنسول بیشترِ نیاز روزمره را پوشش میدهد. لاگ برای پروندههای خاص است: افت ایندکس بیتوضیح، مهاجرت و ظن هدررفت خزش.
لاگها را چه مدت نگه داریم؟
برای تحلیل سئو بازهٔ ۲۸ روزه کافی است؛ نگهداری طولانیتر از نیاز، دادهٔ کاربران واقعی را هم نگه میدارد و ریسک حریم خصوصی میسازد.
لاگ چیزی اضافهتر از سرچکنسول میگوید؟
بله؛ لاگ رفتار همهٔ خزندهها و همهٔ کدهای وضعیت را سمت سرور ثبت میکند، در حالی که سرچکنسول روایت رسمی گوگل با گزارش آماده است؛ تطبیق این دو قویترین ابزار تشخیص است.