چرا تراکم کلمه کلیدی افسانه است؟ واقعیت و راه درست
سالهاست در آموزشهای سئو عددی مثل «دو تا سه درصد» بهعنوان حد نصاب تکرار چرخیده است؛ عددی که هیچ منبع رسمی پشتش نیست و باورش هنوز باعث میشود نویسنده متن روان را برای رسیدن به درصد خراب کند. این مقاله کار سادهای دارد: بگوید از آن افسانه چه چیزی واقعی است، چه چیزی باید رها شود و راه درست چیدمان کلمه چیست.
اما پیش از شروع، یک مقالهٔ خواهر در همین خوشه را معرفی کنیم که موضوع نزدیکی دارد: چرا چگالی کلمه کلیدی بهتنهایی نتیجه نمیدهد؟ علتهای پنهان — فرمول چگالی، مکانیسم نتیجهندادنِ تکرار و نشانههای اشباع را آنجا بخوانید. تفکیک این دو: آن مقاله میگوید «چرا تکرار بهتنهایی کار نمیکند»؛ این مقاله برچسب «افسانه و واقعیت» میزند — از دههٔ ۲۰۱۰ چه چیزی مانده و چه چیزی تمام شده — و قانون چیدمان را میدهد. تعداد کلمه کلیدی در صفحه؛ چرا بیشتر بودن نتیجه نمیدهد؟ هم از زاویهٔ «چند بار کافی است» همین مرز را کاویده است.
تراکم کلمه کلیدی و افسانهٔ حد نصاب؛ از کجا آمد؟
حد نصاب درصدی از دورهای آمده که سئو یعنی شمارش بود: ابزارها درصد تکرار را گزارش میکردند و آموزشها عددی «ایمن» پیشنهاد میکردند. مشکل این است که هیچکدام از این اعداد منبع رسمی ندارند؛ گوگل هرگز آستانهٔ درصدی برای تکرار اعلام نکرده است (تاریخ گردآوری: آبان ۱۴۰۵) و صفحاتی با درصد کاملاً متفاوت کنار هم رتبه میگیرند.
چرا باور ماند؟ چون ساده است: یک عدد، یک ابزار، یک تصمیم. به تجربهٔ ما تیمها بهخاطر همین سادگی به عدد پناه میبرند، چون پوشش موضوع و تناسب با قصد جستجو را نمیشود با یک درصد جمعبندی کرد. افسانه هم به همان اندازه که بیضرر به نظر میرسد گران است: متنهایی که برای درصد کلمه اضافه شدهاند روانیشان از دست رفته و خواننده را همان پاراگراف سوم میبازند.
نشانهٔ دیگر ضعف افسانه، ناسازگاری خود اعداد است: دو ابزار محبوب برای همان صفحه دو درصد متفاوت گزارش میکنند، چون روش شمارششان فرق دارد — یکی کلمهٔ ساده میشمارد، یکی ریشهها را با هم جمع میزند. اگر معیار واقعی همان عدد بود، این اختلاف نباید وجود میداشت؛ به تجربهٔ ما همین بیثباتی، علامت روشنی است که متغیر اشتباهی را اندازه میگیریم.
چه چیزی از آن افسانه واقعی مانده است؟
واقعیت نخست: جایگاههای اصلی هنوز مهماند. کلمه کلیدی در عنوان سئو، در صد کلمهٔ نخست و در یکی دو هدینگ به خواننده و موتور جستجو میگوید صفحه دربارهٔ چیست؛ اینها چیدماناند، نه شمارش. حذف عبارت از این جایگاهها هم متن را مبهم میکند و هم مسیر فهم موضوع را برای ربات تار میگذارد.
واقعیت دوم: تکرار غیرطبیعی هنوز علامت خطر است. فهرستکردن کلمهها پشت سر هم، پاراگرافی که فقط برای تکرار نوشته شده و متن پنهان از چشم کاربر، همان keyword stuffing قدیمی است؛ راهنمای عمومی گوگل تکرار غیرطبیعی برای دستکاری رتبه را اسپم میداند (تاریخ گردآوری: آبان ۱۴۰۵). پس آنچه در دههٔ ۲۰۱۰ واقعی بود، همان هنوز واقعی است — فقط اسمش حد نصاب نیست، اسمش طبیعیبودن است.
واقعیت سوم: موضوع باید کامل پوشیده شود. صفحهای که پرسش کاربر را تماموکمال جواب میدهد، بدون هیچ حسابوکتاب درصدی، تکرار طبیعی عبارت را هم بههمراه میآورد؛ چون موضوع، واژههای خودش را با خودش میآورد.
چه چیزی افسانه است و باید رهایش کرد؟
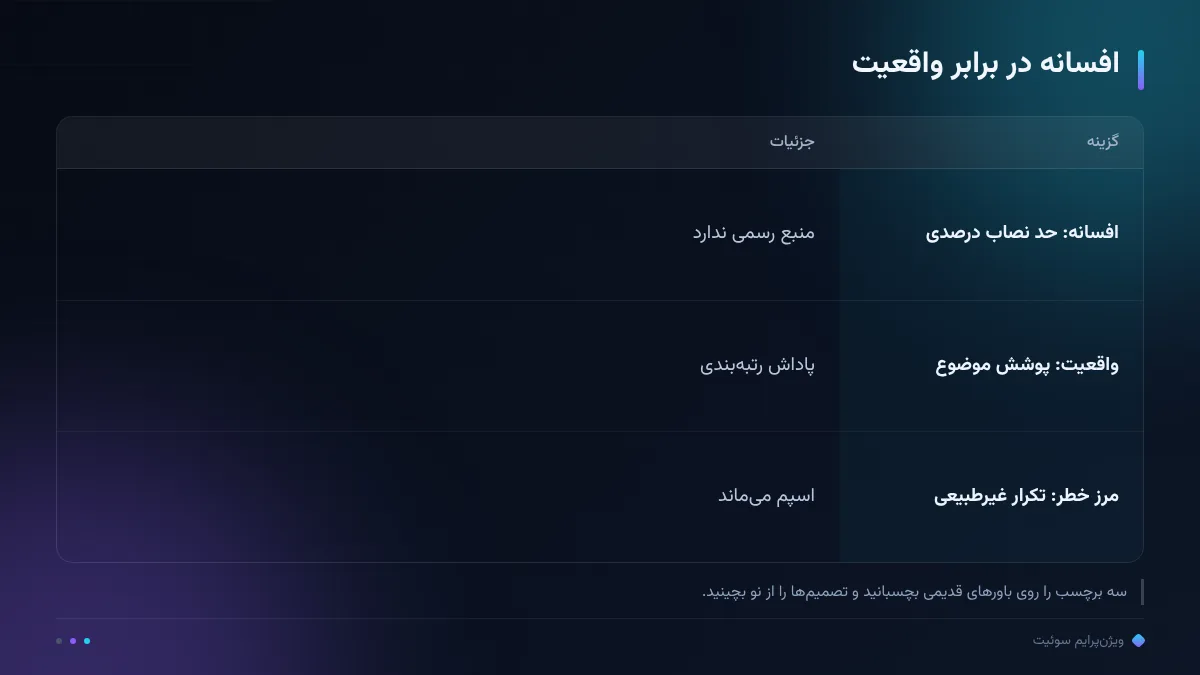
سه باور را رها کنید. باور اول: «درصد دقیق وجود دارد». نه؛ هیچ سند رسمی حدی اعلام نکرده و رقبا با درصدی متفاوت رتبه میگیرند. باور دوم: «تکرار بیشتر مساوی رتبه بهتر». رابطه خطی نیست؛ تکرار بیمورد فقط خوانایی را میکشد و در بدترین حالت متن را به اسپم نزدیک میکند. باور سوم: «یک عدد برای همهٔ صفحات». مقالهٔ دوهزارکلمهای راهنما و توضیح محصول دویستکلمهای دو ریتم متفاوت دارند؛ یک فرمول برای هر دو معنا ندارد.
به تجربهٔ ما وقتی تیم از درصد به پوشش موضوع سوئیچ میکند، متنها روانتر میشوند و صفحات بهتر عمل میکنند، چون انرژی نویسنده از شمارش به پاسخدادن منتقل شده است. همین سوئیچ ساده، بیش از هر ابزاری کیفیت متنهای فنی و فروشگاهی ما را بالا برده است.
keyword stuffing؛ مرز واقعی اسپم
مرز اسپم را گوگل روشن تعریف کرده: پرکردن صفحه با کلمه بهشکلی غیرطبیعی — فهرست شهرها در پاورقی، تکرار عبارت پشت سر هم، متن همرنگ پسزمینه — keyword stuffing است و هدفش دستکاری رتبه است، نه کمک به خواننده (تاریخ گردآوری: آبان ۱۴۰۵). این تعریف به روش تولید و به درصد کاری ندارد؛ به قصد و به تجربهٔ خواننده کار دارد.
آزمون سادهای به تیمها میدهیم: متن را برای یک انسان بلند بخوانید؛ اگر کلمهٔ تکرارشده مکالمه را قطع کند، به مرز نزدیک شدهاید. تکراری که برای خواننده طبیعی است معمولاً برای موتور جستجو هم طبیعی است. به تجربهٔ ما همین آزمون خواندن بلند از هر ابزار درصدی دقیقتر عمل میکند، چون همان چیزی را میسنجد که رتبهبندی اهمیتش را بیشتر میداند: تجربهٔ خواننده.
نمونههایش را در سایتهای فارسی زیاد دیدهایم: پاراگراف افتتاحیه که عبارت هدف ده بار در سه جمله تکرار شده، بلوکهای پایین صفحه با فهرست نام شهرها و محلهها برای هر جستجوی محلی، و توضیح محصولی که اسم خود محصول را در هر جمله میخواند. هیچکدام امروز کمکی به رتبه نمیکند؛ فقط صفحه را ناخواندنی و برند را نامعتبر میکند. اگر به صفحهای با همین الگو برخوردید، بهجای حذف کامل، متن را بازنویسی کنید و عبارتها را فقط در جایگاههای اصلی نگه دارید.
هممعناها؛ پوشش موضوع بدون رقیقکردن کلمه اصلی
هممعناها و واریانتها جای کلمهٔ اصلی را نمیگیرند؛ پوشش موضوع را کامل میکنند. صفحهای که فقط با یک شکل ثابت از عبارت نوشته شده، دیر یا زود در چرخهٔ تکرار گیر میکند. برای فارسی هممعنا راحت در دسترس است: «خرید» و «سفارش»، «قیمت» و «تعرفه»، شکل محاوره و شکل کتابی از یک مفهوم.
قاعدهٔ کاربردی دوطرفه است: کلمه کلیدی اصلی در جایگاههای کلیدی میماند — عنوان، آغاز متن، یک هدینگ — و ادامهٔ متن با هممعناها و واریانتهای طبیعی پیش میرود. نتیجه دو طرفه سود میبرد: خواننده متن یکنواخت نمیبیند و موتور جستجو موضوع را با شبکهٔ کامل واژهها درک میکند.
مراقب دو افراط باشید: هممعنای دور که خواننده رابطه را نمیفهمد، و عوضکردن عبارت اصلی در جایی که کاربر انتظار دقیق دارد — مثل خود عنوان یا پرسشِ اول صفحه. به تجربهٔ ما مسیر پایدارتر، نگهداشتن عبارت در دو سه جایگاه اصلی و آزادگذاشتن بقیهٔ متن است.
یک تمرین ساده برای تیم محتوا: پس از اتمام هر مقاله، فهرست هممعناها و واریانتهایی که طبیعی استفاده شده را کنار هم ببینید. اگر فهرست فقط یک آیتم دارد، احتمالاً متن یکنواخت شده؛ اگر ده آیتم دارد، احتمالاً از عبارت اصلی دور افتادهاید. به تجربهٔ ما سه تا پنج شکل طبیعی از عبارت و خانوادهٔ آن، تعادل درست متن فارسی است؛ نه یک شکل و نه ده شکل.
چهار قاعدهٔ چیدمان طبیعی کلمه کلیدی
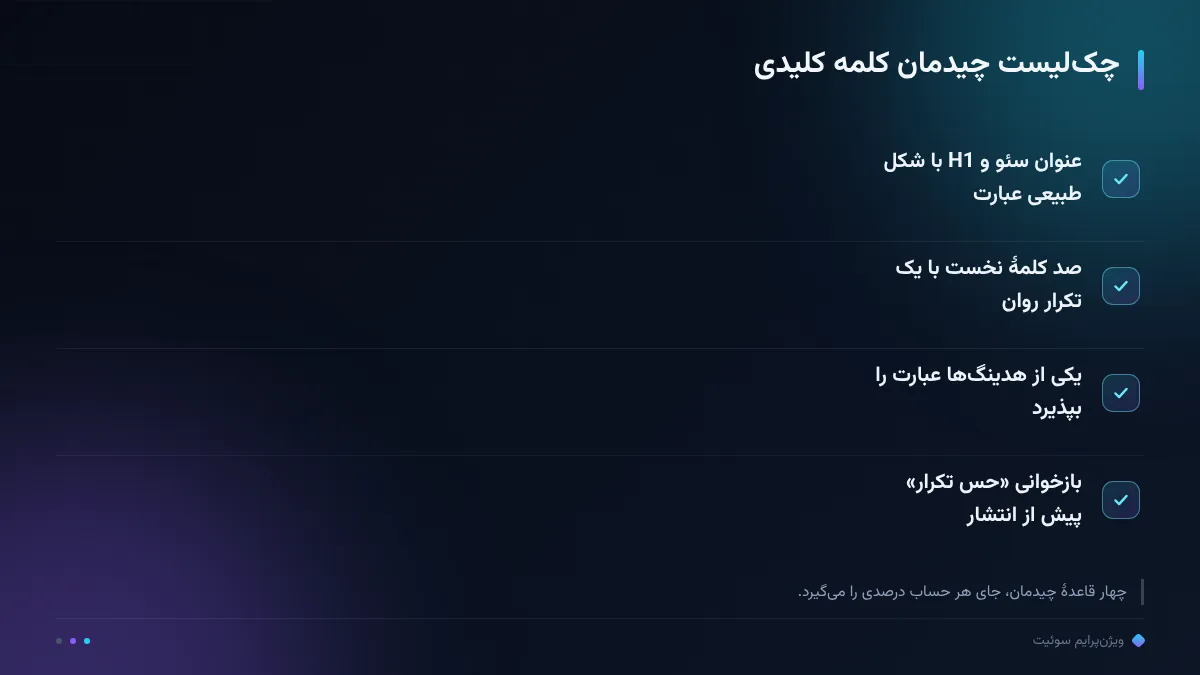
چهار قاعدهای که بهجای درصد اجرا میکنیم: قاعدهٔ یک، یک شکل طبیعی از عبارت در عنوان سئو و H1، نزدیک به آغاز. قاعدهٔ دو، صد کلمهٔ نخست متن عبارت را یکبار بهشکل روان داشته باشد. قاعدهٔ سه، یکی از هدینگها عبارت را طبیعی بپذیرد؛ بقیهٔ هدینگها پرسشهای واقعی کاربرند. قاعدهٔ چهار، پس از اتمام متن فقط یک دور بازخوانی برای «حس تکرار»: اگر جایی جمله برای عبارت خم شده، همانجا با هممعنا یا حذف صافش کنید.
این چهار قاعده در چکلیست انتشار ما هم همانجاست؛ برای دیدن کل مسیر نوشتن از تحقیق تا انتشار، آموزش گامبهگام نوشتن مقالهٔ سئوشده را کنار همین صفحه بگذارید و برای بازبینی نهایی، چکلیست پیش از انتشار را اجرا کنید. هیچکدام از این قواعد درصد نمیخواهد؛ به چیدمان و ریتم نگاه میکند.
جمعبندی؛ سه کار روی متن بعدی
سه کار روی متن بعدیتان: نخست، درصد را از چکلیست خط بزنید و جای آن «پوشش پرسشهای واقعی کاربر» را بنویسید؛ دوم، چیدمان چهارقاعدهای را اجرا کنید — عنوان، صد کلمهٔ اول، یک هدینگ، بازخوانی حس تکرار؛ سوم، متنهای قدیمی را با آزمون خواندن بلند چک کنید و تکرارهای فهرستوار را صاف کنید. افسانهٔ دههٔ ۲۰۱۰ با همین سه کار همین امروز تمام میشود؛ جای آن را پاسخی میگیرد که هم خواننده و هم رتبهبندی پاداشش میدهند.
سفارش پک محتوای سئو
پک محتوا — ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله (اشتراکی ۱۵٪ کمتر)
سفارش پک محتوای سئورصد ما، رشد شما.
سؤالات پرتکرار
درصد درست تکرار کلمه کلیدی چند است؟
هیچ عدد رسمی وجود ندارد؛ گوگل هرگز آستانهٔ درصدی اعلام نکرده است (تاریخ گردآوری: آبان ۱۴۰۵). معیار درست پوشش کامل پرسش کاربر و طبیعیبودن ریتم متن است، نه شمارش درصد.
تکرار کلمه کلیدی کی اسپم حساب میشود؟
وقتی چیدمان غیرطبیعی و فهرستوار شود — تکرار در پاورقی، فهرست کلمهها، متن همرنگ پسزمینه — همان keyword stuffing است؛ تشخیصدهندهٔ اصلی هم قصد است: کمک به خواننده یا دستکاری رتبه.
فرق «تراکم» و «چگالی» کلمه کلیدی چیست؟
دو نام برای یک مفهوماند و فرق فقط در زاویهٔ نگاه است؛ مقالهٔ چرا چگالی کلمه کلیدی بهتنهایی نتیجه نمیدهد فرمول و علتهای نتیجهندادن تکرار را جداگانه باز کرده است.
هممعناها رتبهٔ کلمهٔ اصلی را میگیرند؟
نه؛ هممعنا پوشش موضوع را کامل میکند. کلمهٔ اصلی در جایگاههای کلیدی — عنوان، آغاز متن، یک هدینگ — میماند و ادامهٔ متن با واریانتهای طبیعی پیش میرود.
برای نوشتن مقاله با چیدمان درست کلمه کلیدی، کدام خدمت سوئیت مناسب است؟
پک محتوای سئو؛ سه بازهٔ ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله (اشتراکی ۱۵٪ کمتر) و هر مقاله از گیت کیفیت سیمرحلهای و بازبینی انسانی میگذرد.