آموزش گامبهگام: کلمات کلیدی رقبا را کشف کنیم
- کلمات کلیدی رقبا چیست و چه چیزی نیست؟
- رقیب واژگانی را جدا کنید؛ نتایج جستجو رقیب شما را میسازد
- آموزش گامبهگام کشف در شش قدم
- دستهبندی بر پایهٔ نیت؛ چهار سبد اصلی
- اولویتبندی با تلاش و اثر؛ ماتریس کشفمحور
- از کلمه به صفحه؛ نگاشت بدون همخواری
- چهار خطای رایج و ریتم بازبینی
- جمعبندی؛ فهرست واژگان، دارایی زندهٔ تحقیق
وقتی تیمی برای اولینبار فهرست کلمههای یک رقیب را میبیند، دو واکنش رایج دارد: یا کل فهرست را «باید همه را داشته باشیم» تلقی میکند و برای هیچکدام عمق نمیسازد، یا از فاصلهٔ اعتبار میترسد و حتی کلمههای بردنی را هم رها میکند. هر دو واکنش از یک سوءتفاهم میآید: فهرست رقیب، پاسخ نیست؛ ورودی تصمیم است. همین ورودی، وقتی با نیت جستجو و ظرفیت خودتان خوانده شود، از یک جدول خام به صف اجرا تبدیل میشود.
این راهنما همین تبدیل را تمرین میکند: اول مرزهای «کشف کلمات رقیب» را روشن میکنیم، بعد روش ششقدمی برداشت واژگان را اجرا میکنیم و در آخر، خروجی را به تصمیم و صفحه وصل میکنیم.
کلمات کلیدی رقبا چیست و چه چیزی نیست؟
کلمات کلیدی رقبا مجموعه عبارتهایی است که دامنههای برترِ حوزهٔ شما با آنها در نتایج جستجو دیده میشوند و ترافیک مرتبط را جذب میکنند. دو منبع برای کشف آن وجود دارد: ابزارهای تحقیق کلمه که برآوردی از «کلمههایی که یک دامنه برایشان رتبه دارد» میسازند، و خواندن مستقیم صفحات نتایج که واژگان واقعی عنوانها، تیترها و ساختار صفحههای برتر را نشان میدهد. هر دو منبع مفیدند؛ ولی وزنشان یکی نیست.
دو مرز صادقانه را همین اول بکشیم. مرز اول: هیچ ابزاری فهرست قطعی کلمههای یک دامنه نمیدهد؛ خروجی ابزار برآوردی از پایگاه دادهٔ خودش است و برای بازار فارسی معمولاً پوشش و حجم تقریبی دارد. مرز دوم: فهرست رقیب جای تحقیق مستقل شما را نمیگیرد؛ رقیب ممکن است روی کلمههایی رتبه داشته باشد که اصلاً به خدمت شما مربوط نیست یا برای قصد شما سودآور نیست. پس این فهرست را «فرضیهٔ قابل آزمون» ببینید، نه «پاسخنامه»؛ آزمونگریش هم دادهٔ واقعی سایت خودتان است.
رقیب واژگانی را جدا کنید؛ نتایج جستجو رقیب شما را میسازد
قبل از برداشت هر کلمهای، «رقیب» را تعریف کنید. رقیب کسبوکاری آن فروشندهای است که مشتری مشترک دارید؛ رقیب واژگانی هر دامنهای است که برای عبارتهای هدف شما بالای صفحهٔ اول میایستد — رسانهها، انجمنها، فهرستراهنماها و حتی دامنههایی که اصلاً فروشنده نیستند. برای هر خوشهٔ خدمت، رقیبهای واژگانی میتوانند کاملاً متفاوت باشند؛ پس یک لیست سراسری نسازید و برای هر عبارت بذری، برندههای همان صفحهٔ نتایج را ثبت کنید.
روش عملی ساده است: پنج تا هفت عبارت بذری انتخاب کنید، در حالت ناشناس جستجو کنید و دامنههایی که در دو عبارت یا بیشتر تکرار میشوند را بهعنوان هستهٔ فهرست رقیب برگزینید. همین انتخاب، وسعت کار را از «کل اینترنت» به چند دامنهٔ قابل تحلیل میرساند. اگر دامنهٔ غولپیکری هم در صفحات اول بود، آن را جدا نگه دارید؛ از آن فقط الگوبرداری میکنید، رقابت مستقیم با آن تعریف نمیشود.
این لایه با تحلیل محتوای رقبا همپوشان است ولی همان کار نیست. در آموزش گامبهگام تحلیل محتوای رقبا پوشش موضوعی و زاویهٔ محتوایی رقیب کاویده میشود؛ آنجا میپرسیم رقیب دربارهٔ چه مینویسد و با چه زاویهای. اینجا همان رقبا را از زاویهٔ واژگان میخوانیم: با چه کلمههایی پیدا میشوند و کدام قصدها را رها کردهاند. دو تمرین روی یک میدان، دو لایهٔ مکمل تصمیم میسازند.
آموزش گامبهگام کشف در شش قدم
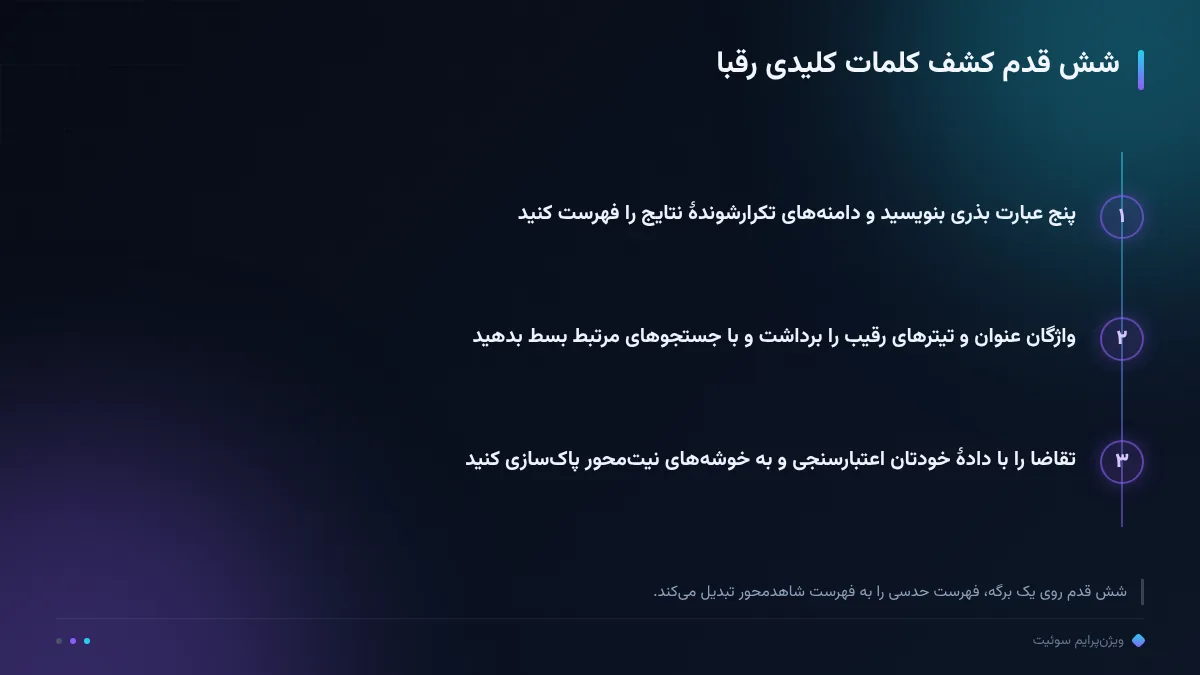
قدم اول، عبارتهای بذری است: پنج عبارت از خدمات پولساز خودتان، نه کلمههای عمومی و سرِسرهای. قدم دوم، فهرست دامنههای تکرارشونده در نتایج ناشناس همان پنج عبارت است؛ تکرار یعنی رقیب واقعی. قدم سوم، برداشت واژگان است: از عنوانها، تیترهای داخلی، نام دستهها و متن لینکهای داخلی صفحههای برتر، عبارتهایی را بیرون بکشید که قصد جستجو را نشان میدهند — نه صرفاً کلمههای کلیدیمانند.
قدم چهارم، بسط است: پیشنهادهای جستجو، عبارتهای مرتبط پای صفحهٔ نتایج و پرسشهای پرتکرار کاربران، خانوادهٔ هر عبارت را کامل میکنند؛ اینجا معمولاً حفرههای زبان محلی پیدا میشود، چون کاربر با همان کلماتی میپرسد که در گزارشهای کلاسیک کمرنگاند. قدم پنجم، اعتبارسنجی است: عبارتهای منتخب را با دادهٔ خودتان در سرچکنسول بسنجید — نمایش، کلیک و نرخ کلیک فعلی، هرچه هست — و برای عبارتهایی که هیچ دادهای ندارید، کوچکترین نسخهٔ صفحه را بسازید و رفتار واقعی را ببینید. قدم ششم، پاکسازی است: همخانوادههای نزدیک را به یک خوشه ببرید تا فهرست نهایی قابل صفبندی باشد، نه فهرست بلندی از همنامها.
دو نکتهٔ اجرایی قدمها را محکمتر میکند. اول، برداشت را با تاریخ و دامنهٔ منبع مستند کنید؛ نتایج جستجو زنده است و بدون تاریخ، ماه بعد نمیدانید چه چیزی عوض شده. دوم، از قضاوت حین جمعآوری پرهیز کنید؛ در فاز برداشت فقط جمع کنید و در فاز دستهبندی قضاوت کنید، چون مخلوطکردن این دو فاز همانجایی است که فهرستها ناقص میشوند.
دستهبندی بر پایهٔ نیت؛ چهار سبد اصلی
فهرست خام بدون نیت، فقط حجم است. هر عبارت کشفشده را در یکی از چهار سبد بنشانید: سبد تراکنشی که کاربر آمادهٔ اقدام است و واژههایی مثل «قیمت»، «خرید» یا «نوبت» میخواهد؛ سبد بررسی و مقایسه که کاربر بین گزینهها مردد است و «بهترین»، «مقایسه» یا نام رقبا را میجوید؛ سبد اطلاعاتی که پرسش و آموزش است و اعتبار میسازد؛ و سبد محلی که خدمت را به شهر یا محله میبندد. جدول زیر نشانهها و صفحهٔ مناسب هر سبد را جمع میکند:
| سبد نیت | نشانههای رایج در عبارت | صفحهٔ مناسب در سایت شما |
|---|---|---|
| تراکنشی | قیمت، خرید، نوبت، استعلام | صفحهٔ خدمت یا محصول با مسیر اقدام روشن |
| بررسی و مقایسه | بهترین، مقایسه، تفاوت، نظر | مقالهٔ مقایسهای صادقانه با معیار مکتوب |
| اطلاعاتی | چگونه، چیست، آموزش، راهنما | راهنمای آموزشی با لینک به صفحهٔ خدمت |
| محلی | نام شهر، محله، نزدیک من | صفحهٔ محلهمحور یا پروفایل نقشه |
نشانهها لزوماً قطعی نیستند؛ صفحهٔ نتایج همان عبارت، داور نهایی سبد است.
قاعدهٔ کنار جدول مهم است: سبد را از خود عبارت و از شکل صفحهٔ نتایج بخوانید، نه از سلیقه. اگر برای عبارتی، صفحهٔ نتایج پر از فروشگاه است، نیت تراکنشی است هرچند کلمهٔ «خرید» در عبارت نباشد. این خواندن شکل نتایج، همان مهارتی است که در تحلیل محتوای رقبا تمرین میشود و اینجا فقط به سطح کلمه فشرده شده است.
اولویتبندی با تلاش و اثر؛ ماتریس کشفمحور
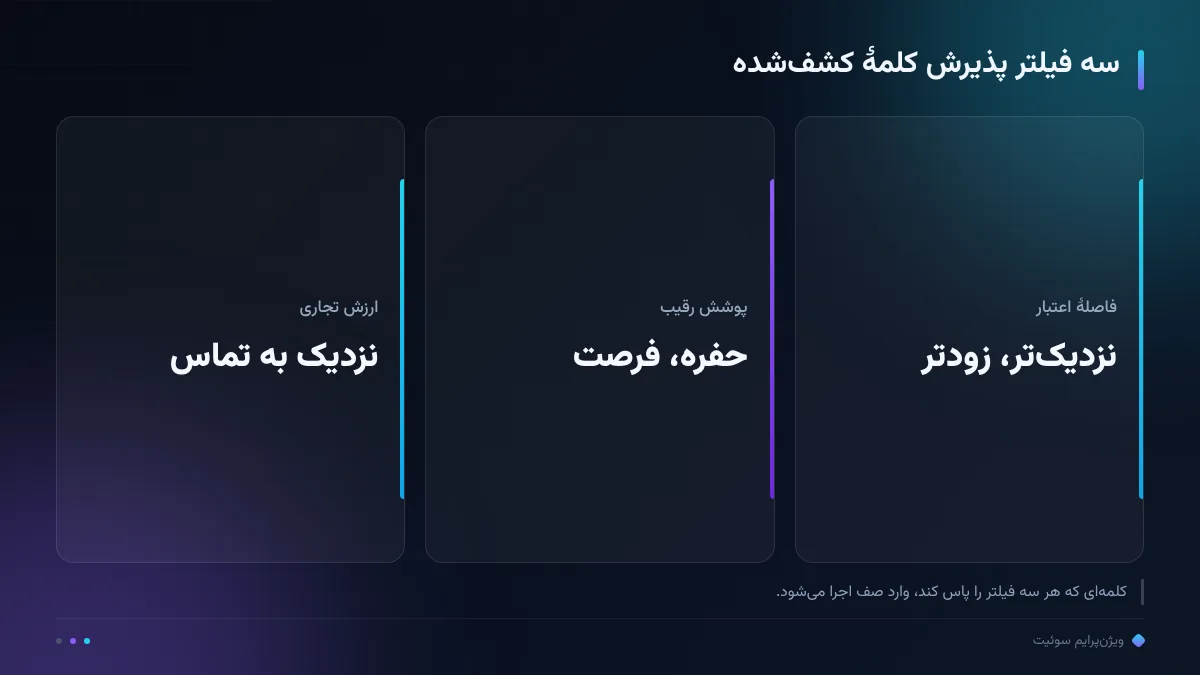
خروجی کشف، فهرست بلندی است که همهٔ آن بهموقع ارزشمند نیست؛ صفبندی ضرورت دارد. چارچوب عمومی این کار را در چارچوب عمومی اولویتبندی کلمات کلیدی نوشتهایم؛ تفاوت اینجا ورودی فهرست است: کلمههایی که از رقیب آمدهاند، با دو سنجهٔ اضافه. سنجهٔ اول، اشباع پوشش رقیب است: اگر رقیب برای همان نیت، صفحهٔ کامل و تازه دارد، هزینهٔ برتری بالا میرود؛ اگر پوششاش ناقص، قدیمی یا بینیت است، حفرهای باز است و اولویت میگیرد.
سنجهٔ دوم، فاصلهٔ اعتبار است: اگر قویترین رقیبِ همان عبارت چند پله از دامنهٔ شما جلوتر است، آن کلمه پروژهٔ میانمدت است، نه اینماهه. این دو سنجه را با ارزش تجاری هر سبد نیت ترکیب کنید و کلمهها را در ماتریس تلاش-اثر بنشانید: تلاش کم و اثر بالا، صف اول اجرا؛ تلاش بالا و اثر بالا، برنامهٔ فصل؛ بقیه، صف انتظار. به تجربهٔ ما کلمهای که حفرهٔ پوشش دارد و به صفحهٔ پولساز شما نزدیک است، تقریباً همیشه از کلمهٔ پرجستجوی اشباعشده زودتر جواب میدهد.
از کلمه به صفحه؛ نگاشت بدون همخواری
فهرست اولویتدار تا وقتی به صفحه وصل نشود، کاغذ است. قاعدهٔ ساده اما سختگیرانه: هر نیت، یک صفحه. اگر دو عبارت از دو خوشهٔ متفاوت به یک صفحه بروند، هیچکدام پتانسیل کاملشان را نشان نمیدهند؛ و اگر یک عبارت به دو صفحه نشت کند، صفحات شما رقیب خودتان میشوند. قواعد کامل این کار در قواعد نگاشت کلمه کلیدی به صفحه آمده است؛ اینجا فقط سه چک سریع را تکرار میکنیم.
چک اول، تازگی: قبل از ساختن صفحهٔ جدید، ببینید صفحهٔ موجودی پوشش همان نیت را نمیدهد؛ بهروزرسانی، معمولاً ارزانتر از ساخت است. چک دوم، مقصد: صفحهای که میسازید باید قصد عبارت را کامل جواب بدهد؛ صفحهٔ نیت بررسی، مقایسه میخواهد نه فقط قیمت. چک سوم، مسیر داخلی: هر صفحهٔ جدید به صفحهٔ پولساز نزدیک شود و از آن لینک بگیرد؛ کلمهٔ کشفشده از رقیب، بدون معماری داخلی، ترافیک بیمقصد میشود. این سه چک را قبل از هر انتشار تکرار کنید تا فهرست کشف، همیشه به ساختار سایت چسبیده بماند و هیچ کلمهای بیخانه نماند.
چهار خطای رایج و ریتم بازبینی
چهار خطا این تمرین را بیاثر میکند. خطای اول، کپی کورکورانه است: برداشتن عنوان رقیب بدون خواندن نیت و بدون تناسب با خدمت شما؛ نتیجه، صفحهای است که نه صداقت دارد و نه تبدیل. خطای دوم، نادیدهگرفتن سبد نیت است: ساختن ده مقالهٔ اطلاعاتی وقتی قصدهای تراکنشی خالیاند. خطای سوم، اعتماد به عدد تکمنبع است: حجم تقریبی یک ابزار، بدون اعتبارسنجی با دادهٔ خودتان. خطای چهارم، فهرست ایستا است: فایلی که سالانه یکبار باز میشود و تغییرهای فصلی بازار را نمیبیند و کمکم از واقعیت فاصله میگیرد.
ریتم پیشنهادی ما ساده است: فهرست کشف را هر فصل یکبار باز کنید، تغییرهای صفحات نتایج را ثبت کنید و صف اجرا را بهروز کنید؛ نیمساعت کاری است و جابهجاییهای مهم را پیش از افت ترافیک نشان میدهد. اگر جابهجایی بزرگی دیدید — برند جدیدی وارد شده یا رقیبی صفحاتش را بازسازی کرده — همان فصل، لایهٔ محتوایی رقیب را هم کامل بخوانید تا الگوی صفحهاش را هم ببینید.
جمعبندی؛ فهرست واژگان، دارایی زندهٔ تحقیق
کشف کلمات کلیدی رقبا یک تمرین ششقدمی زنده است: عبارت بذری، فهرست رقیبِ نتایج، برداشت واژگان، بسط، اعتبارسنجی و خوشهبندی؛ بعد دستهبندی بر پایهٔ نیت، اولویتبندی با تلاش و اثر و نگاشت هر نیت به یک صفحه. خروجیاش نه «کپی کلمات رقیب»، که فهرستی شاهدمحور از حفرهها و قصدهاست که هر فصل تازه میشود. اگر میخواهید همین تحلیل از دید ساختار کل دامنهٔ شما شروع شود، ممیزی رایگان دامنه نقطهٔ کمریسک ورود است و ابزارهای اجرای آن در قابلیتهای پلتفرم معرفی شدهاند؛ زمین بازیِ مشترک همهٔ قدمها هم در هاب تحقیق کلمه کلیدی جمع شده است.
یک یادآوری آخر برای ماندگاری این تمرین: به تجربهٔ ما تیمهایی که فهرست کشف را مستند و تاریخدار نگه میدارند، هر فصل دقیقتر از فصل قبل منتشر میکنند؛ چون هر تصمیم تازه روی دادهٔ فصل قبل مینشیند و حدس، از گردش کار حذف میشود. همین مستندسازی کوچک، تفاوت فهرست زنده و فایل بایگانیشده است.
رصد ما، رشد شما.
سؤالات پرتکرار
آیا ابزارها فهرست کامل کلمات کلیدی رقبا را میدهند؟
خیر؛ خروجی ابزار برآوردی از پایگاه دادهٔ خودش است و برای فارسی پوشش و حجم تقریبی دارد. ترکیب خواندن صفحهٔ نتایج با اعتبارسنجی دادهٔ خودتان در سرچکنسول، تصویر قابل اتکاتری میسازد.
هر کلمهای که رقیب رتبه دارد، فرصت است؟
خیر؛ سه فیلتر را پاس کنید: تناسب با خدمت و نیت شما، فاصلهٔ اعتبار رقیب با دامنهٔ شما و اشباع پوشش. کلمهٔ بیتناسب یا اشباعشده، ترافیک بیتبدیل میسازد.
از هر رقیب چند عبارت برداریم؟
به تجربهٔ ما برای هر رقیب هستهای، حدود ده تا بیست عبارت نیتدار کافی است؛ فهرست طولانیتر معمولاً همخانوادههای تکراری است که بعد از خوشهبندی جمع میشوند.
این کار چه فرقی با تحلیل محتوای رقبا دارد؟
تحلیل محتوا، پوشش موضوعی و زاویهٔ رقیب را میکاود؛ کشف کلمات، واژگان جستجو و قصدهای رهاشده را. دو تمرین مکملاند و هر دو روی همان فهرست رقیب اجرا میشوند.