آموزش گامبهگام نقشهٔ سایت XML؛ از ساخت تا ثبت و پایش
در معماری سایت دو نقشه از یک ساختمان وجود دارد: نقشهٔ انسانی که با لینک داخلی کشیده میشود و کاربر با آن راهش را پیدا میکند، و نقشهٔ ماشینی که فایل XML است و ربات خزش با آن آدرسها را کشف میکند. این دو مکمل هماند، نه جایگزین هم؛ نقشهٔ XML لینک داخلی ضعیف را جبران نمیکند و لینک داخلی هم خطای نقشه را مخفی نمیکند. زمینهٔ این دو لایه در هاب لینکسازی داخلی و معماری نوشته شده است؛ این آموزش، لایهٔ ماشینی را از صفر تا ثبت و پایش میبندد.
یک لایهبندی صادقانه: قواعد سلامت محتوای نقشه و نگهداری بلندمدت آن را در آموزش نقشهٔ سایت XML سالم نوشتهایم؛ اینجا سراغ اجرای اولیه میرویم — از فهرست صفحات شایسته تا نقشهای که ثبت شده، معرفی شده و پایش میشود. اگر سایت تازه راه افتاده یا تازه مهاجرت کرده است، همین مسیر نقطهٔ شروع درست شماست.
نقشهٔ ماشینی سایت چه کاری برای موتور جستجو میکند؟
نقشهٔ ماشینی سه کار انجام میدهد. اول، کشف: آدرسهایی که به هر دلیل لینک داخلی کمی دارند یا تازه منتشر شدهاند، از مسیر نقشه زودتر به دست ربات میرسند. دوم، تازگی: اگر تولیدکنندهٔ نقشه، تاریخ واقعی انتشار و بهروزرسانی را گزارش کند، موتور جستجو متوجه میشود کدام صفحه تازه شده است. سوم، نظم نسخهها: وقتی هر آدرس فقط با نسخهٔ نهایی و canonical خودش در نقشه باشد، سیگنالهای متناقض بین نسخههای پارامتری و تمیز کم میشود.
و بگویم چه کاری نمیکند، چون همینجا اغلب انتظارها کج بسته میشود: نقشه اهرم رتبه نیست و صفحهٔ بیکیفیت را ایندکسپذیر نمیکند؛ جای خزشپذیری را هم نمیگیرد و اگر سرور صفحات را بد پاسخ بدهد، فهرست کاملترین نقشه هم کمکی نمیکند. به تجربهٔ ما نقشه، صفحهٔ کملینک را فقط «کشفشدنی» میکند، نه «معتبر»؛ اعتبار همان مسیر همیشگی را میرود: محتوا، لینک داخلی و سیگنالهای بیرونی.
آموزش گامبهگام نقشه سایت XML در هفت قدم
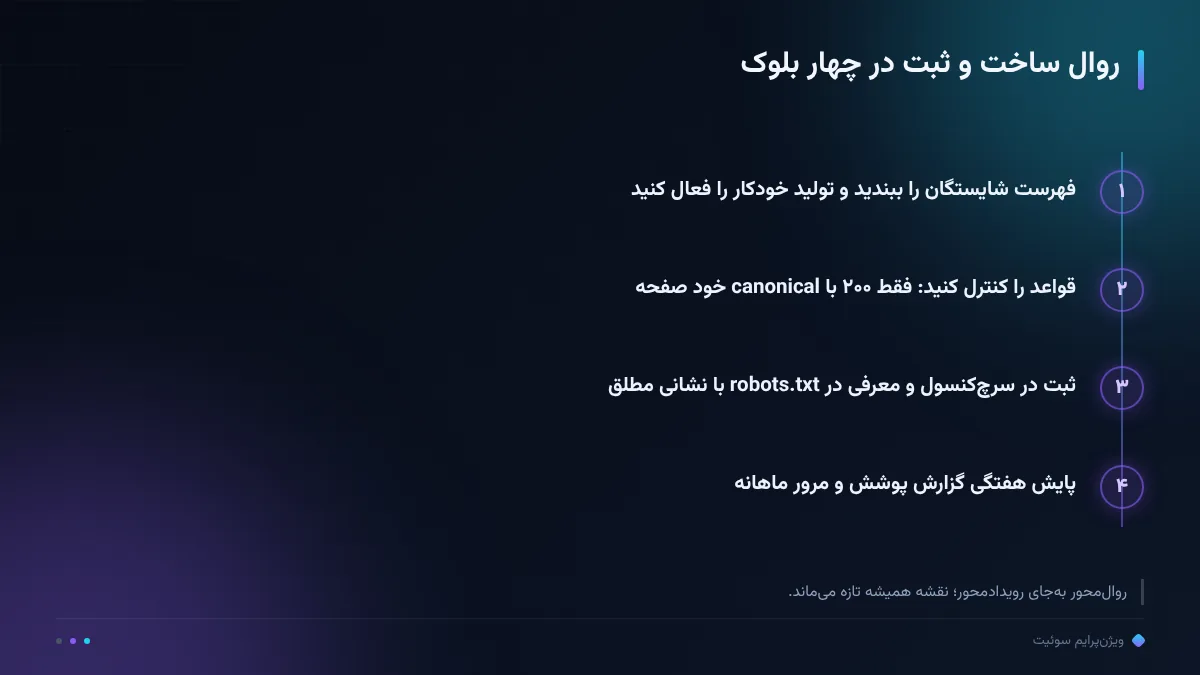
قدم اول، فهرست شایستگان را ببندید: هر آدرسی که ایندکسش را نمیخواهید — برگههای تگ بیمصرف، نتایج جستجوی داخلی، نسخههای چاپی — از همین حالا بیرون قاعده بگذارید. قدم دوم، تولید خودکار را فعال کنید؛ در وردپرس افزونهٔ سئو این کار را میکند و در سوئیت، نقشه با هر انتشار خودش تازه میشود؛ نقشهٔ دستی و ثابت، همانجایی است که کهنه میشود و به خطا میرسد. قدم سوم، قواعد محتوا را کنترل کنید: فقط صفحههای ۲۰۰ با پاسخ سالم، فقط نسخهٔ نهایی با canonical خودش، بدون noindex و بدون ریدایرکت.
قدم چهارم، نقشه را در سرچکنسول ثبت کنید تا وضعیتش را بخوانید. قدم پنجم، یک خط Sitemap در robots.txt اضافه کنید — با نشانی مطلق، نه نسبی؛ جزئیاتش را در بخش robots همین مقاله میبینید. قدم ششم، گزارش پوشش را هفتگی بخوانید و سه الگوی آن را با نقشه جفت بزنید. قدم هفتم، مرور ماهانه را تقویم ببندید: صفحات حذفشده، ریدایرکتهای جدید و خطاهای تولیدکننده همانجا لو میروند. هفت قدم را یکبار بچینید؛ بعد فقط روال نگه دارید.
ثبت در سرچکنسول و خواندن گزارش پوشش
ثبت در سرچکنسول کار سختی نیست: در بخش نقشههای سایت، نشانی کامل فایل را بدهید و وضعیت خواندنش را ببینید؛ خطاها معمولاً همان اول معلوم میشوند — فرمت نادرست، نشانی ناقص یا سروری که پاسخ ۵۰۰ میدهد. بعد از ثبت، گزارش پوشش ایندکس را کنار نقشه بخوانید؛ جفتخوانیِ «چه چیزی در نقشه است» و «چه چیزی واقعاً ایندکس شده» دقیقترین تصویر سلامت کشف سایت را میسازد و در گزارش پوشش ایندکس تکتک حالتهایش باز شده است.
سه الگوی خواندن کافی است. صفحاتی که «کشف نشدهاند» یعنی یا نقشه کهنه است یا لینک داخلی کم؛ هر دو را صاف کنید. خطای خزش یعنی سرور یا آدرس مشکل دارد، نه نقشه؛ اول سرعت پاسخ را ببینید. اخراجشدههای noindex یعنی قواعد تولیدکننده و قواعد صفحه همخوان نیستند؛ یکی را انتخاب و بقیه را بیرون بگذارید. برای صفحههای مهم و تازه، درخواست ایندکس دستی سرچکنسول میانبر خوبی است؛ ولی تکیهٔ همیشگی روی آن نگذارید.
سه قاعدهٔ رسمی robots.txt برای معرفی نقشه
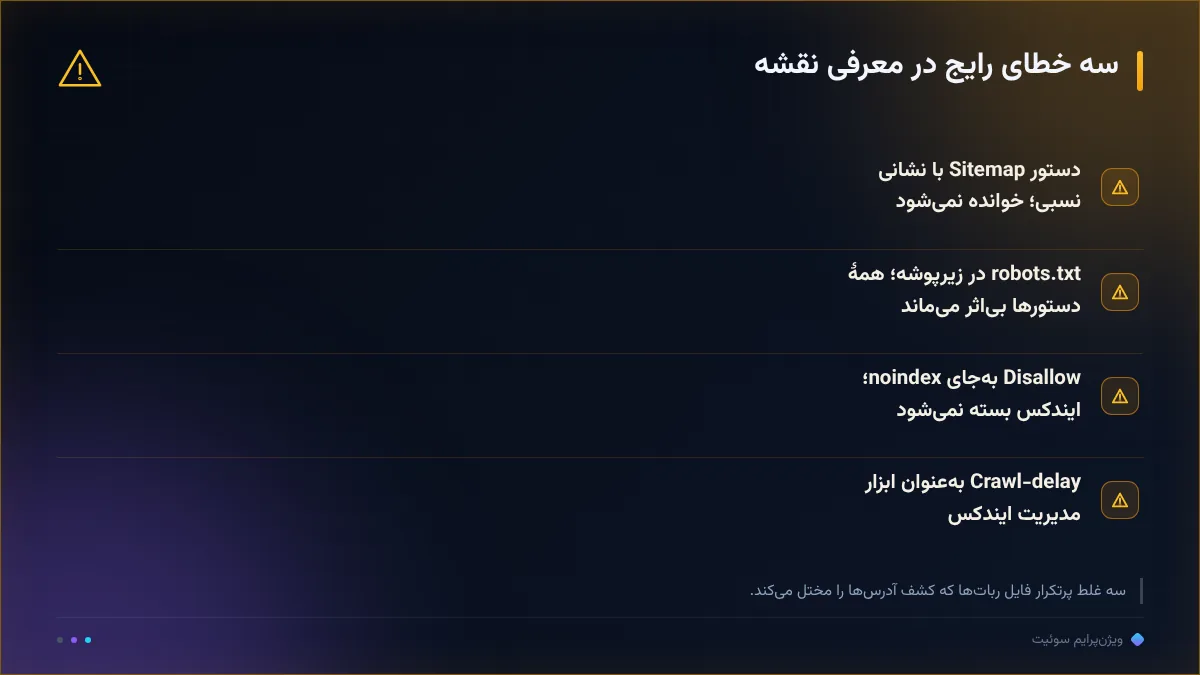
مستندات رسمی Google Search Central (تاریخ گردآوری: آبان ۱۴۰۵) سه قاعده را روشن کرده است. اول اینکه فایل robots.txt باید در ریشهٔ دامنه بماند؛ فایلی که در زیرپوشه باشد خوانده نمیشود و همهٔ دستورهایش بیاثر میماند. دوم اینکه دستور Sitemap به نشانی مطلق نیاز دارد؛ نشانی نسبی یا ناقص، بهعنوان معرفی نقشه خوانده نمیشود. سوم — و پرخطاترینِ همه — Disallow فقط خزش را میبندد، نه ایندکس را؛ صفحهای که از robots.txt بیرون مانده ولی لینک از بیرون دارد، میتواند بدون محتوا در نتایج ظاهر شود. برای بستن ایندکس، noindex روی خود صفحه باید عمل کند، نه Disallow در فایل رباتها. گوگل Crawl-delay را هم نادیده میگیرد؛ تنظیم آن برای کاهش بار سرور معنا دارد، نه برای مدیریت ایندکس.
نتیجهٔ عملی این سه قاعده: خط Sitemap در robots.txt کارش «کشف برای همهٔ رباتها» است و جایگزین ثبت در سرچکنسول نمیشود؛ ثبت، مرجع پایش شما میماند. اگر شروع میکنید، ساختار فایل و خطاهای رایجترش را در آموزش robots.txt درست نوشتهایم؛ آنجا جدول دستورها و نمونهٔ فایل سالم هم هست.
نقشه در معماری سایت؛ رابطه با لینکسازی داخلی
نقشه، لایهٔ ماشینی معماری است؛ اگر معماری کج باشد، نقشه فقط کجی را با دقت ثبت میکند. برای همین قبل از تولید نقشه، ساختار را صاف کنید: هر صفحه یک هدف، هر خوشه یک ستون و مسیر کلیک از خانه تا صفحههای عمیق کوتاه. به تجربهٔ ما سایتی که معماریاش مرتب است، نقشهاش هم تقریباً بیخطا درمیآید؛ چون تولیدکننده از همان ساختار منظم تغذیه میشود، نه از انبوهی از آدرسهای تکراری و پارامتری.
قاعدهٔ تقسیم کار را ساده ببندید: لینک داخلی برای «معرفی و اعتبار»، نقشه برای «کشف و تازگی»، سرچکنسول برای «پایش». صفحهای که در هیچ کدام از این سه لایه ظاهر نمیشود، عملاً در سایت وجود ندارد؛ ولی صفحهای که فقط در نقشه هست و در هیچ لینکی نیست، فقط کشف میشود و وزن نمیگیرد. روی همین دو خط، اولویتبندی بهبودها روشن میشود: اول معماری و لینک، بعد نقشه و پایش.
خطاهای پرتکرار و درمانشان
خطاهای نقشه معمولاً از تولیدکننده میآیند، نه از گوگل؛ چهار نشانهٔ رایج و اقدام هرکدام را جدول زیر جمع میکند:
| نشانه | علت رایج | اقدام |
|---|---|---|
| آدرس ۴۰۴ یا ریدایرکت داخل نقشه | نقشهٔ ثابت و دستی | تولید خودکار را فعال و نقشه را دوباره ثبت کنید |
| صفحهٔ noindex داخل نقشه | همخوان نبودن قواعد افزونهها | قاعدهٔ «فقط ایندکسپذیر» را در تولیدکننده ببندید |
| نقشه با نشانی نسبی در robots.txt | خط دستی ناقص | نشانی مطلق کامل با پروتکل بنویسید |
| تاریخهای تکراری روی همهٔ ردیفها | تولیدکننده بدون lastmod واقعی | تاریخ واقعی انتشار و بهروزرسانی را پاس بدهید |
هر نشانه را در گزارش پوشش سرچکنسول و در خود فایل نقشه همزمان چک کنید؛ منبع خطا تقریباً همیشه سمت تولید است.
درمانها سریعاند؛ نکتهٔ اصلی این است که بعد از اصلاح، نقشه را دوباره ثبت کنید و یک چرخهٔ هفتگی پایش ببندید تا برگشت خطا همان هفته دیده شود. خطاهایی که ماهها میمانند، معمولاً خطای ابزار نیستند؛ نشانهٔ نبودِ روالاند.
جمعبندی؛ نقشه را روال کنید، نه رویداد
جمعبندی آموزش: فهرست شایستگان را ببندید، تولید خودکار را روشن کنید، قواعد «فقط ۲۰۰ با canonical خود» را اعمال کنید، در سرچکنسول ثبت کنید، در robots.txt با نشانی مطلق معرفی کنید، هفتگی گزارش پوشش را بخوانید و ماهی یکبار مرور انسانی بگذارید. سه قاعدهٔ robots — ریشهٔ دامنه، نشانی مطلق، Disallow فقط خزش را میبندد — را هم جایی دائمی یادداشت کنید؛ چون بیشترِ «نقشه خراب است»ها در واقع «فایل رباتها خراب است».
نقطهٔ شروع کمریسک برای دیدن وضعیت فعلی سایت، ممیزی رایگان دامنه است؛ وضعیت کشف و ایندکس، همان اول تصویر میشود. اگر میخواهید تولید و ثبت نقشه بخشی از روال انتشار سایتتان باشد، قابلیتهای پلتفرم را ببینید؛ نقشه با هر انتشار خودش تازه میشود و پایشش کنار گزارشهای سایت میماند.
رصد ما، رشد شما.
سؤالات پرتکرار
نقشه سایت XML خودش رتبه میسازد؟
نه؛ نقشه ابزار کشف و تازگی است، نه اهرم رتبه. اثر واقعیاش وقتی دیده میشود که با لینکسازی داخلی منظم و گزارش پوشش جفت شود و خطاهای تولید آدرس زود لو بروند.
صفحههای noindex یا ریدایرکتشده را هم در نقشه بگذاریم؟
نه؛ نقشه فهرست آدرسهای شایستهٔ ایندکس است. آدرس noindex یا ۳۰۱ داخل نقشه سیگنال متناقض میسازد و گزارش پوشش را کدر میکند.
ثبت در سرچکنسول کافی است یا خط robots.txt هم لازم است؟
ثبت در سرچکنسول مرجع پایش شماست؛ خط Sitemap در robots.txt با نشانی مطلق، کشف را برای رباتهای دیگر هم آسان میکند. فقط نشانی باید مطلق و کامل با پروتکل باشد.
هر چند وقت یکبار نقشه را بهروز کنیم؟
بهروزرسانی باید خودکار و همراه انتشار باشد؛ به تجربهٔ ما مرور انسانی ماهی یکبار کافی است تا صفحات حذفشده، ریدایرکتها و خطاهای تولیدکننده زود پیدا شوند.
سایت کوچک هم به فایل نقشه نیاز دارد؟
بله؛ حتی یک فایل کوچک و ساده کشف را تازه نگه میدارد و خطاها را زود نشان میدهد. در سایتهای بزرگ، نقشههای موضوعی و تقسیمی کنترل را سادهتر میکنند.