چکلیست معیار کیفیت محتوای AI؛ ۱۴ مورد قبل از انتشار
- معیار کیفیت محتوای AI دقیقاً چه چیزی را اندازه میگیرد؟
- چهارده سنجه در یک نگاه؛ هر سنجه با آزمون خودش
- صحت ادعاها؛ عدد، نام و نقلقول زیر ذرهبین
- لحن برند؛ تبدیل ذائقه به سنجهٔ قابل چک کردن
- یکتایی و ساختار؛ مرز با کپی و با صفحات خودی
- خوانایی فارسی؛ جمله، بند و یکدستی نویسهها
- سه خطای رایج سنجش و سه حکم پایانی
مرز این متن با دو مقالهٔ همخوشه روشن باشد. رُبریک نمرهدهی معیار کیفیت محتوای AI رُبریک نمرهدهی را میسازد: چهار گروه معیار، وزندهی و آستانهٔ پذیرش — جوابِ «چطور نمره بدهیم». این مقاله جوابِ «چه چیزی را با چه آزمونی چک کنیم» است: چهارده سنجهٔ عینی، هر کدام دوحالته. اول سنجهها، بعد نمره؛ بدون سنجهٔ عینی، هر رُبریکی به سلیقه برمیگردد.
مرز دوم با چکلیست گیت کیفیت و نقش بازبین انسانی: آن مقاله فرایند گیت را تعریف میکند — چند مرحله، کدام نقش، چه کسی امضا میزند — و این متن وسایل آزمایشِ همان فرایند است. سنجهها هم بهتر است قبل از تولید ثبت شده باشند؛ قالب قالب بریف محتوای خودکار پیش از تولید دقیقاً همین قرارداد پیش از تولید است. سنجهای که در بریف نباشد موقع بازبینی دعوا میشود؛ سنجهای که از اول نوشته شده فقط تیک میخواهد.
معیار کیفیت محتوای AI دقیقاً چه چیزی را اندازه میگیرد؟
معیار کیفیت محتوای AI را باید به چیزی شکاند که دو بازبینِ مستقل از آن یک نتیجه میگیرند؛ وگرنه نامش معیار نیست، سلیقه است. پنج لایه این قابلیت را دارند: صحت ادعاها، لحن برند، یکتایی، ساختار و خوانایی فارسی. به تجربهٔ ما خطاهای متن تولیدی تقریباً همیشه در همین پنج لایه ظاهر میشود، چون تولید خودکار روی «شبیه بودن به متن خوب» بهینه میشود، نه روی «درست بودن».
تفکیک سنجه از ذائقه با یک مثال روشن میشود. «روان بودن» سنجه نیست؛ دو بازبین دو حکم میدهند. «میانگین جملهها زیر آستانهٔ تعریفشده و بندها بیش از چهار خط نباشد» سنجه است؛ آزمونش تکرارپذیر است و خروجی دوحالته. همین تبدیل، بازخورد به تولید را قابل اجرا میکند.
قاعدهٔ اجرا هم از همینجا میآید: هر سنجه یا تیک میخورد یا علتِ نخوردن با ارجاع به جملهٔ مشکلدار مکتوب میشود. پاسخهایی مثل «به نظر خوب است» ارزش عملیاتی ندارند؛ چیزی که ثبت نشود، در تولید بعدی با همان شکل و همان خطا تکرار میشود.
چهارده سنجه در یک نگاه؛ هر سنجه با آزمون خودش
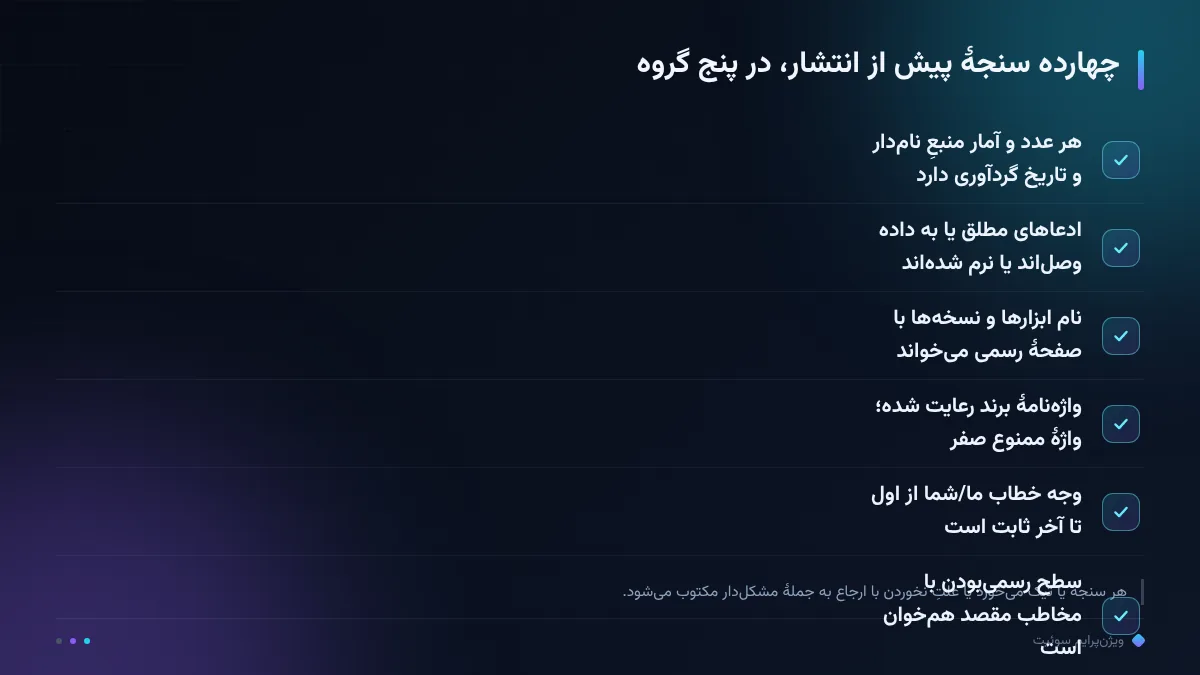
چهارده سنجه در پنج گروه، به همان ترتیبی که اجرا میشوند: سه سنجهٔ صحت ادعاها اول میآیند چون گرانترین خطاها را میگیرند؛ بعد سه سنجهٔ لحن برند، سه سنجهٔ یکتایی، سه سنجهٔ ساختار و در پایان دو سنجهٔ خوانایی. فهرست کامل مقالههای این حوزه را هم در هاب محتوای هوش مصنوعی با گیت کیفیت مرتب نگه داشتهایم؛ این متن همان زیرمجموعهای است که پیش از دکمهٔ انتشار، روی پیشنویسِ آماده اجرا میشود.
منطق دوحالته بودن را در چکلیست زیر ببینید: هیچ سنجهای «نیمهقبول» ندارد. نسخهٔ چکلیست تاریخ و شماره میگیرد تا پروندهٔ بازبینیهای قبلی قابل ردیابی بماند؛ در جوابِ «چرا این متن منتشر شد»، همین ثبت تنها سند شماست.
این سنجهها مخصوص متنِ تولیدشده با ابزار نیستند؛ برای محتوای نویسندهٔ انسانی هم هماناند و فقط توزیع خطا فرق میکند: به تجربهٔ ما در متن انسانی گروه لحن و خوانایی بیشتر پرچم میدهد و در متن تولیدشده با ابزار، گروه صحت و یکتایی. چکلیست را مستقل از سازندهٔ متن اجرا کنید؛ تیک سازنده کافی نیست، امضا با بازبین بیطرف است.
صحت ادعاها؛ عدد، نام و نقلقول زیر ذرهبین
گروه صحت سه آزمون دارد. اول، خطکشی اعداد: هر عدد، درصد و بازه زیر خط کشیده میشود و کنارش منبعِ نامدار و تاریخ گردآوری نوشته میشود؛ عددِ بیمنبع یا منبع میگیرد یا حذف. دوم، جستجوی عبارتهای مطلق مثل «همیشه» و «هیچوقت» و «بهترین»: هر کدام یا به داده وصل است یا نرم میشود. سوم، تطبیق نامها: نام ابزارها و نسخهها با صفحهٔ رسمی چک میشود، چون اشتباه در نسخه اعتماد کل متن را میسوزاند.
به تجربهٔ ما بیشترین پرچمهای گیت در همین گروه بالا میآیند، چون متن تولیدشده با ابزار لحنِ مطمئن را حتی بدون منبع هم مینویسد؛ بازبینِ گروه صحت دقت اطلاعات و لحنِ قطعیت را با هم میسنجد و پاسخ هر پرچم را با جملهٔ مشکلدار ثبت میکند.
جمع عملی: برای یک مقالهٔ استاندارد، این سه آزمون کمتر از بیست دقیقه وقت میبرد و بیشترین سهم ریسک انتشار را کم میکند؛ همین نسبت است که گروه صحت را اول ترتیب اجرا میگذارد.
لحن برند؛ تبدیل ذائقه به سنجهٔ قابل چک کردن
لحن برند وقتی سنجه میشود که در سه سند مکتوب جمع شده باشد: واژهنامهٔ برند با واژههای ترجیحی و ممنوع، قاعدهٔ وجه خطاب (ما با شما) و سطح فنی مخاطب. آزمونها با همین سه سند اجرا میشود: جستجوی واژههای ممنوع، نمونهبرداری از ابتدا و انتهای متن برای ثابت بودن وجه خطاب، و خوانش بلند دو پاراگراف اول.
تفاوت این نگاه با «بوی خوب متن» در تکرارپذیری است: دو بازبینِ مستقل به یک حکم میرسند و بازخورد قابل اجراست. «جملهٔ ششم واژهٔ ممنوع دارد» را تولید در دو دقیقه اصلاح میکند؛ «لحنش خوب نیست» را هیچکس نمیداند با آن چه کند. همین تفاوت است که بازبینی لحن را از جلسهٔ نظردانی به آزمون تکرارپذیر تبدیل میکند.
یک مرز صادقانه: لحن سختترین گروه برای خودکارسازیِ سنجش است و بازبینی انسانی را کامل حذف نمیکند. نقش انسان در گیت را در مقالهٔ گیت کیفیت باز کردهایم؛ جمعش همان است: ابزار پرچم میدهد، انسان امضا میکند.
یکتایی و ساختار؛ مرز با کپی و با صفحات خودی
یکتایی سه آزمون چنددقیقهای دارد. اول، جستجوی عین جملههای شاخص داخل گیومه در موتور جستجو: اگر جملهٔ امضادار متن جایی تکرار شده، یا کپی است یا قالبی که هزار جا نوشته شده. دوم، مقایسهٔ ترتیب بحث با منابع الهام: ساختار یکی نباشد؛ بازآفرینی یعنی همان موضوع با نقشهٔ خودتان، نه ترجمهٔ سند دیگر. سوم، چک نقشهٔ خوشه: کلمهٔ هدف و اینتنت این صفحه باید جای خالی داشته باشد، نه صندلی اشغالِ صفحهٔ قبلی خودتان.
ساختار هم سه سنجه دارد: توالی سرفصلها بدون پرش؛ نگاشت هر بخش به وعدهای مشخص در بریف — بخش بیوعده حذف میشود، چون فقط طول اضافه میکند؛ و سلامت لینکهای داخلی به صفحات همخوشه، که هم مسیر خواننده است و هم سیگنال معماری.
ارزش این دو گروه را با شاهد بگوییم: در یک کیس ثبتشدهٔ سوئیت، ۱۰ محتوای ساختیافته و منظمِ فروشگاه liuna در ۳ ماه به ۲۸۶ صفحهٔ اول رسید — با این اعتراف صادقانه که آن تیم «فروشگاه بود نه آژانس» و مسیر را با خطا و اصلاح طی کرد. این عدد برای دامنهٔ دیگر وعده نمیشود؛ فقط میگوید یکتایی و ساختار سقفِ قابل انتظار را جابهجا میکنند. گزارش پرونده در شواهد و مطالعات موردی سوئیت است.
خوانایی فارسی؛ جمله، بند و یکدستی نویسهها
دو سنجهٔ خوانایی ارزانترین اجرا را دارند. سنجهٔ طول: میانگین جملهها کوتاه، بندها بیش از چهار خط نه و هر بند یک کار انجام دهد؛ آزمونش نمونهبرداری از سه جای متن است. سنجهٔ یکدستی نویسهها: نیمفاصلهها درست، گیومهٔ فارسی و ارقام یکدست در کل متن؛ آزمونش جستجوی الگوها با ویرایشگر است و در دو دقیقه تمام میشود؛ ارزانیِ اجرا بهانهٔ رد کردن سنجه نیست.
فارسی حساستر است، چون کپیکردن متن بین ابزارها «ی» و «ک» و نیمفاصله را بیصدا خراب میکند؛ متنی که در ابزار تولید سالم دیده میشود، بعد از رفتوبرگشت بین ویرایشگرها ممکن است یکدستیاش را از دست بدهد. به همین دلیل چکِ نهایی روی متنِ داخل سیستم انتشار اجرا میشود، نه روی پیشنویسِ ابزار تولید.
خوانایی را با دقت اشتباه نگیرید: جملهٔ کوتاهِ غلط هنوز غلط است. گروه خوانایی درِ آخر است، نه معیار اصلی؛ اگر برای روانتر شدن بازنویسی میکنید، بعد از چک صحت انجام شود.
سه خطای رایج سنجش و سه حکم پایانی
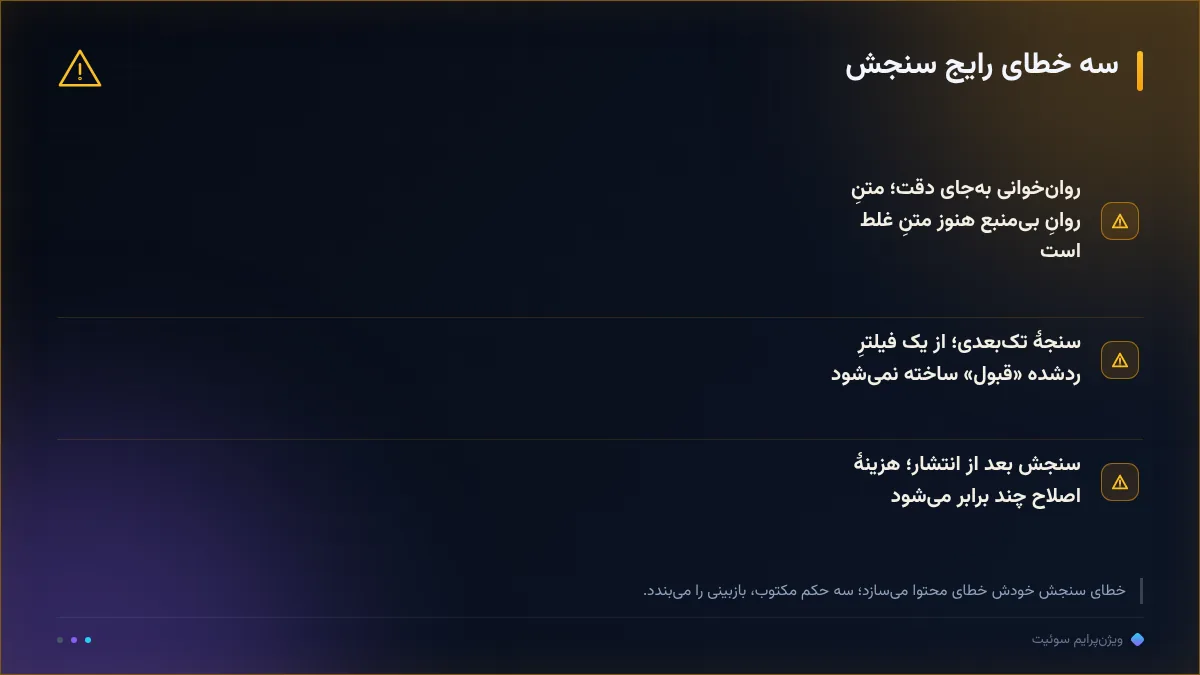
سه خطای رایج سنجش را با نام ببندید. خطای اول، روانخوانی بهجای دقت: متنی که میچرخد اما اعدادش منبع ندارد؛ روانبودنِ متنِ غلط فقط غلطِ قابلخواندن میسازد. خطای دوم، سنجهٔ تکبعدی: فقط آزمون شباهت یا فقط نیمفاصله؛ از متنی که فقط یک فیلتر رد کرده، «قبول» ساخته نمیشود. خطای سوم، سنجش بعد از انتشار؛ هزینهٔ اصلاح چند برابر است.
حکمها سهتایی و مکتوباند: تیک کامل یعنی انتشار با امضای بازبین؛ نخوردنِ سنجههای ساختار و خوانایی یعنی بازنویسی بخشی با موعد مشخص؛ نخوردنِ گروه صحت یا یکتایی یعنی رد و تولید مجدد. هیچ حکمی تلفنی و بدون نام بازبین قبول نیست؛ همین ثبت چرخهٔ بازخورد را میبندد.
اگر نمیدانید محتوای فعلی سایتتان نسبت به این چهارده سنجه کجا ایستاده، ممیزی رایگان دامنه اولین تصویر واقعی را میدهد؛ سفارش تولید بعدی را بر پایهٔ گزارش ببندید، نه حدس. تولید منظم را هم اگر جدی میگیرید، فراخوان پایین مدل پک را با قیمت شفاف نشان میدهد.
سفارش پک محتوای سئو
پک محتوا — ۴۴۰/۳۹۰/۳۴۵ هزار تومان برای هر مقاله (اشتراکی ۱۵٪ کمتر)
سفارش پک محتوای سئورصد ما، رشد شما.
سؤالات پرتکرار
چهارده سنجه را با چه ترتیبی اجرا کنیم؟
به ترتیب گروهها، از صحت تا خوانایی؛ سنجههای صحت اول چک میشوند چون گرانترین خطاها را میگیرند. هر سنجه یا تیک میخورد یا علتِ نخوردنش با ارجاع به جملهٔ مشکلدار مکتوب میشود.
این چکلیست چه فرقی با رُبریک نمرهدهی دارد؟
رُبریک میگوید چطور نمره بدهیم و آستانهٔ پذیرش کجاست؛ این متن چهارده آزمون عینی میدهد که خروجی هر کدام دوحالته است. دو متن مکملاند: اول سنجهها، بعد نمره و آستانه.
این سنجهها برای محتوای نویسندهٔ انسانی هم کاربرد دارد؟
بله؛ تفاوت در توزیع خطاست نه در جنس سنجهها. به تجربهٔ ما برای متن انسانی گروه لحن و خوانایی بیشتر پرچم میدهد و برای متن تولیدشده با ابزار، گروه صحت و یکتایی.
اگر چند سنجه نخورد، پیشنویس را منتشر کنیم؟
نیمتیک یعنی حکم بازنویسی یا رد. خطای ساختار و خوانایی با ویرایش بخشی اصلاح میشود؛ خطای صحت یا یکتایی معمولاً یعنی تولید مجدد. انتشار با سنجههای نخورده هزینهاش بعداً چند برابر برمیگردد.
بازبینی کامل چهارده سنجه چقدر وقت میگیرد؟
برای یک مقالهٔ استاندارد، به تجربهٔ ما حدود یک ساعت کار بازبین؛ بیشترِ آزمونها چنددقیقهایاند و سهم اصلی زمان با گروه صحت و یکتایی است. همان یک ساعت، ارزانترین ساعات کل چرخهٔ تولید است.